SQL bilen biri için MongoDB'ye geçişin en kısa yolu terimleri eşleştirmektir: tablo koleksiyona, satır belgeye (BSON belgesi), sütun alana karşılık gelir; SELECT sorguları find() ile, GROUP BY ve benzeri toplama işleri aggregation pipeline ile, JOIN ise $lookup veya gömülü belgelerle yapılır. Birincil anahtar her belgede otomatik olarak _id alanıdır.
Bu yazı, MongoDB resmî belgelerindeki SQL eşleme tablolarını Türkçe açıklamalarla ve kendi örneklerimizle bir araya getiriyor: şema komutları, INSERT, SELECT, UPDATE, DELETE ve aggregation karşılıkları. İlişkisel ve NoSQL veritabanlarının genel karşılaştırması burada değil, veritabanı türleri rehberinde ele alınıyor; SQL'in kendisini tanımak için SQL nedir yazısına bakabilirsiniz.
Terim karşılıkları
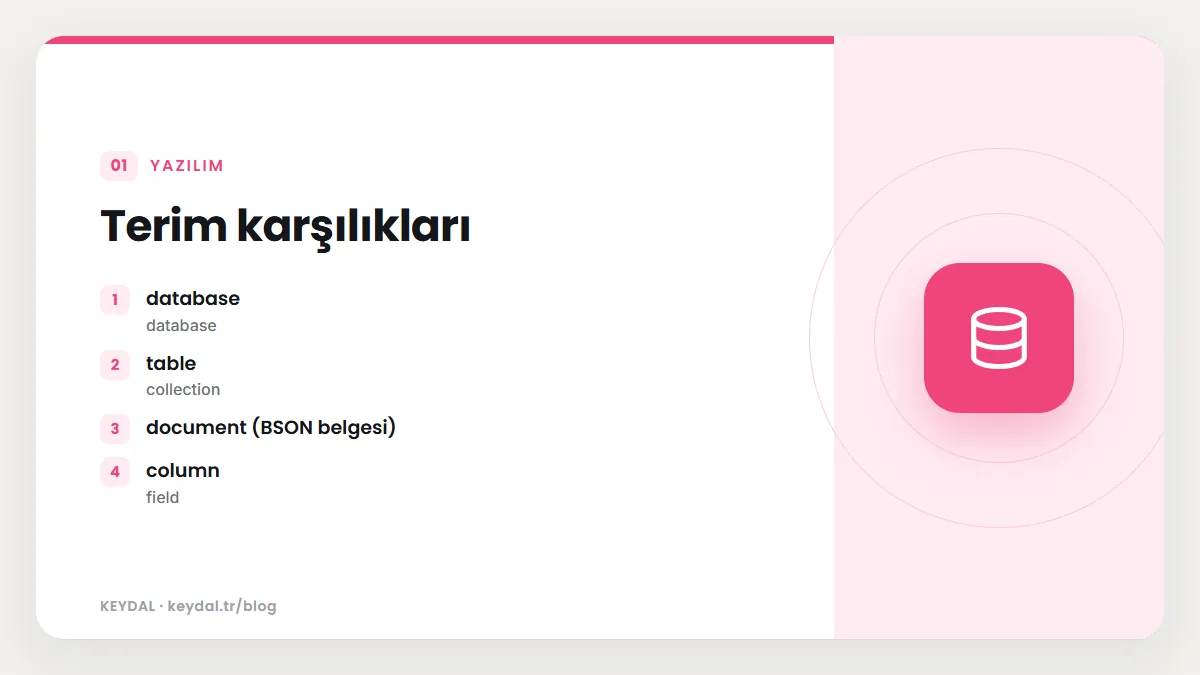
| SQL | MongoDB |
|---|---|
| database | database |
| table | collection |
| row | document (BSON belgesi) |
| column | field |
| index | index |
| table joins | $lookup veya gömülü belgeler |
| primary key | _id alanı (otomatik) |
| GROUP BY gibi toplama | aggregation pipeline |
| SELECT INTO NEW_TABLE | $out |
| MERGE INTO TABLE | $merge |
| UNION ALL | $unionWith |
| transactions | transactions (çoğu durumda gömülü model ile ihtiyaç azalır) |
Son satır önemlidir. Belgeler, birçok senaryoda gömülü belgeler ve diziler kullanan denormalize modelin çok belgeli transaction'lardan daha uygun kalacağını söyler; veriyi doğru modellemek transaction ihtiyacını azaltır. Bu konu veri modelleme yazısında, transaction ayrıntıları transaction yazısında anlatılıyor.
Programlar da benzer şekilde eşleşir: MySQL tarafındaki mysqld sunucusunun karşılığı mongod, mysql istemcisinin karşılığı mongosh kabuğudur. Kabuğun kullanımı için mongosh yazısına bakın.
Örneklerde kullanılan belge
Belgelerdeki tablo, people adlı bir SQL tablosu ile aynı adlı bir koleksiyonu karşılaştırır. Biz de benzer şekilde kisiler koleksiyonunu kullanacağız; belgeler şu biçimde:
{
  _id: ObjectId("509a8fb2f3f4948bd2f983a0"),
  kullanici_id: "abc123",
  yas: 55,
  durum: "A"
}
CREATE ve ALTER: şema komutları
MongoDB'de koleksiyon, ilk insertOne() veya insertMany() çağrısında kendiliğinden oluşur; _id verilmemişse otomatik eklenir. İsterseniz db.createCollection("kisiler") ile açıkça da oluşturabilirsiniz (ayrıntılar koleksiyon oluşturma yazısında).
CREATE TABLE kisiler (
    id MEDIUMINT NOT NULL AUTO_INCREMENT,
    kullanici_id VARCHAR(30),
    yas NUMBER,
    durum CHAR(1),
    PRIMARY KEY (id)
);
ALTER TABLE kisiler ADD katilim_tarihi DATETIME;
ALTER TABLE kisiler DROP COLUMN katilim_tarihi;
CREATE INDEX idx_kullanici ON kisiler(kullanici_id);
CREATE INDEX idx_kullanici_yas ON kisiler(kullanici_id, yas DESC);
DROP TABLE kisiler;db.kisiler.insertOne( { kullanici_id: "abc123", yas: 55, durum: "A" } ) // koleksiyon burada oluşur
db.kisiler.updateMany( { }, { $set: { katilim_tarihi: new Date() } } ) // ADD COLUMN karşılığı
db.kisiler.updateMany( { }, { $unset: { katilim_tarihi: "" } } ) // DROP COLUMN karşılığı
db.kisiler.createIndex( { kullanici_id: 1 } )
db.kisiler.createIndex( { kullanici_id: 1, yas: -1 } )
db.kisiler.drop()Buradaki en büyük zihinsel fark ALTER TABLE satırlarındadır. Belgelere göre koleksiyonlar belgelerinin yapısını tanımlamaz ve zorlamaz; koleksiyon düzeyinde yapısal bir değişiklik yoktur. Yeni bir "sütun" eklemek aslında belgelere $set ile alan yazmak, kaldırmak ise $unset ile alanı silmektir. Yapıyı yine de zorlamak isterseniz schema validation kullanırsınız. İndeksteki -1, SQL'deki DESC karşılığıdır.
Şema değişikliği neden farklı işler?
MongoDB veri modelleme sayfası iki yaklaşımı yan yana koyar. İlişkisel veritabanında bir tablonun şemasını veri eklemeden önce belirlemeniz gerekir; şemayı sonradan değiştirmek mümkündür ama sabit şema, bağımlı referansların nasıl etkileneceği dahil daha fazla ön planlama ister. Belge veritabanında ise veri modelini uygulamanın ihtiyaçları değiştikçe zamanla değiştirebilirsiniz. Belgelere göre yeni alanlar ve yeni içerik türleri, mevcut belgeleri yeniden yazmadan veya şema göçü çalıştırmadan eklenebilir.
Pratikte bu şu anlama gelir: katilim_tarihi alanını yalnızca yeni kayıtlara yazmaya başlayabilir, eski belgeleri olduğu gibi bırakabilirsiniz. O zaman sorgularınız alanın bazı belgelerde hiç olmayabileceğini hesaba katmalıdır; örneğin $exists ile kontrol etmek veya aggregation'da $ifNull ile varsayılan değer vermek gerekir. Eski belgelerin hepsini aynı biçime getirmek istiyorsanız yukarıdaki updateMany() örneği gibi toplu bir güncelleme çalıştırırsınız.
INSERT
INSERT INTO kisiler (kullanici_id, yas, durum) VALUES ("bcd001", 45, "A");db.kisiler.insertOne( { kullanici_id: "bcd001", yas: 45, durum: "A" } )Toplu ekleme için insertMany() kullanılır. ordered seçeneği ve dönen değer insertOne ve insertMany yazısında anlatılıyor.
SELECT karşılıkları
find() iki argüman alır: birincisi WHERE koşulunu, ikincisi seçilecek alanları (projeksiyon) belirtir. Belgelerin vurguladığı nokta şudur: projeksiyonda açıkça çıkarmadığınız sürece find() her zaman _id alanını döndürür.
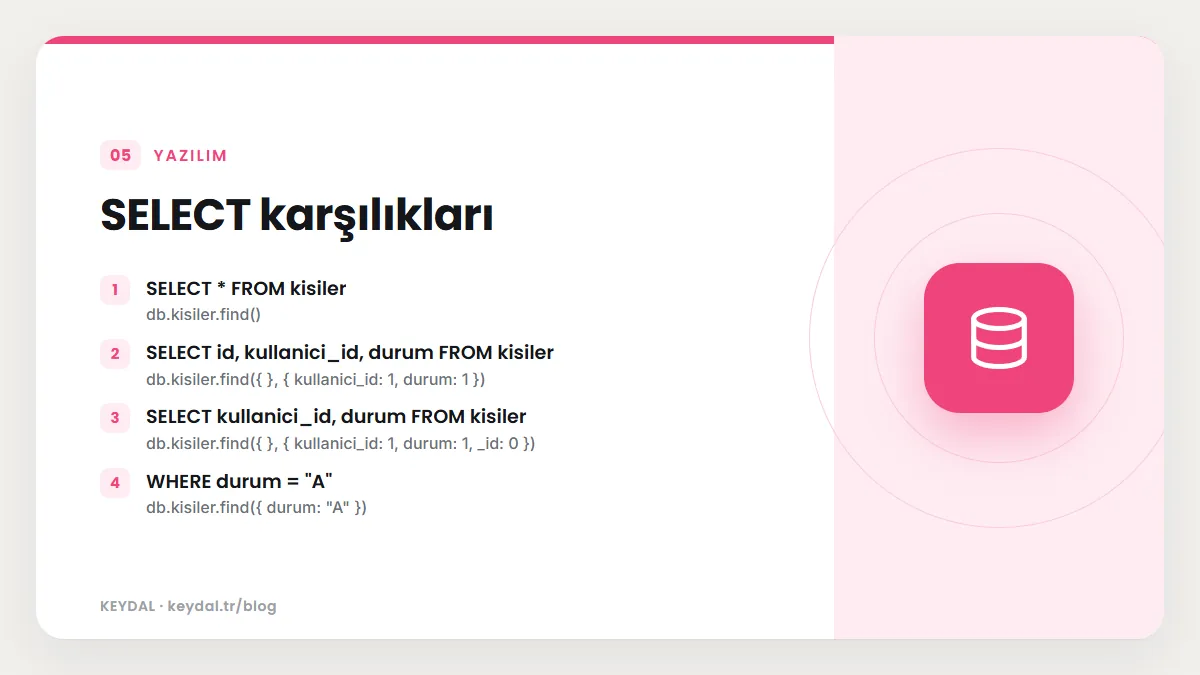
| SQL | MongoDB |
|---|---|
| SELECT * FROM kisiler | db.kisiler.find() |
| SELECT id, kullanici_id, durum FROM kisiler | db.kisiler.find({ }, { kullanici_id: 1, durum: 1 }) |
| SELECT kullanici_id, durum FROM kisiler | db.kisiler.find({ }, { kullanici_id: 1, durum: 1, _id: 0 }) |
| WHERE durum = "A" | db.kisiler.find({ durum: "A" }) |
| WHERE durum != "A" | db.kisiler.find({ durum: { $ne: "A" } }) |
| WHERE durum = "A" AND yas = 50 | db.kisiler.find({ durum: "A", yas: 50 }) |
| WHERE durum = "A" OR yas = 50 | db.kisiler.find({ $or: [ { durum: "A" }, { yas: 50 } ] }) |
| WHERE yas > 25 | db.kisiler.find({ yas: { $gt: 25 } }) |
| WHERE yas > 25 AND yas <= 50 | db.kisiler.find({ yas: { $gt: 25, $lte: 50 } }) |
| WHERE kullanici_id LIKE "%bc%" | db.kisiler.find({ kullanici_id: /bc/ }) |
| WHERE kullanici_id LIKE "bc%" | db.kisiler.find({ kullanici_id: /^bc/ }) |
| ORDER BY kullanici_id DESC | .sort({ kullanici_id: -1 }) |
| SELECT DISTINCT(durum) | db.kisiler.distinct("durum") |
| LIMIT 1 | db.kisiler.findOne() veya .limit(1) |
| LIMIT 5 SKIP 10 | .limit(5).skip(10) |
| EXPLAIN SELECT ... | .explain() |
Tablodaki her satırın arkasında kendi ayrıntıları olan bir konu var: karşılaştırma ve mantık operatörleri sorgu operatörleri yazısında, LIKE karşılığı olan düzenli ifadeler regex sorguları yazısında, sıralama ve sayfalama sort, limit ve skip yazısında anlatılıyor. Aynı alanda iki koşulu ($gt ve $lte) tek bir belge içinde yazdığınıza dikkat edin; bu, SQL'deki AND ile aynı alanı iki kez sınamanın karşılığıdır.
AND için ayrıca operatör yazmanıza gerek yoktur: filtre belgesindeki alanlar örtük olarak birlikte sağlanmalıdır. Belgelerde DISTINCT için bir de aggregation karşılığı verilir: db.kisiler.aggregate([ { $group: { _id: "$durum" } } ]). distinct() yöntemi ise farklı değerlerin listesi BSON boyut sınırını aşmadığı sürece kullanılabilir.
COUNT için hangi yöntem?
Belgelerin SQL tablosunda count() örnekleri bulunur. Ancak db.collection.count() sayfası, MongoDB sürücülerinin count() API'lerini countDocuments() ve estimatedDocumentCount() lehine kullanımdan kaldırdığını belirtir. Yeni kodda şu biçimleri tercih edin:
// SELECT COUNT(*) FROM kisiler WHERE yas > 30
db.kisiler.countDocuments( { yas: { $gt: 30 } } )

// SELECT COUNT(kullanici_id) FROM kisiler  (alanı olan satırlar)
db.kisiler.countDocuments( { kullanici_id: { $exists: true } } )
countDocuments() sorgusunda bazı operatörler kullanılamaz; örneğin $where yerine $expr, $near yerine $center ile $geoWithin önerilir.
UPDATE ve DELETE
UPDATE kisiler SET durum = "C" WHERE yas > 25;
UPDATE kisiler SET yas = yas + 3 WHERE durum = "A";
DELETE FROM kisiler WHERE durum = "D";
DELETE FROM kisiler;db.kisiler.updateMany( { yas: { $gt: 25 } }, { $set: { durum: "C" } } )
db.kisiler.updateMany( { durum: "A" }, { $inc: { yas: 3 } } )
db.kisiler.deleteMany( { durum: "D" } )
db.kisiler.deleteMany( { } )yas = yas + 3 gibi kendine göre artırma için $inc operatörü vardır. Başka bir alandan hesaplanan değer yazmanız gerekiyorsa güncellemeye pipeline verirsiniz; bu yöntem $set aşaması yazısında anlatılıyor. deleteMany({ }) bütün belgeleri siler ama koleksiyonu ve indekslerini bırakır; koleksiyonu tümden kaldırmak drop() ile yapılır. Farklar deleteOne ve deleteMany yazısında ele alınıyor.
Aggregation karşılıkları
| SQL | MongoDB aggregation |
|---|---|
| WHERE | $match |
| GROUP BY | $group |
| HAVING | $group sonrasında $match |
| SELECT | $project |
| ORDER BY | $sort |
| LIMIT | $limit |
| SUM() | $sum |
| COUNT() | $sum veya $sortByCount |
| join | $lookup |
| SELECT INTO NEW_TABLE | $out |
| MERGE INTO TABLE | $merge |
| UNION ALL | $unionWith |
SQL'de cümlenin yazılış sırası ile çalışma sırası farklıdır; aggregation pipeline'da ise aşamalar yazdığınız sırayla çalışır. Bu yüzden HAVING karşılığı ayrı bir anahtar kelime değil, $group aşamasından sonra gelen ikinci bir $match aşamasıdır. Aşağıdaki örneklerde siparisler koleksiyonundaki belgelerin musteri_id, tarih, durum, tutar alanları ve kalemler adlı bir gömülü dizi taşıdığını varsayıyoruz.
SELECT musteri_id, SUM(tutar) AS toplam
FROM siparisler
WHERE durum = 'A'
GROUP BY musteri_id
HAVING toplam > 250
ORDER BY toplam DESC;db.siparisler.aggregate( [
{ $match: { durum: "A" } }, // WHERE
{ $group: { _id: "$musteri_id", toplam: { $sum: "$tutar" } } }, // GROUP BY + SUM
{ $match: { toplam: { $gt: 250 } } }, // HAVING
{ $sort: { toplam: -1 } } // ORDER BY
] )$group aşamasında gruplama anahtarı her zaman _id alanına yazılır; SQL'deki musteri_id sütunu sonuçta _id adıyla görünür. Bütün tabloyu tek grup olarak toplamak (SELECT COUNT(*) ya da SUM(tutar)) için _id: null verilir. Accumulator'ların ayrıntıları $group yazısında.
Birden fazla sütuna göre gruplama
SQL'deki GROUP BY musteri_id, tarih karşılığında _id bir belge olur. Belgelerdeki örnek, tarihin saat kısmını atmak için $dateToString kullanır:
db.siparisler.aggregate( [
   { $group: {
        _id: {
           musteri_id: "$musteri_id",
           gun: { $dateToString: { format: "%Y-%m-%d", date: "$tarih" } }
        },
        toplam: { $sum: "$tutar" }
   } }
] )
Kalem tablosuyla join yerine $unwind
SQL'de sipariş kalemleri genellikle ayrı bir tabloda durur ve JOIN ile toplanır. MongoDB belgelerindeki karşılaştırma ise kalemlerin sipariş belgesine dizi olarak gömüldüğünü varsayar; bu durumda join yerine diziyi $unwind ile açmak yeterlidir:
SELECT musteri_id, SUM(k.adet) AS adet
FROM siparisler s, siparis_kalemleri k
WHERE k.siparis_id = s.id
GROUP BY musteri_id;db.siparisler.aggregate( [
{ $unwind: "$kalemler" },
{ $group: { _id: "$musteri_id", adet: { $sum: "$kalemler.adet" } } }
] )Bu fark, iki dünya arasındaki en öğretici örnektir: aynı soru, verinin nasıl modellendiğine göre ya join ya da dizi açma ile cevaplanır. Kalemler ayrı bir koleksiyondaysa $lookup kullanırsınız.
COUNT DISTINCT ve türetilmiş tablo
SQL'de alt sorgu ile yapılan "farklı müşteri ve gün kombinasyonlarını say" işi, art arda iki $group ile yapılır: ilki kombinasyonları tekilleştirir, ikincisi _id: null ile onları sayar.
db.siparisler.aggregate( [
   { $group: { _id: { musteri_id: "$musteri_id",
                      gun: { $dateToString: { format: "%Y-%m-%d", date: "$tarih" } } } } },
   { $group: { _id: null, sayi: { $sum: 1 } } }
] )
Adım adım çeviri: bir rapor sorgusu
Elinizde şöyle bir istek olduğunu düşünün: "Durumu A olan kişilerden 25 yaşından büyük olanların kullanıcı kimliklerini, yaşa göre azalan sırada, ilk 10 kayıt olarak getir; _id gösterme." SQL'de bunu tek bir SELECT cümlesiyle yazarsınız. MongoDB'de aynı isteği parçalara ayırmak çeviriyi kolaylaştırır:
- WHERE kısmı filtre belgesi olur:
{ durum: "A", yas: { $gt: 25 } }. İki koşul aynı belgede olduğu için örtük olarak AND ile bağlanır. - SELECT listesi projeksiyon olur:
{ kullanici_id: 1, yas: 1, _id: 0 }._idalanını açıkça çıkarmazsanız sonuçta görünür. - ORDER BY yas DESC karşılığı
.sort({ yas: -1 }), LIMIT 10 karşılığı.limit(10)olur.
db.kisiler.find(
   { durum: "A", yas: { $gt: 25 } },
   { kullanici_id: 1, yas: 1, _id: 0 }
).sort( { yas: -1 } ).limit( 10 )
Aynı sorguyu aggregation ile de yazabilirsiniz: $match, $sort, $limit ve son olarak $project. Basit filtre, sıralama ve sınırlama için find() yeterlidir; gruplama, hesaplanmış alan veya join gerektiğinde aggregation pipeline'a geçersiniz. Bu sorgunun indeksle desteklenmesi için eşitlik, sıralama ve aralık alanlarının sırasını anlatan compound index ve ESR kuralı yazısına bakabilirsiniz.
SQL alışkanlıklarını taşırken dikkat edilecekler
- Her tabloyu ayrı koleksiyon yapmak: MongoDB'nin temel ilkesi birlikte okunan veriyi birlikte saklamaktır. Sipariş kalemleri gibi alt kayıtlar çoğu zaman gömülü dizi olarak daha uygundur.
- AUTO_INCREMENT aramak:
_idverilmezse otomatik oluşturulur; ayrı bir artan sayaç tanımlamanız gerekmez. - HAVING'i yanlış yere koymak: grup sonucuna uygulanan filtre
$groupaşamasından sonra gelmelidir; öncesine koyarsanız tek tek belgeleri süzer. - count() kullanmaya devam etmek: yeni kodda
countDocuments()veyaestimatedDocumentCount()kullanın. - Şemasızlığı kuralsızlık sanmak: yapı koleksiyon düzeyinde zorlanmaz ama validation ile zorlanabilir.
- Tırnak alışkanlığı: SQL'de sütun adı yazdığınız yerde aggregation ifadelerinde alan yolu dolar işaretiyle (
"$tutar") yazılır; dolar işareti olmadan yazılan dize sabit değer olarak yorumlanır.
Sık Sorulan Sorular
MongoDB SQL sorgusu çalıştırabilir mi?
Bu yazının dayandığı belgeler SQL ifadelerini yalnızca karşılaştırma amacıyla gösterir; $lookup sayfası da sözde SQL örneklerinin çalıştırılabilir olmadığını açıkça belirtir. Sorgularınızı MongoDB Query Language ve aggregation pipeline ile yazmanız gerekir.
Foreign key karşılığı var mı?
Belgelerdeki terim tablosunda foreign key için bir karşılık verilmez. İlişkiler gömme veya referans alanlarıyla kurulur ve okuma sırasında $lookup ile birleştirilir; referans bütünlüğünü uygulamanız korur. Kalıpların seçimi embedding ve referencing yazısında anlatılıyor.
PostgreSQL veya MySQL yerine MongoDB mi seçmeliyim?
Bu karar verinizin yapısına ve erişim desenlerine bağlıdır. Seçenekleri tanımak için PostgreSQL nedir, MySQL nedir ve MongoDB nedir yazılarını birlikte okuyabilirsiniz.
EXPLAIN çıktısını nasıl okurum?
explain() sonucunda indeks taraması IXSCAN, tam koleksiyon taraması COLLSCAN olarak görünür. Ayrıntılar explain() rehberinde.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: MongoDB öğrenme rehberi · find sorguları · Aggregation pipeline · $lookup ile join · SQL nedir · Veritabanı türleri