MongoDB, verileri tablo satırları yerine belge (document) adı verilen, alan ve değer çiftlerinden oluşan JSON benzeri yapılarda saklayan bir belge veritabanıdır. Belgeler koleksiyonlarda, koleksiyonlar da veritabanlarında durur; bir alanın değeri başka bir belge, dizi ya da belge dizisi olabilir. Yüksek erişilebilirlik için replica set, yatay ölçekleme için sharding sunucunun çekirdek özellikleri arasındadır.
Bu yazıda MongoDB'nin kendisine odaklanıyoruz: belge modelinin kuralları, koleksiyon ve veritabanı ilişkisi, SQL terimlerinin karşılıkları, replikasyon ve sharding'in kabaca nasıl çalıştığı, depolama motoru ve sürüm seçenekleri. İlişkisel ve NoSQL veritabanlarının genel karşılaştırmasını merak ediyorsanız veritabanı türleri rehberine, konuların tamamını sırayla görmek isterseniz MongoDB öğrenme rehberine bakabilirsiniz.
Belge: MongoDB'nin temel veri birimi
MongoDB'de bir kayıt, alan adlarıyla değerlerin eşleştiği bir belgedir. Belge görünüş olarak bir JavaScript nesnesine ya da JSON'a benzer; ancak sunucu bu belgeleri BSON olarak saklar. BSON, JSON belgelerinin ikili (binary) gösterimidir ve JSON'da bulunmayan tarih, 64 bit tam sayı, Decimal128 ve ObjectId gibi ek veri tiplerini içerir. Bu tiplerin ayrıntısı için BSON veri tipleri yazısına bakın.
Aşağıdaki örnek, tek bir müşteri kaydının uygulamanın nesne modeline ne kadar yakın tutulabileceğini gösteriyor. adres alanı gömülü (embedded) bir belge, etiketler bir dizi, siparisler ise belgelerden oluşan bir dizidir:
{
  _id: ObjectId("507f1f77bcf86cd799439011"),
  ad: "Ayşe Yılmaz",
  kayitTarihi: ISODate("2026-01-15T09:30:00Z"),
  adres: { sehir: "İzmir", ilce: "Bornova", postaKodu: "35040" },
  etiketler: [ "kurumsal", "yillik-plan" ],
  siparisler: [
    { no: 1001, tutar: Decimal128("249.90") },
    { no: 1002, tutar: Decimal128("89.00") }
  ]
}
Belgeler bir alanı aynı belge içinde gömülü tutabildiği için, ilişkisel bir şemada üç ayrı tabloya bölünecek bilgi tek bir kayıtta okunabilir. MongoDB belgeleri, belge modelinin avantajlarını şöyle özetler: belgeler pek çok programlama dilindeki yerleşik veri tiplerine karşılık gelir, gömülü belgeler ve diziler pahalı join ihtiyacını azaltır ve dinamik şema aynı koleksiyondaki belgelerin farklı yapılarda olabilmesine (çok biçimlilik) izin verir. Hangi verinin gömüleceği, hangisinin referansla bağlanacağı ayrı bir tasarım kararıdır; bunu veri modelleme yazısında ele alıyoruz.
Belgelerin uyması gereken kurallar
- Boyut sınırı: Tek bir BSON belgesi en fazla 16 mebibayt olabilir. Bu sınır, tek bir belgenin aşırı bellek veya ağ bant genişliği tüketmesini engeller. Daha büyük dosyalar için MongoDB, GridFS API'sini sunar.
_idalanı: Standart bir koleksiyondaki her belgenin, birincil anahtar görevi gören benzersiz bir_idalanı olmalıdır. Belgeyi eklerken_idvermezseniz MongoDB sürücüsü sizin için bir ObjectId üretir._iddeğeri değiştirilemez; dizi, regex veya undefined olamaz.- Alan sırası: JavaScript nesnelerinin aksine BSON belgesindeki alanlar sıralıdır.
_idher zaman ilk alandır; sunucu,_idbaşta değilse onu başa taşır. - Alan adları: Alan adları metindir,
nullkarakteri içeremez ve bir belge içinde benzersiz olmalıdır. Aynı adla iki alan bulunan belgelerde CRUD işlemleri beklenmedik davranabilir. - Nokta (.) ve dolar ($) işaretleri: Sunucu, bu karakterleri içeren alan adlarının saklanmasına izin verir; fakat bazı kısıtlar vardır ve bu tür adlar sorgu yazmayı zorlaştırır.
Alanlara erişirken nokta notasyonu kullanılır. Gömülü belgedeki bir alan için "adres.sehir", dizinin sıfırdan başlayan konumundaki bir öğe için "etiketler.0" yazarsınız. Nokta notasyonu kullanılan alan adları tırnak içinde yazılmalıdır:
db.musteriler.find( { "adres.sehir": "İzmir" } )
db.musteriler.find( { "etiketler.0": "kurumsal" } )
İlk sorgu adresi İzmir olan müşterileri, ikincisi etiketler dizisinin ilk öğesi "kurumsal" olan müşterileri getirir. Sorgu yazımının ayrıntıları için find sorguları ve dizi sorgulama yazılarına bakabilirsiniz.
Veritabanı, koleksiyon ve görünüm
Bir MongoDB sunucusunda birden fazla veritabanı bulunabilir; her veritabanı bir veya daha fazla koleksiyon tutar. Koleksiyonlar, ilişkisel veritabanlarındaki tablolara benzer; ancak katı ve önceden tanımlanmış bir şema dayatmazlar. En çok şaşırtan nokta, veritabanını ve koleksiyonu ayrıca oluşturmak zorunda olmamanızdır: henüz var olmayan bir veritabanına use ile geçip ilk belgeyi yazdığınızda MongoDB hem veritabanını hem koleksiyonu oluşturur.
use magaza
db.urunler.insertOne( { ad: "Klavye", stok: 40 } )
Burada insertOne(), magaza veritabanını ve urunler koleksiyonunu yoksa oluşturur. createIndex() da koleksiyon yoksa onu yaratır. Seçenekleri önceden belirlemek (örneğin doğrulama kuralları) için koleksiyonu açıkça oluşturmanız gerekir; bu konular veritabanı ve koleksiyon oluşturma yazısında anlatılıyor.
Koleksiyonların yanında MongoDB iki yardımcı yapı daha sunar: başka koleksiyonlar üzerinde tanımlanan salt okunur view (görünüm) ve bir aggregation sonucunu diske yazan on-demand materialized view. Aralarındaki farkı $out, $merge ve materialized view yazısı açıklıyor.
SQL terimlerinin MongoDB karşılıkları
İlişkisel bir veritabanından geliyorsanız kavramları eşleştirmek işinizi hızlandırır. MongoDB'nin resmî eşleştirme tablosunun temel satırları şöyledir:
| SQL kavramı | MongoDB karşılığı | Not |
|---|---|---|
| database | database | Aynı ad kullanılır |
| table | collection | Şema dayatmaz |
| row | document (BSON belgesi) | İç içe yapı içerebilir |
| column | field | Belgeden belgeye değişebilir |
| index | index | Gömülü alanlar ve diziler de indekslenebilir |
| table joins | $lookup veya gömülü belgeler | Çoğu zaman gömme tercih edilir |
| primary key | _id alanı | Otomatik olarak birincil anahtardır |
| GROUP BY gibi toplama | aggregation pipeline | $group aşaması |
| transactions | transactions | Çok belgeli ACID desteklenir |
| mysqld gibi sunucu | mongod | Veritabanı süreci |
| mysql gibi istemci | mongosh | Etkileşimli kabuk |
Sorgu düzeyindeki karşılıklar (SELECT, WHERE, GROUP BY örnekleri) MongoDB ve SQL karşılaştırma yazısında ayrıntılı olarak yer alıyor. SQL'in kendisini tanımak isterseniz SQL nedir, ilişkisel bir sunucu ile kıyaslamak isterseniz PostgreSQL nedir ve MySQL nedir yazılarına göz atabilirsiniz.
Sorgu API'si, indeksler ve transaction
MongoDB Query API; ekleme, okuma, güncelleme ve silme (CRUD) işlemlerinin yanında veri toplama (aggregation), metin arama ve coğrafi (geospatial) sorguları kapsar. Sunucuya gönderdiğiniz filtreler birer belgedir; örneğin { stok: { $lt: 10 } } stoğu 10'dan az olan ürünleri seçer. Operatörlerin listesi sorgu operatörleri yazısında, çok aşamalı veri işleme ise aggregation pipeline yazısında anlatılıyor.
Performans tarafında belgeler iki şekilde yardımcı olur: gömülü veri modeli disk G/Ç işlemlerini azaltır ve indeksler gömülü belgelerden ve dizilerden anahtar içerebilir. İndeks olmadan sunucu her sorguda koleksiyonu baştan sona taramak zorunda kalır; bu yüzden indeks oluşturma konusu erken öğrenilmesi gereken başlıklardandır.
MongoDB tamamen transaction destekli bir operasyonel veritabanıdır: birden fazla okuma ve yazma işlemini "hepsi ya da hiçbiri" mantığıyla tek bir transaction içinde çalıştırabilirsiniz. Transaction'lar sharded cluster'larda da aynı ACID garantileriyle çalışır. Yine de belgeler, iyi modellenmiş verinin çoğu senaryoda çok belgeli transaction ihtiyacını azalttığını vurgular. Ayrıntılar ve sınırlar transaction kullanımı yazısında.
Replica set: kopyalama ve otomatik failover
Replica set, aynı veri kümesini tutan bir grup mongod sürecidir ve belgelerde tüm üretim kurulumlarının temeli olarak tanımlanır. Veri taşıyan üyelerden yalnızca biri primary olur ve tüm yazma işlemlerini alır; primary yaptığı her değişikliği oplog adlı işlem günlüğüne kaydeder. Secondary üyeler bu oplog'u kopyalayıp kendi verilerine asenkron olarak uygular.
Primary, yapılandırılan electionTimeoutMillis süresinden (varsayılan 10 saniye) uzun süre diğer üyelerle iletişim kuramazsa uygun bir secondary seçim başlatır ve yeni primary olmaya aday olur. Böylece yazma işlemleri kısa bir kesintinin ardından devam eder. Bütçe başka bir secondary eklemeye izin vermiyorsa seçimlere katılan ama veri tutmayan bir arbiter eklenebilir; arbiter veri yedekliliği sağlamaz.
Varsayılan olarak istemciler primary üzerinden okur. Read preference ayarıyla okumaları secondary üyelere yönlendirebilirsiniz; ancak replikasyon asenkron olduğu için secondary'den okunan veri primary'deki son durumu yansıtmayabilir. Kurulum için replica set kurulumu, tutarlılık ayarları için write concern ve read concern yazılarına bakın. Change stream gibi bazı özellikler de replica set gerektirir.
Depolama motoru ve sürüm seçenekleri
Depolama motoru, verinin bellekte ve diskte nasıl tutulacağını yöneten bileşendir. Varsayılan ve yeni kurulumlar için önerilen motor WiredTiger'dır; belge düzeyinde eşzamanlılık, checkpoint ve sıkıştırma gibi özellikler sunar. Belgeleri diske yazmak yerine bellekte tutan In-Memory motoru ise yalnızca MongoDB Enterprise'da bulunur.
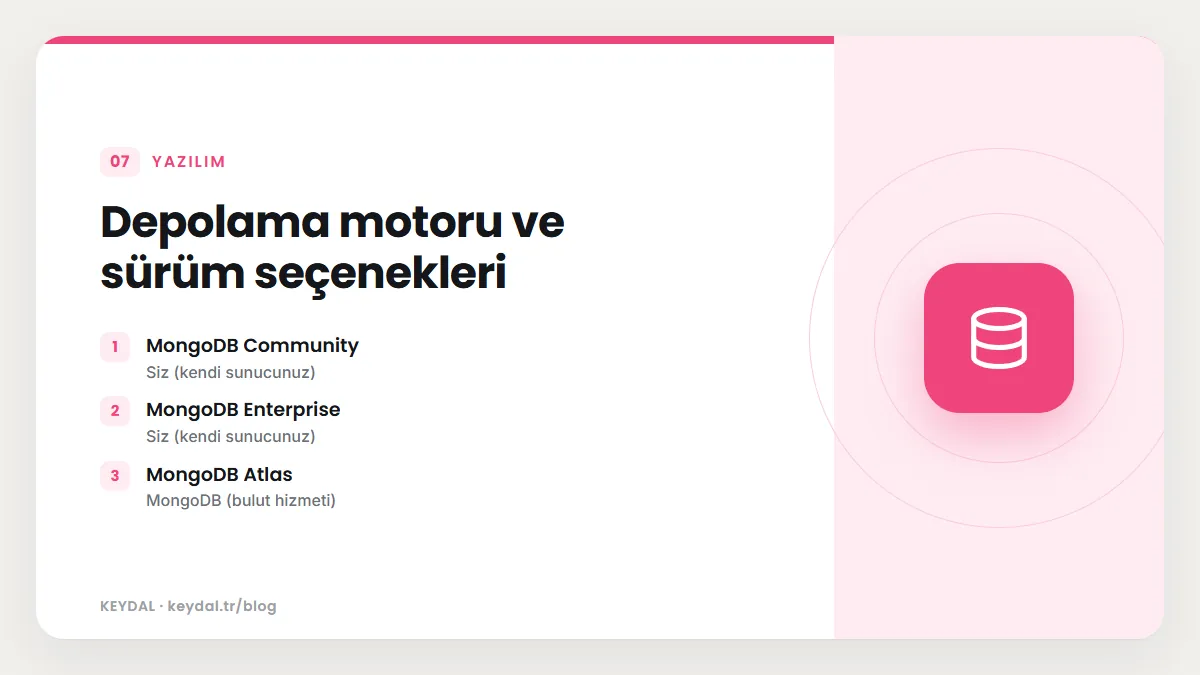
Kendi sunucunuza kurabileceğiniz iki sürüm vardır: kaynak kodu erişilebilir ve ücretsiz kullanılabilen MongoDB Community ile abonelik tabanlı MongoDB Enterprise. Enterprise; LDAP ve Kerberos kimlik doğrulaması, denetim (auditing) ve WiredTiger ile durağan veri şifrelemesi gibi ek özellikler içerir. Bulut tarafında MongoDB Atlas yönetilen hizmet olarak sunulur; Atlas'a özgü konular bu serinin dışında. Community sürümü varsayılan olarak MongoDB Search bileşenini içermez; bu bileşen ayrıca kurulur.
| Seçenek | Kim yönetir | Not |
|---|---|---|
| MongoDB Community | Siz (kendi sunucunuz) | Ücretsiz, kaynak kodu erişilebilir |
| MongoDB Enterprise | Siz (kendi sunucunuz) | Abonelik tabanlı, ek güvenlik ve denetim özellikleri |
| MongoDB Atlas | MongoDB (bulut hizmeti) | Bu serinin kapsamı dışında |
Community sürümünü kurmak için Ubuntu kurulumu veya Windows kurulumu yazılarını izleyebilirsiniz. Kurulumdan sonra ilk iş, sunucuya mongosh ile bağlanmak olacaktır.
MongoDB 9.0 ile gelen önemli değişiklikler
Bu seri MongoDB 9.0 belgelerine dayanıyor. Sürüm notlarına göre MongoDB 9.0 ile tek bir sorgu işleminin kullanabileceği toplam bellek sınırlandı; varsayılan sınır 1 gigabayt veya sunucu sürecinin kullanabildiği belleğin yüzde 20'si, hangisi büyükse odur. Sunucu tarafı JavaScript fonksiyonları ($accumulator, $function, $where) WebAssembly tabanlı bir motorla yeniden etkinleştirildi ve artık deprecated değil. Ayrıca sunucu, aldığı tüm BSON nesnelerini varsayılan olarak doğruluyor. Tam liste için MongoDB 9.0 yenilikler yazısına bakın.
Sık yapılan yanlış anlamalar
- "Şema yok, demek ki doğrulama da yok." Koleksiyonlar şema dayatmaz ama isterseniz
$jsonSchemaile kural koyabilirsiniz. Ayrıntılar schema validation yazısında. - "MongoDB'de join yapılamaz." Gömülü belgeler çoğu join ihtiyacını ortadan kaldırır; gerektiğinde
$lookupaşaması koleksiyonları birleştirir. Bkz. $lookup yazısı. - "Transaction desteklenmez." Çok belgeli ACID transaction'lar desteklenir; sınırları ve maliyeti olduğu için önce modeli doğru kurmak önerilir.
- "Tek sunucu yeterlidir." Geliştirme için tek
mongodyeterlidir; fakat belgeler replica set'i üretim kurulumlarının temeli olarak tanımlar. - "Kurulum bitti, artık internete açabilirim." Paketle kurulan MongoDB varsayılan olarak yalnızca
127.0.0.1adresini dinler. Dış erişim açmadan önce kimlik doğrulamayı etkinleştirmeniz ve güvenlik kontrol listesini uygulamanız gerekir.
Küçük bir başlangıç örneği
Aşağıdaki mongosh oturumu, bir veritabanı seçip iki ürün ekliyor ve stoğu az olanları listeliyor. Bu komutlar kavramları bir arada görmeniz için; yöntemlerin ayrıntısı insertOne ve insertMany ile find sorguları yazılarında.
use magaza
db.urunler.insertMany( [
  { ad: "Fare", stok: 8, kategori: "aksesuar" },
  { ad: "Monitör", stok: 25, kategori: "ekran" }
] )
db.urunler.find( { stok: { $lt: 10 } }, { _id: 0, ad: 1, stok: 1 } )
Son komuttaki ikinci belge bir projection'dır: _id alanını gizler, yalnızca ad ve stok alanlarını döndürür. Bu örnekte yalnızca "Fare" belgesi filtreye uyar.
Sık Sorulan Sorular
MongoDB ilişkisel veritabanlarının yerini mi alır?
Bu bir tercih meselesidir ve kesin bir cevabı yoktur. MongoDB belge modeliyle, verinin uygulama nesnelerine benzer biçimde saklanmasını ve şemanın zamanla esnekçe değişmesini kolaylaştırır. Hangi veritabanı türünün hangi işe uyduğunu veritabanı türleri rehberinde genel olarak ele aldık.
MongoDB verileri JSON olarak mı saklar?
Hayır. Belgeler JSON'a benzer ama diskte ve ağda BSON adlı ikili biçimde tutulur. BSON, JSON'un desteklemediği tarih, Decimal128 ve ObjectId gibi tipleri içerir. JSON'a dönüştürürken tip bilgisini korumak için Extended JSON kullanılır.
Bir belge en fazla ne kadar büyük olabilir?
En fazla 16 mebibayt. Bundan büyük dosyalar için GridFS kullanılır. Belgeleriniz bu sınıra yaklaşıyorsa neyin gömülüp neyin ayrı koleksiyona taşınacağını veri modelleme yazısındaki ölçütlerle yeniden değerlendirin.
Redis ile MongoDB arasındaki fark nedir?
İkisi farklı amaçlara odaklanır. Bu yazı MongoDB'yi anlatıyor; Redis'in veri yapıları ve kullanım alanları için Redis nedir yazısına bakabilirsiniz.
MongoDB öğrenmeye nereden başlamalıyım?
Önce kurulum ve mongosh, ardından CRUD işlemleri, sonra aggregation ve indeksler gelir. Sıralı yol için MongoDB öğrenme rehberini izleyin.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: MongoDB öğrenme rehberi · MongoDB Ubuntu kurulumu · mongosh kullanımı · BSON veri tipleri · Veri modelleme · Veritabanı türleri