MongoDB'de bir sorgunun nasıl çalıştığını görmek için sonuna .explain("executionStats") eklersiniz: db.urunler.find({ kategori: "kitap" }).explain("executionStats"). Çıktı, sorgu planlayıcının seçtiği planı bir aşama ağacı olarak gösterir. En önemli üç işaret şunlardır: COLLSCAN koleksiyonun baştan sona tarandığını, IXSCAN bir indexin kullanıldığını, totalKeysExamined ve totalDocsExamined ile nReturned arasındaki fark ise sorgunun ne kadar gereksiz iş yaptığını söyler.
Bu yazıda explain yöntemlerini, üç ayrıntı düzeyini (verbosity), çıktının önemli alanlarını, sık görülen aşama adlarını, iki indexi karşılaştırmayı ve sorgu planlayıcının plan önbelleğini nasıl kullandığını MongoDB 9.0 belgelerine dayanarak anlatıyoruz. Yavaş sorguları toplu olarak bulmak için veritabanı profiler yazısına, index tasarımı için compound index ve ESR kuralı yazısına bakabilirsiniz.
İki explain yöntemi
mongosh'ta explain iki biçimde çağrılır. cursor.explain() bir find() sorgusunun sonuna eklenir. db.collection.explain() ise önce gelir ve ardından açıklanacak metot yazılır; belgelere göre bu biçim aggregate(), count(), find(), distinct() ve findAndModify() metotlarını destekler ve explain komutunu çalıştırmanın tercih edilen yoludur.
// cursor.explain(): find sonrası
db.urunler.find( { kategori: "kitap", fiyat: { $lt: 200 } } ).explain( "executionStats" )

// db.collection.explain(): metottan önce
db.urunler.explain( "executionStats" ).find( { kategori: "kitap" } ).sort( { fiyat: 1 } )

// Aggregation için
db.urunler.explain( "executionStats" ).aggregate( [
   { $match: { kategori: "kitap" } },
   { $group: { _id: "$yayinevi", adet: { $sum: 1 } } }
] )

// Desteklenen işlemleri ve sorgu değiştiricileri listelemek
db.urunler.explain().help()
db.urunler.explain().find().help()
İki yöntem arasındaki fark küçüktür: db.collection.explain().find() bir cursor döndürdüğü için arkasına sort(), limit(), hint() gibi değiştiricileri zincirleyebilirsiniz. db.collection.explain().aggregate() çağrısı, aggregate() metoduna explain seçeneğini vermekle eşdeğerdir. explain çalıştırmak için alttaki komutu çalıştırma yetkiniz olması yeterlidir.
Üç ayrıntı düzeyi (verbosity)
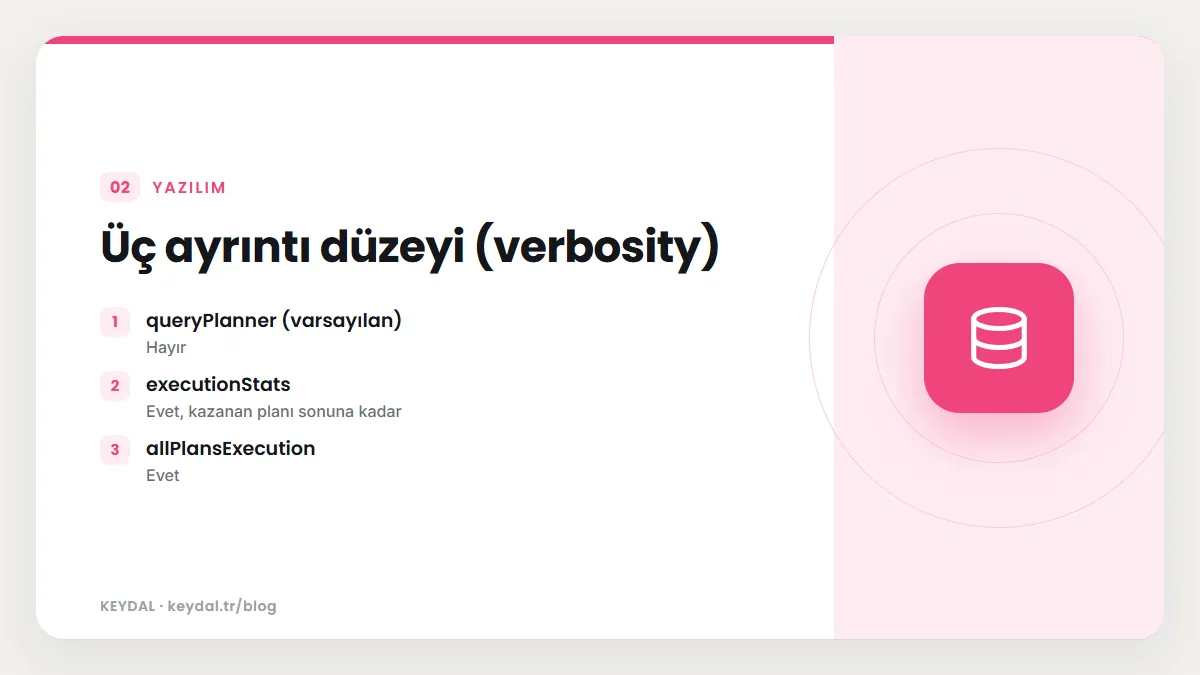
| Mod | Planı çalıştırır mı? | Ne döndürür |
|---|---|---|
| queryPlanner (varsayılan) | Hayır | Seçilen plan ve reddedilen planlar |
| executionStats | Evet, kazanan planı sonuna kadar | Plan + kazanan planın çalışma istatistikleri |
| allPlansExecution | Evet | Yukarıdakiler + plan seçimi sırasında aday planlardan toplanan kısmi istatistikler |
queryPlanner modu sorgu iyileştiriciyi çalıştırıp kazanan planı seçer ama planı yürütmez; bu yüzden hızlıdır ve "hangi index seçiliyor?" sorusuna cevap verir. executionStats kazanan planı sonuna kadar çalıştırır ve kaç anahtar ile belge incelendiğini, sürenin ne olduğunu raporlar; reddedilen planlar için çalışma bilgisi vermez. allPlansExecution buna ek olarak plan seçimi aşamasında rakip planlar için toplanan kısmi verileri de içerir. Geriye uyumluluk için true değeri allPlansExecution, false değeri queryPlanner olarak yorumlanır.
Çıktının yapısı
explain sonucu planı bir aşamalar ağacı olarak sunar. Her aşama ürettiği belgeleri veya index anahtarlarını üstündeki aşamaya aktarır; yaprak aşamalar koleksiyona veya indexe erişir, kök aşama ise sonuç kümesinin son halini verir. Bir aşamanın tek alt aşaması varsa inputStage, birden çok alt aşaması varsa inputStages alanı bulunur. Belgelerdeki iskelet aşağıdaki gibidir (gerçek çıktıda çok daha fazla alan olur):
// Belgelerdeki iskelet (klasik sorgu motoru):
// queryPlanner: {
//    namespace: <string>,
//    indexFilterSet: <boolean>,
//    planCacheShapeHash: <hexadecimal string>,
//    planCacheKey: <hexadecimal string>,
//    winningPlan: { stage: <STAGE1>, inputStage: { stage: <STAGE2>, ... } },
//    rejectedPlans: [ <candidate plan1>, ... ]
// },
// executionStats: {
//    executionSuccess: <boolean>,
//    nReturned: <int>,
//    executionTimeMillis: <int>,
//    totalKeysExamined: <int>,
//    totalDocsExamined: <int>,
//    executionStages: { stage: <STAGE1>, nReturned: <int>, works: <int>, ... }
// }
Çıktının biçimi sorgunun klasik motorla mı yoksa slot tabanlı yürütme motoruyla (SBE) mı çalıştığına göre değişebilir; SBE kullanıldığında plan winningPlan.queryPlan altında görünür ve ek olarak yalnızca MongoDB'nin iç kullanımına yönelik bir slotBasedPlan belgesi bulunur. Aggregation sorgularında ise tek bir plan ağacı yerine en üstte bir stages dizisi yer alır. Belgeler, explain sonuçlarının MongoDB sürümleri arasında değişebileceğini de hatırlatır.
queryPlanner alanları
namespace: Sorgunun eriştiğiveritabani.koleksiyon.winningPlan: Planlayıcının seçtiği plan;stagealanı aşama adını verir.rejectedPlans: Değerlendirilip reddedilen aday planlar; başka aday yoksa boş olabilir. MongoDB 8.0 ve sonrasında reddedilen planlar sorgunun yalnızcafindkısmını içerir.indexFilterSet: Bu sorgu şekli için bir index filtresi uygulanıp uygulanmadığı.planCacheShapeHashveplanCacheKey: Sorgu şeklinin ve plan önbelleği girdisinin özetleri. MongoDB 8.0 ile eskiqueryHashalanıplanCacheShapeHashadıyla da verilmeye başlandı;queryHashileride kaldırılacak.
executionStats alanları
nReturned: Kazanan planın döndürdüğü belge sayısı.totalKeysExamined: Taranan index girdisi sayısı. Sıfırsa sorgu index kullanmamıştır.totalDocsExamined: Yürütme sırasında incelenen belge sayısı. Belgeler bu değerin benzersiz belge sayısı değil, toplam inceleme sayısı olduğunu belirtir; aynı belge birden çok kez incelenirse her biri sayılır.executionTimeMillis: Plan seçimi ve yürütme için geçen toplam süre; istemciye veri aktarımındaki ağ süresini içermez.executionStages: Aşama ağacının yürütme ayrıntıları; her aşamadaworks,advanced,needTime,isEOFgibi sayaçlar bulunur.
executionTimeMillis konusunda belgelerin önemli bir uyarısı var: bu değer gerçek sorgu süresini her zaman yansıtmaz. Normal çalışmada plan önbellekteyse veya hint() kullanılıyorsa plan seçim süreci atlanır ve gerçek süre daha kısa olur. Bu yüzden karşılaştırmalarda süreden çok incelenen anahtar ve belge sayılarına bakmak daha güvenilirdir.
Sık görülen aşama adları
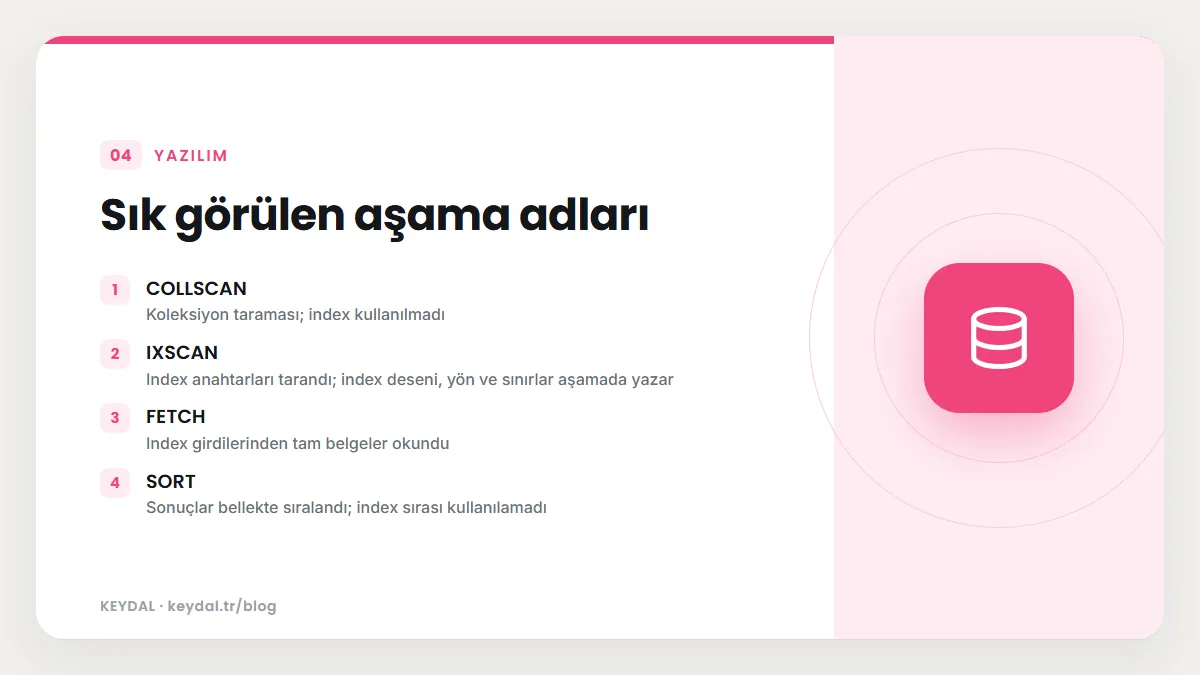
| Aşama | Anlamı |
|---|---|
| COLLSCAN | Koleksiyon taraması; index kullanılmadı |
| IXSCAN | Index anahtarları tarandı; index deseni, yön ve sınırlar aşamada yazar |
| FETCH | Index girdilerinden tam belgeler okundu |
| SORT | Sonuçlar bellekte sıralandı; index sırası kullanılamadı |
| PROJECTION | Dönen alanlar bellekte süzüldü |
| OR | Bir $or ifadesinin her dalı ayrı bir alt planla, çoğu zaman ayrı indexle çalıştı |
| SHARD_MERGE | Shardlardan gelen sonuçlar birleştirildi |
| SHARDING_FILTER | Shardlardaki yetim (orphan) belgeler süzüldü |
| BATCHED_DELETE | Gruplanmış çoklu silme (MongoDB 6.1 ve sonrası) |
| EOF | Aşama akışın sonuna ulaştı; örneğin koleksiyon yoksa |
| EXPRESS_IXSCAN ve diğer EXPRESS aşamaları | Normal plan seçimini atlayan sınırlı sayıda basit sorgu (MongoDB 8.0 ile) |
EOF aşamasında type alanı nedeni açıklar: "nonExistentNamespace" sorgulanan koleksiyonun olmadığını, "predicateEvalsToFalse" ise ifade sadeleştirmesinin sorgunun hiçbir belgeyle eşleşmeyeceğini belirlediğini gösterir. Koleksiyon adını yanlış yazdığınızda sorgu hata vermeden boş döner; explain'de bu aşamayı görmek hatayı hemen ortaya çıkarır.
Çıktıyı yorumlamak: index öncesi ve sonrası
Belgelerdeki örnek iyi bir okuma alıştırmasıdır. Örnek veri setindeki movies koleksiyonunda 2000 ile 2005 arasındaki yılları arayan sorgu, index yokken COLLSCAN aşamasıyla çalışır; 21349 belgenin hepsini inceler (totalDocsExamined), sıfır index anahtarına bakar (totalKeysExamined) ve 3809 belge döndürür. year alanına index eklendikten sonra aynı sorgu FETCH altında bir IXSCAN kullanır ve hem incelenen anahtar hem de incelenen belge sayısı 3809'a, yani döndürülen belge sayısına iner.
// Kendi verinizde aynı karşılaştırmayı yapmak için:
const filtre = { yil: { $gte: 2000, $lte: 2005 } }

// 1. Index yokken
db.filmler.find( filtre ).explain( "executionStats" )

// 2. Index ekleyin ve tekrar bakın
db.filmler.createIndex( { yil: 1 } )
db.filmler.find( filtre ).explain( "executionStats" )
Bu iki çıktıyı okurken sırasıyla şu soruları sorun. Kök veya yaprak aşamada COLLSCAN var mı? Varsa filtre veya sıralama alanları için bir index eksik olabilir. totalDocsExamined değeri nReturned değerinden çok büyük mü? Büyükse index ya yok ya da yeterince seçici değil; MongoDB belgeleri okuyup filtreyle ayıklıyor demektir. totalKeysExamined değeri nReturned değerinden çok mu büyük? Bu, indexin sorguyu tam daraltamadığını, örneğin compound indexte alan sırasının uygun olmadığını gösterebilir. Plan bir SORT aşaması içeriyor mu? İçeriyorsa sıralama index sırasından okunamıyor ve bellekte yapılıyordur.
İdeal durum, incelenen anahtar, incelenen belge ve döndürülen belge sayılarının birbirine eşit ya da çok yakın olmasıdır. Belgelerin "Explain Slow Queries" sayfası da aynı adımları önerir: önce süreye, sonra aşamalara, ardından anahtar ve belge sayılarının karşılaştırmasına bakın.
Bir uyarı daha: explain çıktısı tek bir çalıştırmanın fotoğrafıdır. Planlayıcının seçimi veri dağılımına ve mevcut indexlere bağlı olduğu için, geliştirme makinenizdeki birkaç yüz belgelik koleksiyonda görülen plan, milyonlarca belgelik üretim koleksiyonunda farklı çıkabilir. Belgelerin indexleme stratejileri sayfası da birden çok index yapılandırmasını üretime benzer veriler üzerinde denemeyi önerir.
Covered query nasıl görünür?
Bir index sorguyu tamamen karşılıyorsa (covered query), MongoDB belgeye hiç dokunmadan sonucu indexten üretir. Explain'de bu durum, IXSCAN aşamasının bir FETCH aşamasının altında olmaması ile anlaşılır. Belgeler, sorguda az alan döndüren ve yazma yoğun olmayan koleksiyonlarda FETCH görüyorsanız sorguyu cover edecek bir index eklemeyi düşünmenizi önerir. Koşulları compound index yazısında anlattık.
İki indexi hint ile karşılaştırmak
Planlayıcı çoğu zaman doğru indexi seçer, ama iki aday index arasında kararsızsanız her birini hint() ile zorlayıp sonuçları karşılaştırabilirsiniz. hint() parametresi index adı ya da anahtar deseni olabilir. { $natural: 1 } vermek ise hiçbir indexin kullanılmamasını sağlar; koleksiyon taramasıyla index taramasını kıyaslamak için kullanışlıdır.
const sorgu = { kategori: "kitap", fiyat: { $lt: 200 } }

db.urunler.find( sorgu ).hint( { kategori: 1, fiyat: 1 } ).explain( "executionStats" )
db.urunler.find( sorgu ).hint( { fiyat: 1 } ).explain( "executionStats" )

// Hiç index kullanma (koleksiyon taraması)
db.urunler.find( sorgu ).hint( { $natural: 1 } ).explain( "executionStats" )
Belgelerdeki bir örnekte aynı sorgu için bir compound index 235 sonuç için 246 anahtar incelerken, alan sırası ters çevrilmiş diğer index yalnızca 235 anahtar inceler; daha az anahtar inceleyen index tercih edilir. Gizli (hidden) indexlere hint() verilemeyeceğini ve bir sorgu şekli için index filtresi tanımlıysa hint()'in yok sayıldığını unutmayın.
Sorgu planlayıcı ve plan önbelleği
Belgelere göre MongoDB her sorgu için mevcut indexlere bakarak verimli bir plan seçer ve bu planı önbelleğe alır. Klasik çoklu planlayıcıda (multi-planner) kazanan plan, kısa bir deneme süresinde en az işle en çok sonuç üreten plandır. MongoDB 8.3 ve sonrasında uygun sorgular için varsayılan mekanizma, maliyet tabanlı sıralayıcının (cost-based ranker, CBR) yedek olarak beklediği çoklu planlamadır; deneme başarısız olursa kurallara göre CBR devreye girebilir. Belgeler CBR'nin şimdilik az sayıda sorgu için kullanıldığını belirtir.
Seçilen plan, aynı plan önbelleği sorgu şekline (filtre, sıralama ve projeksiyonun biçimi) sahip sonraki sorgular için yeniden kullanılır. Önbellek girdisi "Missing", "Inactive" ve "Active" durumlarından birindedir: ilk görülen şekil için Inactive bir yer tutucu oluşur, plan yeterince iyi çıkınca Active hale gelir, performansı kötüleşen Active girdi tekrar Inactive olur. Önbellek mongod yeniden başladığında kaybolur; koleksiyon silmek veya index oluşturmak, silmek ya da gizlemek gibi her DDL olayı ilgili koleksiyonun önbelleğini temizler. $planCacheStats aggregation aşamasıyla önbelleği görebilir, PlanCache.clear() ile tamamen temizleyebilirsiniz.
// Bir koleksiyonun plan önbelleğini görmek
db.urunler.aggregate( [ { $planCacheStats: { } } ] )

// Önbelleği temizlemek
db.urunler.getPlanCache().clear()
Planlayıcıyı kalıcı olarak yönlendirmek gerekirse MongoDB 8.0 ve sonrasında index filtreleri yerine setQuerySettings ile query settings kullanılması önerilir; index filtreleri 8.0 ile kullanımdan kaldırılmıştır (deprecated), kalıcı değildir ve sunucu kapanınca silinir.
MongoDB 9.0 ile explain çıktısındaki eklemeler
MongoDB 9.0 sürüm notları sorgu tarafında explain çıktısını etkileyen iki ekleme listeler. Birincisi query knobs: 9.0 ile tek bir sorgu şekli için iç sunucu parametrelerini queryKnobs query setting'i ile geçersiz kılabilirsiniz ve explain sayfasına göre çıktıdaki queryKnobs alanı her knob'un etkin değerini ve bu değerin "querySettings" veya "setParameter" kaynaklarından hangisinden geldiğini gösterir. İkincisi klasik sorgu motorunun executionStats ve üstü ayrıntı düzeyinde $project, $addFields, $set, $match ve $lookup gibi aşamalar için expressionEvaluationPeakMemoryBytes alanını raporlamasıdır. Ayrıca belgelere göre 9.0 ile sharded cluster'da var olmayan bir veritabanına karşı bir yazma işlemini explain etmek o veritabanını oluşturmaz. Diğer değişiklikler için MongoDB 9.0 yenilikleri yazısına bakın.
Sık yapılan hatalar
- Varsayılan modda istatistik aramak:
explain()parametresiz çağrıldığındaqueryPlannerçalışır veexecutionStatsbölümü gelmez. - Yalnızca süreye bakmak:
executionTimeMillisplan seçimini içerir ve önbellekli gerçek çalışmadan farklıdır; anahtar ve belge sayılarını karşılaştırın. - Küçük test verisiyle karar vermek: Planlayıcı, veri dağılımına göre farklı plan seçebilir; üretime benzer veriyle ölçün.
- IXSCAN görünce işi bitmiş saymak: Index kullanılsa bile
totalKeysExaminedçok yüksekse alan sırası veya seçicilik sorunlu olabilir. - SORT aşamasını gözden kaçırmak: Bellek içi sıralama büyük sonuç kümelerinde sorgunun en pahalı kısmı olabilir.
Sık Sorulan Sorular
explain sorguyu gerçekten çalıştırır mı?
queryPlanner modunda hayır, yalnızca plan seçilir. executionStats ve allPlansExecution modlarında kazanan plan sonuna kadar çalıştırılır; yazma işlemlerinde ise değişiklik uygulanmaz.
Sorgunun index kullanıp kullanmadığını en hızlı nasıl anlarım?
explain() çıktısında winningPlan altındaki aşamalara bakın: IXSCAN index kullanımını, COLLSCAN koleksiyon taramasını gösterir. executionStats modunda totalKeysExamined değerinin sıfır olması da index kullanılmadığı anlamına gelir.
Covered query olup olmadığını nasıl görürüm?
Planda IXSCAN aşaması bir FETCH aşamasının altında değilse ve totalDocsExamined sıfırsa sorgu index tarafından karşılanmıştır.
Aggregation pipeline için de explain kullanılır mı?
Evet. db.koleksiyon.explain("executionStats").aggregate([...]) ile pipeline'ı açıklayabilirsiniz; çıktıda aşamalar en üstteki stages dizisinde listelenir. Pipeline kavramı için aggregation pipeline yazısına bakın.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: MongoDB öğrenme rehberi · MongoDB index oluşturma · Compound index ve ESR kuralı · Yavaş sorgu profiler · Aggregation pipeline · sort, limit ve sayfalama