MongoDB'de bir metin alanında desen araması yapmak için $regex operatörü veya doğrudan JavaScript düzenli ifade nesnesi (/desen/) kullanılır. SQL'deki LIKE '%kitap%' sorgusunun karşılığı db.urunler.find({ ad: /kitap/ }), büyük/küçük harf duyarsız hali ise /kitap/i biçimindedir. MongoDB düzenli ifadeleri PCRE2 kütüphanesiyle işler.
Regex sorguları esnektir ama indeks kullanımı açısından ciddi farklar barındırır: ^ ile başlayan bir önek araması indeksten hızla yararlanırken, ortadan arama veya büyük/küçük harf duyarsız arama koleksiyonun büyük kısmını taramayı gerektirebilir. Bu yazıda söz dizimini, seçenekleri, indeks davranışını ve Türkçe karakterlerle ilgili önemli bir ayrıntıyı ele alıyoruz. Serinin tamamı için MongoDB öğrenme rehberine bakabilirsiniz.
Söz dizimi: $regex ve /desen/
Bir alana düzenli ifade uygulamanın üç yazım biçimi vardır. Hepsi aynı işi yapar, ancak bazı özellikler yalnızca belirli biçimlerle kullanılabilir.
// 1) $regex + $options
{ ad: { $regex: /kitap/, $options: "i" } }

// 2) Desen metin olarak (JSON uyumlu yazım)
{ "ad": { "$regex": "kitap", "$options": "i" } }

// 3) Seçenek desenin sonunda
{ ad: { $regex: /kitap/i } }

// Kısa yol: doğrudan regex nesnesi
{ ad: /kitap/i }
Pratikte kısa yol olan { ad: /kitap/i } en çok kullanılan biçimdir. Desen bir değişkenden oluşuyorsa metin biçimi ($regex: "...") işinizi kolaylaştırır. Sürücülerde veya JSON gönderen API'lerde de genellikle metin biçimi kullanılır, çünkü JSON'da regex nesnesi diye bir tip yoktur.
Örnek veri ve temel sorgular
Aşağıdaki örneklerde küçük bir ürün koleksiyonu kullanıyoruz. Her sorgunun hangi belgeleri getireceğini metinde açıklıyoruz; sonuçları kendi verinizle karşılaştırabilirsiniz.
db.urunler.insertMany([
  { _id: 1, kod: "KTP-100", ad: "Roman kitap seti" },
  { _id: 2, kod: "ktp-205", ad: "Defter\nÇizgili kitap kapaklı" },
  { _id: 3, kod: "KLM-310", ad: "Kalem kutusu" },
  { _id: 4, kod: "DFT-205", ad: "Kitaplık rafı" }
])

// Kodu "205" ile bitenler (SQL: LIKE '%205')
db.urunler.find({ kod: /205$/ })

// Kodu "KTP" ile başlayanlar, büyük/küçük harf duyarsız
db.urunler.find({ kod: /^KTP/i })

// Adında "kitap" geçenler (SQL: LIKE '%kitap%'), harf duyarlı
db.urunler.find({ ad: /kitap/ })
İlk sorgu _id değeri 2 ve 4 olan belgeleri döndürür; ikisinin de kodu 205 ile biter. İkinci sorgu i seçeneği sayesinde hem "KTP-100" hem "ktp-205" kodlu belgeleri, yani 1 ve 2'yi getirir. Üçüncü sorgu harf duyarlıdır: 1 ve 2 numaralı belgelerde küçük harfle "kitap" geçtiği için eşleşir, 4 numaralı belgedeki "Kitaplık" ise büyük K ile başladığı için eşleşmez.
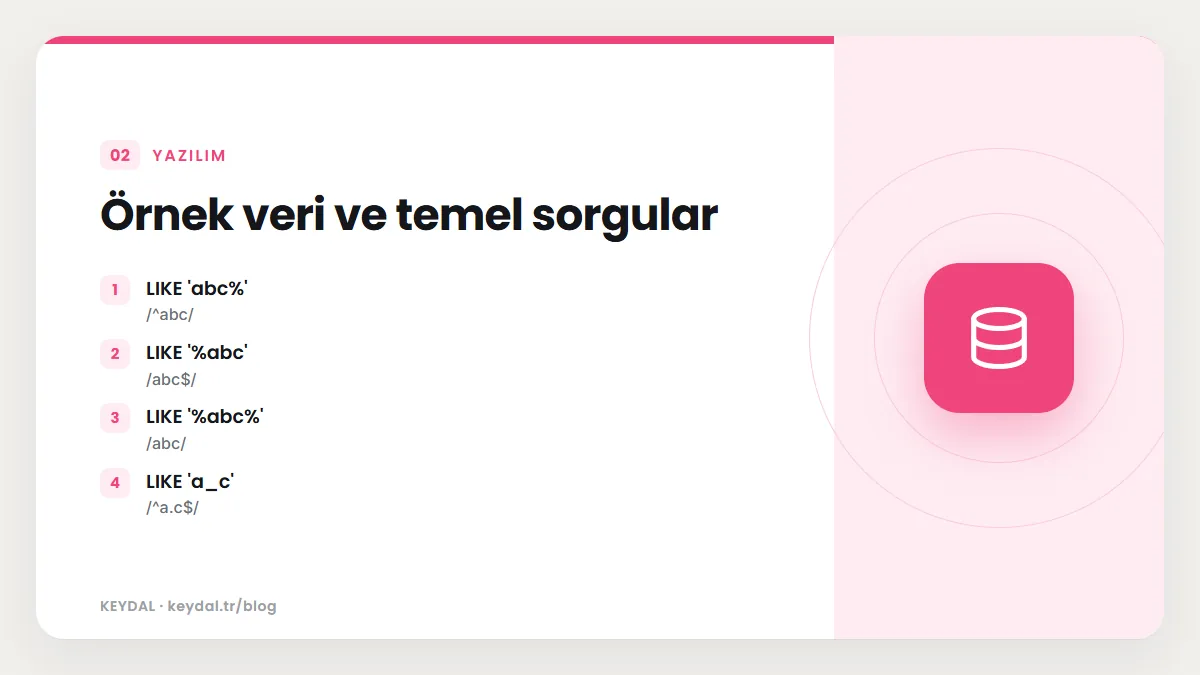
| SQL LIKE | MongoDB regex | Anlamı |
|---|---|---|
| LIKE 'abc%' | /^abc/ | abc ile başlayan |
| LIKE '%abc' | /abc$/ | abc ile biten |
| LIKE '%abc%' | /abc/ | İçinde abc geçen |
| LIKE 'a_c' | /^a.c$/ | a, herhangi bir karakter, c |
| ILIKE (harf duyarsız) | /abc/i | Büyük/küçük harf farkı gözetmeden |
SQL ile MongoDB arasındaki diğer sorgu karşılıkları için MongoDB ve SQL karşılaştırma yazısına bakabilirsiniz.
Seçenekler: i, m, x, s, u
$options ile veya desenin sonuna eklenerek kullanılan seçenekler şunlardır:
| Seçenek | Etkisi |
|---|---|
| i | Büyük ve küçük harfleri ayırt etmeden eşleştirir. |
| m | Desende ^ veya $ çapası varsa, çok satırlı metinlerde her satırın başında ve sonunda eşleşir. |
| x | Desendeki boşlukları ve # ile satır sonu arasındaki yorumları yok sayar. |
| s | Nokta karakterinin satır sonu dahil her karakterle eşleşmesini sağlar. |
| u | Kabul edilir ama gereksizdir; $regex için UTF zaten varsayılan olarak açıktır. |
m seçeneği yalnızca desende çapa varsa ve metinde satır sonu (\n) karakteri bulunuyorsa fark yaratır. Örneğimizde { ad: { $regex: /^Ç/, $options: "m" } } sorgusu 2 numaralı belgeyi bulur, çünkü "Çizgili" ikinci satırın başındadır; m olmadan ^ yalnızca metnin başına baktığı için bu belge eşleşmez. Çapa içermeyen bir desen zaten metnin tamamında aranır.
Bilinmesi gereken iki kısıt daha vardır. Birincisi, MongoDB genel arama değiştiricisi g'yi desteklemez; bir sorgu zaten belgenin eşleşip eşleşmediğiyle ilgilendiği için bu seçeneğe ihtiyaç da yoktur. İkincisi, x ve s seçeneklerini kullanmak için $regex operatörünü $options ile birlikte yazmanız gerekir. Örneğin i ve s birlikte isteniyorsa { ad: { $regex: /defter.*kitap/, $options: "si" } } biçimi kullanılır.
// x seçeneği: boşluklar ve yorumlar desenin parçası sayılmaz
var desen = "KTP #kategori kodu\n-100 #ürün numarası"
db.urunler.find({ kod: { $regex: desen, $options: "x" } })

// s seçeneği: nokta satır sonuyla da eşleşir
db.urunler.find({ ad: { $regex: /defter.*kitap/, $options: "si" } })
İlk sorgu yorumlar ve boşluklar atıldıktan sonra "KTP-100" desenine indirgenir ve 1 numaralı belgeyi bulur. İkinci sorgu, 2 numaralı belgede "Defter" ile "kitap" arasında bir satır sonu olduğu için s seçeneği sayesinde eşleşir; s olmasaydı nokta satır sonunu geçemezdi.
$in, $not ve diğer operatörlerle birlikte kullanım
$in içinde düzenli ifade kullanmak isterseniz yalnızca /desen/ nesnelerini kullanabilirsiniz; $in içine $regex operatör ifadesi yazılamaz. Buna karşılık aynı alana virgülle ayrılmış başka koşullar eklemek istiyorsanız (örneğin $nin), $regex operatör biçimini kullanmanız gerekir.
// Birden fazla önekten herhangi biri
db.urunler.find({ kod: { $in: [ /^ktp/i, /^dft/i ] } })

// Regex ve başka bir koşul aynı alanda
db.urunler.find({ kod: { $regex: /^k/i, $nin: [ "KLM-310" ] } })

// Desene UYMAYANLAR
db.urunler.find({ kod: { $not: /^K/ } })
db.urunler.find({ kod: { $not: { $regex: "^K" } } })
$not hem regex nesneleriyle hem de $regex operatör ifadeleriyle çalışır. Örnekteki son iki sorgu, kodu büyük K ile başlamayan belgeleri, yani "ktp-205" ve "DFT-205" kodlu belgeleri döndürür. Genel operatör kullanımı için sorgu operatörleri yazısına bakın.
PCRE2 ve satır içi seçenekler
Belgelere göre MongoDB 6.1 sürümünden beri düzenli ifade eşleştirmesi için PCRE2 kütüphanesini kullanır. JavaScript'te bulunmayan bir PCRE özelliğini kullanmak istiyorsanız, deseni metin olarak ve $regex operatörüyle yazmalısınız. Örneğin (?i) büyük/küçük harf duyarsız eşleşmeyi başlatır, (?-i) bitirir. Böylece desenin yalnızca bir kısmını harf duyarsız yapabilirsiniz.
// İlk harf duyarsız, geri kalanı duyarlı: "ktp" ve "Ktp" eşleşir, "kTP" eşleşmez
db.urunler.find({ kod: { $regex: "(?i)k(?-i)tp" } })
Türkçe karakterler ve \b, \w: *UCP seçeneği
Türkçe metinlerle çalışırken bilmeniz gereken önemli bir ayrıntı var. Belgelere göre \b (kelime sınırı) ve \w (kelime karakteri) gibi bazı regex yapıları varsayılan olarak yalnızca ASCII karakterleri tanır. ç, ğ, ı, İ, ö, ş, ü gibi harfler ASCII dışında olduğu için, bu yapılar onları kelimenin parçası olarak görmeyebilir ve beklenmedik eşleşmeler ortaya çıkar. Belgelerdeki örnekte "Öyster" kelimesindeki Ö harfi yok sayıldığı için /\byster/ deseni bu kelimeyle eşleşir; oysa hiçbir kelime "yster" ile başlamamaktadır.
MongoDB 6.1'den itibaren bunun için desenin başına (*UCP) eklenebilir; bu seçenek UTF-8 karakterlerin de tanınmasını sağlar. Bedeli performanstır: *UCP eşleşme için çok aşamalı bir tablo araması gerektirdiğinden sorgular bu seçenek olmadan yazılanlardan daha yavaş çalışır.
// Amaç: "anta" ile BAŞLAYAN kelimeleri bulmak.
// Varsayılan ASCII davranışında "Ç" kelime karakteri sayılmaz; bu yüzden
// "Çanta" kelimesinde Ç ile a arasında bir kelime sınırı görülebilir.
db.notlar.find({ metin: { $regex: /\banta/ } })

// UTF-8 karakterleri de tanıması için desenin başına (*UCP)
db.notlar.find({ metin: { $regex: "(*UCP)\\banta" } })
Bu örnek, belgelerdeki "Öyster" örneğinin Türkçe karşılığıdır: ilk sorgu "Çanta" içeren belgelerle de eşleşebilir, (*UCP) eklenmiş ikinci sorgu ise Ç harfini kelimenin parçası sayar. Kendi verinizle iki sorguyu karşılaştırarak farkı görebilirsiniz.
İndeks kullanımı ve performans
Regex sorgularında performansı belirleyen asıl etken, sorgunun harf duyarlı olup olmadığı ve desenin nasıl başladığıdır. Harf duyarlı bir regex sorgusunda alanda indeks varsa MongoDB deseni koleksiyondaki belgeler yerine indeksteki değerler üzerinde dener; bu, koleksiyon taramasından daha hızlı olabilir.
Asıl kazanç "önek ifadesi" (prefix expression) denen desenlerde gelir. Desen ^ veya \A çapasıyla başlıyor ve ardından basit karakterler geliyorsa, bütün olası eşleşmeler aynı önekle başlar. MongoDB bu önekten bir aralık oluşturur ve indekste yalnızca o aralıktaki değerleri dener. /^abc.*/ deseni yalnızca abc ile başlayan indeks değerlerine bakacak şekilde iyileştirilir.
İnce bir ayrıntı: /^a/, /^a.*/ ve /^a.*$/ aynı metinlerle eşleşir ve üçü de uygun indeks varsa onu kullanır; ancak son ikisi daha yavaştır. /^a/ öneki eşleştirdikten sonra taramayı durdurabilir. Yani önek aramalarında desenin sonuna gereksiz .* eklemeyin.
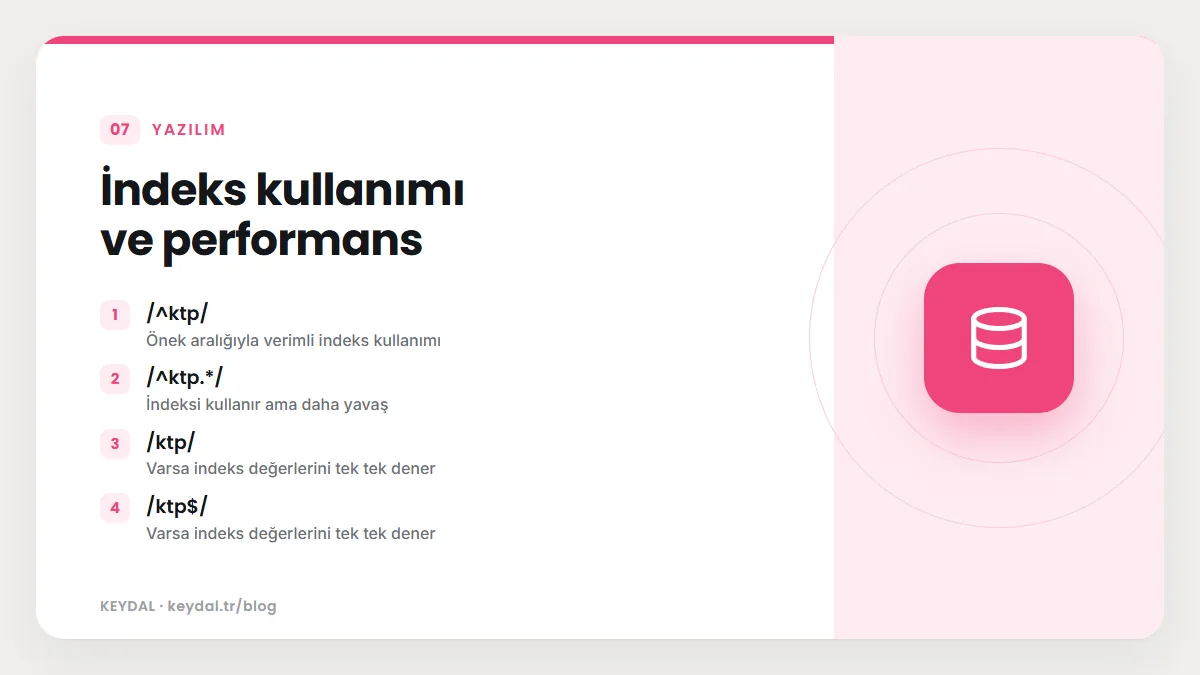
| Desen | İndeks davranışı | Not |
|---|---|---|
| /^ktp/ | Önek aralığıyla verimli indeks kullanımı | En iyi durum |
| /^ktp.*/ | İndeksi kullanır ama daha yavaş | Gereksiz .* eklemeyin |
| /ktp/ | Varsa indeks değerlerini tek tek dener | Aralık daraltılamaz |
| /ktp$/ | Varsa indeks değerlerini tek tek dener | Aralık daraltılamaz |
| /^ktp/i | Önek optimizasyonu belgelerde yalnızca harf duyarlı sorgular için anlatılır | Case-insensitive indeksten yararlanamaz |
Büyük/küçük harf duyarsız regex sorguları için kritik bir uyarı vardır: case-insensitive indeksler $regex sorgularını hızlandırmaz. Çünkü $regex operatörü collation'dan habersizdir ve collation ile oluşturulmuş indekslerden yararlanamaz. Çoğu zaman /^deger$/i yazılarak yapılan "harf duyarsız tam eşleşme" aramaları bu yüzden yavaştır.
Harf duyarsız tam eşleşme için collation
Eğer amacınız desen araması değil, yalnızca büyük/küçük harf farkını gözetmeyen bir eşitlik karşılaştırmasıysa (örneğin e-posta veya kullanıcı adı), regex yerine collation kullanmak daha doğru bir yoldur. Collation, metin karşılaştırmasında dil kurallarını belirler; strength değeri 1 veya 2 olduğunda karşılaştırma harf duyarsız olur. 1 yalnızca temel karakterleri karşılaştırır ve aksanları da yok sayar, 2 aksan farklarını dikkate alır ama harf büyüklüğünü almaz. Varsayılan seviye 3'tür ve harf büyüklüğünü de karşılaştırır.
// Harf duyarsız indeks (Türkçe kurallarıyla)
db.kullanicilar.createIndex(
  { kullaniciAdi: 1 },
  { collation: { locale: "tr", strength: 2 } }
)

// İndeksi kullanmak için sorgu AYNI collation'ı belirtmelidir
db.kullanicilar.find({ kullaniciAdi: "ayse" })
  .collation({ locale: "tr", strength: 2 })
Bir indeksin collation'ını kullanabilmek için sorgu ve sıralama işlemlerinin indeksle aynı collation'ı belirtmesi gerekir. Koleksiyon oluştururken varsayılan bir collation tanımlarsanız, sonradan oluşturulan indeksler ve ayrı bir collation belirtmeyen sorgular bu varsayılanı devralır. Türkçe, desteklenen diller listesinde tr koduyla yer alır. Bu tür indekslerin ayrıntıları için unique, partial, sparse ve case-insensitive indeksler yazısına bakın.
Kullanıcı girdisinden regex oluşturmak
Arama kutusundan gelen metni doğrudan desene koymak yaygın bir hatadır. Düzenli ifadelerde nokta, yıldız, soru işareti, parantez gibi karakterlerin özel anlamı vardır; kullanıcının yazdığı "c++" veya "1.5" gibi bir metin desen olarak yorumlanır ve beklenmedik sonuçlar verir. Ayrıca çok karmaşık desenler sunucuda gereksiz yük oluşturabilir. Kullanıcı metnini desene koymadan önce özel karakterleri kaçışlayın ve aramayı mümkünse bir önek aramasıyla sınırlayın.
// Kullanıcı girdisindeki özel karakterleri kaçışla
function kacisla(metin) {
  return metin.replace(/[.*+?^${}()|[\]\\]/g, "\\$&")
}

const aranan = kacisla("c++")
db.urunler.find({ ad: { $regex: "^" + aranan, $options: "i" } })
Kaçışlama fonksiyonundaki g bayrağı JavaScript'in replace yöntemine aittir ve istemci tarafında çalışır; MongoDB'ye giden desende g kullanılmaz.
Regex mi, metin araması mı?
Regex, kod, SKU, önek veya belirli bir desen aramak için uygundur. Kelime bazlı, dil kurallarını gözeten serbest metin araması gerekiyorsa kendi sunucunuzda text indeks ve $text daha uygun bir araçtır. Atlas üzerinde barındırılan veriler için MongoDB ayrıca kendi $regex operatörüne sahip ayrı bir tam metin arama çözümü sunar; bu yazı kendi sunucunuzda (self-managed) çalışan $regex sorgusunu anlatır.
Son bir pratik not: mongodump ile yalnızca belirli belgeleri yedeklemek için -q parametresine regex içeren bir sorgu verebilirsiniz. Bu sorgu Extended JSON v2 biçiminde olmalı, alan adları ve operatörler tırnak içinde yazılmalı ve kabukla çakışmaması için tek tırnak arasına alınmalıdır. Ayrıntılar için mongodump ve mongorestore yazısına bakın.
mongodump -d=magaza -c=urunler -q='{"kod": {"$regex": "^KTP"}}'Sık yapılan hatalar
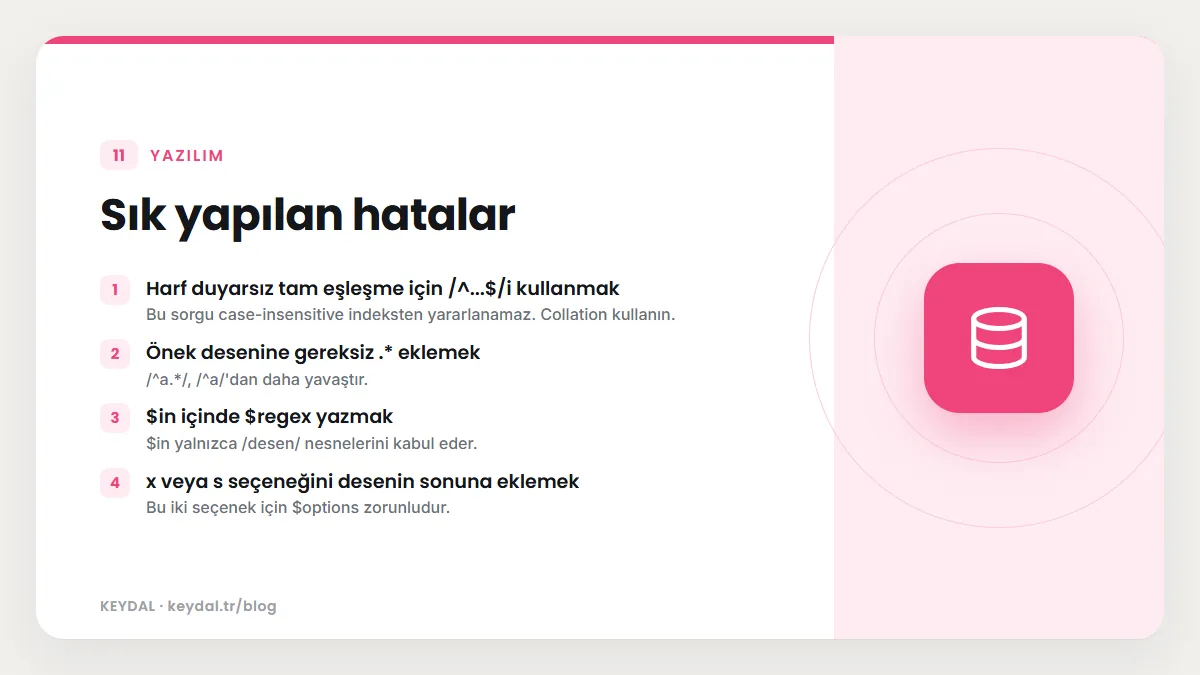
- Harf duyarsız tam eşleşme için /^...$/i kullanmak: Bu sorgu case-insensitive indeksten yararlanamaz. Collation kullanın.
- Önek desenine gereksiz .* eklemek:
/^a.*/,/^a/'dan daha yavaştır. - $in içinde $regex yazmak:
$inyalnızca/desen/nesnelerini kabul eder. - x veya s seçeneğini desenin sonuna eklemek: Bu iki seçenek için
$optionszorunludur. - Türkçe metinlerde \b ve \w'ye güvenmek: Varsayılan davranış ASCII ile sınırlıdır; gerekirse
(*UCP)kullanın ve yavaşlamayı hesaba katın. - Kullanıcı girdisini kaçışlamadan desene koymak: Özel karakterler desenin anlamını değiştirir.
Sık Sorulan Sorular
MongoDB'de LIKE sorgusunun karşılığı nedir?
LIKE '%metin%' için { alan: /metin/ }, LIKE 'metin%' için { alan: /^metin/ } kullanılır. Önek araması indeksten en iyi yararlanan biçimdir.
Regex sorgusu indeks kullanır mı?
Harf duyarlı sorgularda, alanda indeks varsa MongoDB deseni indeks değerleri üzerinde dener; desen ^ ile basit bir önekle başlıyorsa aralık daraltılarak çok daha verimli çalışır. Harf duyarsız regex sorguları case-insensitive indekslerden yararlanamaz.
i seçeneği Türkçe harflerle doğru çalışır mı?
Belgeler i seçeneğinin Türkçeye özgü büyük/küçük harf eşleştirmesi hakkında ayrı bir açıklama yapmaz. Dil kurallarına göre harf duyarsız karşılaştırma gerekiyorsa, regex yerine locale: "tr" ile collation kullanmak belgelenmiş ve dile duyarlı bir yoldur. Regex ile çalışıyorsanız kendi verinizle test edin.
Regex ile değeri değiştirmek mümkün mü?
$regex bir sorgu operatörüdür, yalnızca eşleşen belgeleri seçer. Eşleşen belgeleri güncellemek için aynı filtreyi updateMany ile kullanabilirsiniz.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: MongoDB öğrenme rehberi · find sorguları · sorgu operatörleri · text indeks ve metin arama · case-insensitive indeksler · SQL karşılaştırma