lambda, Python'da tek bir ifadeden oluşan küçük ve adsız bir fonksiyon yazmanın yoludur: lambda x: x * 2, def ile yazılmış ve return x * 2 yapan bir fonksiyonla aynı işi görür. En sık kullanıldığı yer, sorted(), min(), max() ve list.sort() fonksiyonlarının key parametresidir. map() bir fonksiyonu her elemana uygular, filter() koşulu sağlayan elemanları seçer; ikisi de liste değil, tembel bir yineleyici (iterator) döndürür. operator modülündeki itemgetter ve attrgetter ise çoğu basit lambda'nın hazır ve daha hızlı karşılığıdır.
Bu yazıda bu araçları resmî Python belgelerine (Tutorial, Language Reference, Sorting Techniques ve Functional Programming HOWTO) dayanarak anlatıyoruz. Bütün örnekler Python 3.15.2 ile çalıştırıldı. Fonksiyon tanımlamanın temelleri için önce def ile fonksiyon tanımlama yazısına bakabilirsiniz.
lambda ifadesi: tek satırlık adsız fonksiyon
Language Reference'a göre lambda parametreler: ifade yazımı bir fonksiyon nesnesi üretir ve bu nesne, gövdesi return ifade olan bir def fonksiyonu gibi davranır. Parametre listesi def'tekiyle aynı kuralları izler: varsayılan değer, *args, **kwargs kullanılabilir. Fark, gövdenin yalnızca tek bir ifade olabilmesidir; return, atama, döngü, try gibi deyimler ve tip notları lambda içinde yazılamaz. Tutorial bu yüzden lambda'yı, normal fonksiyon tanımının sözdizimsel bir kısaltması olarak tarif eder.
topla = lambda a, b: a + b
print(topla(2, 3))                     # çıktı: 5
print(topla.__name__)                  # çıktı: <lambda>

def topla_def(a, b):
    return a + b
print(topla_def.__name__)              # çıktı: topla_def

print((lambda x: x * 2)(21))           # çıktı: 42
selam = lambda ad, kelime='Merhaba': f'{kelime}, {ad}!'
print(selam('Ece'))                    # çıktı: Merhaba, Ece!
tek_cift = lambda n: 'çift' if n % 2 == 0 else 'tek'
print(tek_cift(7))                     # çıktı: tek
Lambda'nın adı her zaman <lambda> olur; hata mesajlarında ve izleme çıktılarında fonksiyonu tanımak bu yüzden zorlaşır. Gövdede bir koşul gerekiyorsa if deyimi değil, koşullu ifade (a if koşul else b) kullanılır. lambda: return 1 gibi bir deneme SyntaxError: invalid syntax verir.
Lambda'lar, iç içe tanımlanan fonksiyonlar gibi çevreleyen kapsamdaki değişkenlere erişebilir. Tutorial'daki örnek bir lambda döndüren bir fonksiyondur:
def artirici(n):
    return lambda x: x + n

f = artirici(42)
print(f(0), f(1)) # çıktı: 42 43sorted() ve list.sort()
Sıralama için iki araç vardır. list.sort() listeyi yerinde değiştirir ve karışıklığı önlemek için None döndürür; yalnızca listelerde vardır. sorted() ise herhangi bir yinelenebilirden yeni bir sıralı liste üretir ve kaynağa dokunmaz. Sorting Techniques belgesi, asıl listeye ihtiyacınız yoksa sort()'un biraz daha verimli olduğunu, ama çoğu durumda sorted()'ın daha kullanışlı olduğunu söyler.
sayilar = [5, 2, 3, 1, 4]
print(sorted(sayilar), sayilar)        # çıktı: [1, 2, 3, 4, 5] [5, 2, 3, 1, 4]
sonuc = sayilar.sort()
print(sonuc, sayilar)                  # çıktı: None [1, 2, 3, 4, 5]
print(sorted({'b': 1, 'a': 2}))        # çıktı: ['a', 'b']
print(sorted('python'))                # çıktı: ['h', 'n', 'o', 'p', 't', 'y']
print(sorted([3, 1, 2], reverse=True)) # çıktı: [3, 2, 1]
Sözlüğü sorted()'a verdiğinizde anahtarlar sıralanır; metin verdiğinizde karakterlerden oluşan bir liste gelir. sorted()'ın imzası sorted(iterable, /, *, key=None, reverse=False) şeklindedir: key ve reverse yalnızca adla verilebilir (bu işaretlerin anlamı için parametre türleri yazısına bakın). Listelerin diğer metotları liste metotları yazısında anlatılıyor.
key fonksiyonu: neye göre sıralanacağını söylemek
key parametresi tek argüman alan ve sıralamada kullanılacak değeri döndüren bir fonksiyon (veya çağrılabilir başka bir nesne) bekler. Belgelere göre bu teknik hızlıdır, çünkü key fonksiyonu her eleman için tam bir kez çağrılır. key'e bir lambda verebileceğiniz gibi len, str.casefold gibi hazır fonksiyonları da doğrudan verebilirsiniz; sonuna parantez koymazsınız, çünkü fonksiyonu çağırmıyor, kendisini veriyorsunuz.
ogrenciler = [('Zeynep', 'B', 17), ('Ali', 'A', 16), ('Can', 'B', 15)]
print(sorted(ogrenciler, key=lambda o: o[2]))
# çıktı: [('Can', 'B', 15), ('Ali', 'A', 16), ('Zeynep', 'B', 17)]

print(sorted(['elma', 'Armut', 'kiraz']))                    # çıktı: ['Armut', 'elma', 'kiraz']
print(sorted(['kiraz', 'Elma', 'armut'], key=str.casefold))  # çıktı: ['armut', 'Elma', 'kiraz']
print(sorted(['kiraz', 'üzüm', 'ay'], key=len))              # çıktı: ['ay', 'üzüm', 'kiraz']
Varsayılan sıralama metinleri karakter kodlarına göre karşılaştırır; büyük harfler küçüklerden önce gelir. Büyük/küçük harf duyarsız sıralama için belgelerin örneği key=str.casefold'dur.
Türkçe kelimeleri sıralamak
Karakter koduna göre sıralama Türkçe harflerde beklenmedik sonuç verir: ç, ı ve ş gibi harflerin kodları z'den büyük olduğu için bu harflerle başlayan kelimeler listenin sonuna gider. Belgeler, alfabetik sıranın kültüre göre değiştiğini belirtir ve yerel ayara duyarlı sıralama için locale.strxfrm()'u key fonksiyonu olarak önerir; bu yöntem sistemde ilgili yerel ayarın kurulu olmasına bağlıdır. Yerel ayara bağlı kalmadan basit bir çözüm, harflerin sırasını kendiniz tanımlayan bir key fonksiyonu yazmaktır:
meyveler = ['şeftali', 'armut', 'çilek', 'zeytin', 'ıhlamur', 'incir']
print(sorted(meyveler))
# çıktı: ['armut', 'incir', 'zeytin', 'çilek', 'ıhlamur', 'şeftali']

ALFABE = 'abcçdefgğhıijklmnoöprsştuüvyz'
SIRA = {harf: i for i, harf in enumerate(ALFABE)}

def tr_anahtar(kelime):
    return [SIRA.get(h, len(ALFABE) + ord(h)) for h in kelime]

print(sorted(meyveler, key=tr_anahtar))
# çıktı: ['armut', 'çilek', 'ıhlamur', 'incir', 'şeftali', 'zeytin']
Bu örnek yalnızca küçük harflerle çalışır. Büyük harfleri de hesaba katmak isterseniz önce küçük harfe çevirmeniz gerekir; ama 'I'.lower() Türkçedeki gibi ı değil i verir. Bu ve benzeri Türkçe karakter sorunları Unicode ve Türkçe karakter yazısında ele alınıyor.
operator modülü: itemgetter, attrgetter, methodcaller
lambda o: o[2] veya lambda u: u.fiyat gibi key fonksiyonları o kadar yaygındır ki Python bunlar için hazır araçlar sunar. Sorting Techniques belgesine göre operator.itemgetter(), attrgetter() ve methodcaller() bu erişimci fonksiyonları hem daha basit hem daha hızlı hâle getirir. Birden fazla argüman verdiğinizde bir demet döndürdükleri için çok seviyeli sıralamayı da kolaylaştırırlar.
from operator import itemgetter, attrgetter
from dataclasses import dataclass

ogrenciler = [('Zeynep', 'B', 17), ('Ali', 'A', 16), ('Can', 'B', 15)]
print(sorted(ogrenciler, key=itemgetter(2)))
# çıktı: [('Can', 'B', 15), ('Ali', 'A', 16), ('Zeynep', 'B', 17)]
print(sorted(ogrenciler, key=itemgetter(1, 2)))     # önce not, sonra yaş
# çıktı: [('Ali', 'A', 16), ('Can', 'B', 15), ('Zeynep', 'B', 17)]

@dataclass
class Urun:
    ad: str
    fiyat: float

urunler = [Urun('kalem', 12.5), Urun('defter', 30.0), Urun('silgi', 5.0)]
print([u.ad for u in sorted(urunler, key=attrgetter('fiyat'))])
# çıktı: ['silgi', 'kalem', 'defter']
methodcaller('replace', ' ', '_') ise her elemanda eleman.replace(' ', '_') çağıran bir fonksiyon üretir. dataclass kullanımı dataclasses yazısında anlatılıyor.
Kararlı sıralama ve karışık yönler
Python'un sıralaması kararlıdır (stable): Anahtarları eşit olan kayıtlar, girişteki sıralarını korur. Belgeler bu özelliğin, karmaşık sıralamaları birkaç adımda yapmayı mümkün kıldığını vurgular: Önce ikincil anahtara, sonra birincil anahtara göre sıralarsınız. Bir anahtarı azalan, diğerini artan sıralamak istediğinizde bu yöntem işe yarar. Sayısal anahtarlarda aynı sonuca tek adımda, anahtarın eksi işaretlisini kullanarak da ulaşabilirsiniz.
from operator import itemgetter

veri = [('kırmızı', 1), ('mavi', 1), ('kırmızı', 2), ('mavi', 2)]
print(sorted(veri, key=itemgetter(0)))
# çıktı: [('kırmızı', 1), ('kırmızı', 2), ('mavi', 1), ('mavi', 2)]

ogrenciler = [('Zeynep', 'B', 17), ('Ali', 'A', 16), ('Can', 'B', 15)]
# Nota göre azalan, yaşa göre artan: iki aşamada
adim1 = sorted(ogrenciler, key=itemgetter(2))
print(sorted(adim1, key=itemgetter(1), reverse=True))
# çıktı: [('Can', 'B', 15), ('Zeynep', 'B', 17), ('Ali', 'A', 16)]

# Yaşa göre azalan, eşitlikte ada göre artan: tek adımda
print(sorted(ogrenciler, key=lambda o: (-o[2], o[0])))
# çıktı: [('Zeynep', 'B', 17), ('Ali', 'A', 16), ('Can', 'B', 15)]
Demetlerin sözlük sırasıyla (önce ilk eleman, eşitse ikinci eleman) karşılaştırılması, key fonksiyonunun demet döndürmesini çok seviyeli sıralamanın en kısa yolu yapar. reverse=True da kararlılığı bozmaz: Eşit anahtarlı kayıtlar yine giriş sırasında kalır.
Sözlüğü değere göre sıralamak
Belgelerdeki son ipuçlarından biri, key fonksiyonunun sıralanan nesneye doğrudan bağlı olmak zorunda olmadığıdır; bir sözlükteki değerlere bakarak başka bir listeyi sıralayabilirsiniz. Aynı fikirle bir sözlüğü değerlerine göre sıralamak da kolaydır:
from operator import itemgetter

puanlar = {'Ali': 72, 'Ece': 91, 'Can': 85}
print(sorted(puanlar, key=puanlar.get, reverse=True))   # çıktı: ['Ece', 'Can', 'Ali']
print(sorted(puanlar.items(), key=itemgetter(1)))
# çıktı: [('Ali', 72), ('Can', 85), ('Ece', 91)]
print(dict(sorted(puanlar.items(), key=itemgetter(1), reverse=True)))
# çıktı: {'Ece': 91, 'Can': 85, 'Ali': 72}
Sözlükler eklenme sırasını koruduğu için sıralı items() listesini dict()'e vermek sıralı bir sözlük üretir. Sözlük işlemlerinin tamamı sözlük metotları yazısında.
min() ve max() ile key ve default
min() ve max() da key alır ve tam sıralama yapmadan, veriyi tek geçişte tarar. Boş bir yinelenebilir verildiğinde ValueError yükselir; bunu önlemek için yalnızca adla verilebilen default parametresi vardır. Belgelere göre birden fazla eleman en büyük (veya en küçük) ise ilk karşılaşılan döndürülür.
print(max(3, 7, 5))                          # çıktı: 7
print(max(['ay', 'su', 'ev'], key=len))      # çıktı: ay
print(min(['kiraz', 'üzüm', 'ay'], key=len)) # çıktı: ay
print(max([], default=None))                 # çıktı: None
try:
    max([])
except ValueError as e:
    print(e)                                 # çıktı: max() iterable argument is empty
map(): her elemana bir fonksiyon uygulamak
map(fonksiyon, yinelenebilir, ...), fonksiyonu her elemana uygulayan bir yineleyici döndürür. Birden fazla yinelenebilir verirseniz fonksiyon o kadar argüman almalıdır ve elemanlar paralel işlenir; en kısa yinelenebilir bittiğinde durur. Python 3.14 ile zip()'tekine benzer bir strict parametresi eklendi: strict=True iken uzunluklar farklıysa ValueError yükselir. Dönüş değeri bir liste değil, tembel bir map nesnesidir; sonuçlar ancak istendiğinde hesaplanır ve yineleyici bir kez tüketildikten sonra boş kalır.
print(list(map(str.upper, ['ankara', 'van'])))     # çıktı: ['ANKARA', 'VAN']
print(list(map(lambda x: x * 10, range(4))))       # çıktı: [0, 10, 20, 30]

m = map(int, ['1', '2', '3'])
print(type(m).__name__)                            # çıktı: map
print(list(m))                                     # çıktı: [1, 2, 3]
print(list(m))                                     # çıktı: []

print(list(map(pow, [2, 3, 4], [5, 2])))           # çıktı: [32, 9]
try:
    list(map(pow, [2, 3, 4], [5, 2], strict=True))
except ValueError as e:
    print(e)                                       # çıktı: map() argument 2 is shorter than argument 1
print(map(...)) yazarsanız sonuçları değil, <map object at 0x...> gibi bir gösterim görürsünüz; içeriği görmek için list()'e verin ya da bir döngüde dolaşın. Argümanları zaten demetler hâlinde duran veriler için itertools.starmap() vardır; itertools yazısına bakın.
filter(): koşulu sağlayan elemanları seçmek
filter(fonksiyon, yinelenebilir), fonksiyonun doğru döndürdüğü elemanları veren bir yineleyici üretir. Belgelere göre fonksiyon yerine None verirseniz yanlış sayılan bütün elemanlar (0, boş metin, boş liste, None) atılır. Tersini, yani koşulu sağlamayanları istiyorsanız itertools.filterfalse() kullanılır.
from itertools import filterfalse

print(list(filter(lambda x: x % 2 == 0, range(10))))       # çıktı: [0, 2, 4, 6, 8]
print(list(filter(None, [0, 1, '', 'a', None, [], [2]])))  # çıktı: [1, 'a', [2]]
print(list(filterfalse(lambda x: x % 2 == 0, range(10))))  # çıktı: [1, 3, 5, 7, 9]
map ve filter mi, comprehension mı?
Functional Programming HOWTO, map() ve filter()'ın generator ifadeleri ve list comprehension'larla aynı işi yaptığını açıkça söyler. Fonksiyon zaten hazırsa (str.strip, int gibi) map kısa ve okunaklıdır; lambda yazmanız gerekiyorsa comprehension çoğu zaman daha anlaşılırdır. Aşağıdaki son iki satır aynı sonucu verir, ama ilki tek bakışta okunur:
kelimeler = ['  elma ', 'armut  ', ' kiraz']
print(list(map(str.strip, kelimeler)))     # çıktı: ['elma', 'armut', 'kiraz']
print([k.strip() for k in kelimeler])      # çıktı: ['elma', 'armut', 'kiraz']

print([x * x for x in range(10) if x % 2 == 0])                              # çıktı: [0, 4, 16, 36, 64]
print(list(map(lambda x: x * x, filter(lambda x: x % 2 == 0, range(10)))))  # çıktı: [0, 4, 16, 36, 64]
Comprehension yazımı list comprehension yazısında ayrıntılı anlatılıyor.
functools.reduce ve operator fonksiyonları
operator modülü Python operatörlerinin fonksiyon karşılıklarını içerir: add, mul, lt, not_ gibi. Bunlar, tek bir işlem yapan küçük lambda'lar yazmaktan kurtarır. functools.reduce() bir diziyi soldan sağa iki elemanlık işlemle tek değere indirger. HOWTO ise reduce() kullanımlarının çoğunun bir for döngüsü ya da sum() gibi bir yerleşik fonksiyonla daha açık yazıldığını hatırlatır.
import operator
from functools import reduce

print(reduce(operator.add, [1, 2, 3, 4]))     # çıktı: 10
print(sum([1, 2, 3, 4]))                      # çıktı: 10
print(reduce(operator.mul, range(1, 6)))      # çıktı: 120
duzelt = operator.methodcaller('replace', ' ', '_')
print(list(map(duzelt, ['ad soyad', 'e posta'])))   # çıktı: ['ad_soyad', 'e_posta']
Python 3.15 belgelerindeki kullanımdan kaldırma (deprecation) listesine göre, functools.reduce()'un Python ile yazılmış sürümüne function veya sequence argümanlarını adla vermek Python 3.14'ten beri kullanımdan kaldırılmış durumda; bu argümanları her zaman konumla verin.
Eski tip karşılaştırma fonksiyonları: cmp_to_key
Key fonksiyonu her elemana mutlak bir sıralama değeri verir. Başka dillerden çevrilen algoritmalarda ise sık sık iki elemanı karşılaştıran bir fonksiyon görürsünüz: Birinci küçükse negatif, eşitse sıfır, büyükse pozitif değer döndürür. Python 3'te sorted() böyle bir fonksiyonu doğrudan kabul etmez; belgelerin önerdiği yol, onu functools.cmp_to_key() ile bir key fonksiyonuna sarmaktır. locale.strcoll() da bu türden bir karşılaştırma fonksiyonudur.
from functools import cmp_to_key

def uzunluk_karsilastir(a, b):
    return len(a) - len(b)        # negatif: a önce, pozitif: b önce

print(sorted(['kiraz', 'ay', 'elma'], key=cmp_to_key(uzunluk_karsilastir)))
# çıktı: ['ay', 'elma', 'kiraz']
Yeni kod yazıyorsanız aynı sonucu key=len ile çok daha kısa elde edersiniz; cmp_to_key yalnızca elinizde hazır bir karşılaştırma fonksiyonu olduğunda gerekir.
Karşılaştırılamayan değerleri sıralamak
Sıralama elemanları < ile karşılaştırır. Farklı tipleri (örneğin metin ve sayı) karşılaştırmak çoğu zaman TypeError verir. Belgeler birkaç strateji önerir: girdileri sıralamadan önce ortak bir tipe çevirmek, None ve NaN gibi özel değerleri önceden ayıklamak.
veri = ['10', 9, '8']
try:
    sorted(veri)
except TypeError as e:
    print(e)                                  # çıktı: '<' not supported between instances of 'int' and 'str'
print(sorted(veri, key=int))                  # çıktı: ['8', 9, '10']

olcumler = [3.3, None, 1.1, 2.2]
print(sorted(x for x in olcumler if x is not None))   # çıktı: [1.1, 2.2, 3.3]
lambda mı, def mi?
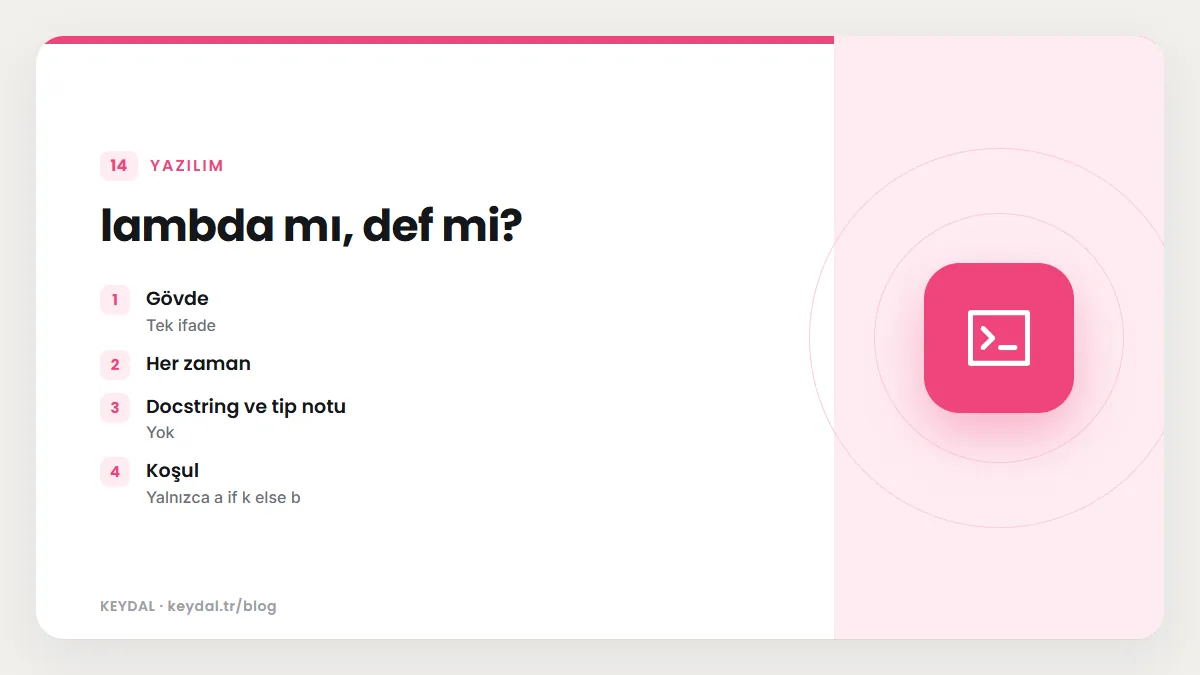
| Özellik | lambda | def |
|---|---|---|
| Gövde | Tek ifade | Birden çok deyim |
| Ad | Her zaman <lambda> | Verilen ad |
| Docstring ve tip notu | Yok | Var |
| Koşul | Yalnızca a if k else b | if/elif/else, try, döngü |
| Uygun kullanım | key= gibi kısa, tek kullanımlık fonksiyon | Tekrar kullanılan veya açıklama gerektiren mantık |
HOWTO'nun yazarı kendi tercihinin lambda'dan kaçınmak olduğunu söyler ve Fredrik Lundh'un önerdiği bir yöntemi aktarır: Lambda'yı yazın, ne yaptığını anlatan bir yorum ekleyin, yorumu özetleyen bir ad bulun, lambda'yı o adla bir def'e çevirin ve yorumu silin. Yani bir lambda'yı anlamak için yorum gerekiyorsa, adı olan bir fonksiyon olması daha iyidir.
Sık yapılan hatalar
- liste = liste.sort() yazmak:
sort()Nonedöndürür, listeniz kaybolur. Ya yalnızcaliste.sort()ya daliste = sorted(liste)yazın. - key'e çağrı sonucu vermek:
key=len()veyakey=str.lower()yanlıştır; fonksiyonun kendisini verin:key=len. - map/filter sonucunu liste sanmak: Sonuç tembel bir yineleyicidir; ikinci kez dolaşırsanız boş gelir.
- Türkçe kelimeleri varsayılan sırayla sıralamak:
ç, ı, şgibi harfler sona gider; özel bir key fonksiyonu kullanın. - Boş listede max() çağırmak:
ValueErroralırsınız;default=verin. - Uzun lambda yazmak: Okunamayan tek satırlık bir ifade yerine adı olan bir
defyazın.
Sık Sorulan Sorular
sorted() ile sort() arasındaki fark nedir?
sorted() her yinelenebilirden yeni bir liste döndürür ve kaynağı değiştirmez. list.sort() yalnızca listelerde vardır, listeyi yerinde sıralar ve None döndürür.
Birden fazla alana göre nasıl sıralarım?
Key fonksiyonunun demet döndürmesini sağlayın (key=itemgetter(1, 2) veya key=lambda o: (o.not_, o.yas)). Yönler farklıysa sıralamanın kararlılığından yararlanıp önce ikincil, sonra birincil anahtara göre sıralayın.
lambda içinde if kullanabilir miyim?
if deyimini kullanamazsınız, ama koşullu ifadeyi kullanabilirsiniz: lambda n: 'çift' if n % 2 == 0 else 'tek'.
map() neden liste döndürmüyor?
map() ve filter() tembel yineleyiciler döndürür; sonuçlar ancak istendiğinde hesaplanır. Liste gerekiyorsa list(map(...)) yazın.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: Python öğrenme rehberi · def ile fonksiyon tanımlama · List comprehension · Liste metotları · itertools ve functools · Kapsam ve closure · Sözlük metotları