Python 3'te metin (str) Unicode karakterlerden, ham veri (bytes) ise 0-255 arası baytlardan oluşur; ikisi arasındaki köprü encode() ve decode() metotlarıdır. Türkçe karakter sorunlarının neredeyse tamamı bu köprüde yanlış kodlama seçilmesinden doğar: UTF-8 ile yazılmış bir dosyayı cp1254 sanmak ya da tersi. İkinci büyük kaynak ise Türkçenin noktalı ve noktasız i harfleridir; 'I'.lower() ifadesi Unicode'un varsayılan kuralına göre 'i' verir, 'ı' değil.
Bu yazıda Unicode kavramlarını kısaca tanımlıyor, str ve bytes farkını, kodlama hata işleyicilerini, eski Türkçe kod sayfalarını, dosyalarda BOM konusunu, İ/ı dönüşümünü, normalizasyonu, unicodedata modülünü ve düzenli ifadelerdeki tuzakları çalışan örneklerle anlatıyoruz. Tüm çıktılar Python 3.15.2 ile, Türkçe yerel ayarlı bir Windows bilgisayarda alındı. 3.15 ile varsayılan kodlamanın UTF-8 olmasının etkisini de ayrıca ele alıyoruz.
Temel kavramlar: kod noktası ve kodlama
Unicode her karaktere kod noktası (code point) adı verilen bir sayı atar ve bu sayı genellikle U+011F biçiminde onaltılık yazılır; ğ harfinin kod noktası budur. Kod noktası soyut bir sayıdır; diske yazmak ya da ağ üzerinden göndermek için bu sayıların bayt dizisine çevrilmesi gerekir. Bu çeviri kuralına kodlama (encoding) denir. UTF-8, UTF-16 ve eski cp1254 farklı kodlamalardır; aynı metin her birinde farklı baytlar üretir.
Unicode HOWTO belgesi UTF-8'in neden yaygınlaştığını birkaç özelliğiyle açıklar: tüm Unicode kod noktalarını gösterebilir, ASCII metin UTF-8'de de aynı baytlarla kalır, bayt sırası (endianness) sorunu yoktur ve bozulmuş bir dizinin ortasından bir sonraki karakterin başlangıcı bulunabilir. Python kaynak dosyalarının varsayılan kodlaması da UTF-8'dir; bu yüzden kodda 'Güneş' yazmak için ek bir ayara gerek yoktur.
str ve bytes farkı
len() bir metinde karakter sayısını, bir bayt nesnesinde bayt sayısını verir. UTF-8'de ASCII harfleri 1 bayt, ü ve ş gibi harfler 2 bayt tutar:
metin = 'Güneş'
veri = metin.encode('utf-8')

print(type(metin), len(metin))
# çıktı: <class 'str'> 5
print(type(veri), len(veri))
# çıktı: <class 'bytes'> 7
print(veri)
# çıktı: b'G\xc3\xbcne\xc5\x9f'
print(veri.decode('utf-8'))
# çıktı: Güneş
print([hex(ord(c)) for c in 'ğşı'])
# çıktı: ['0x11f', '0x15f', '0x131']
ord() bir karakterin kod noktasını, chr() bir kod noktasının karakterini verir. bytes gösteriminde ASCII dışındaki baytlar \xNN biçiminde görünür. HOWTO belgesinin en önemli tavsiyesi şudur: program içinde yalnızca str ile çalışın, girdiyi olabildiğince erken çözün (decode), çıktıyı olabildiğince geç kodlayın (encode). İkisini karıştırmak otomatik dönüşüm yapmaz, hata verir:
print('a' + b'b')
# Traceback (most recent call last):
#   File "ornek.py", line 1, in <module>
#     print('a' + b'b')
#           ~~~~^~~~~~
# TypeError: can only concatenate str (not "bytes") to str
encode, decode ve hata işleyicileri
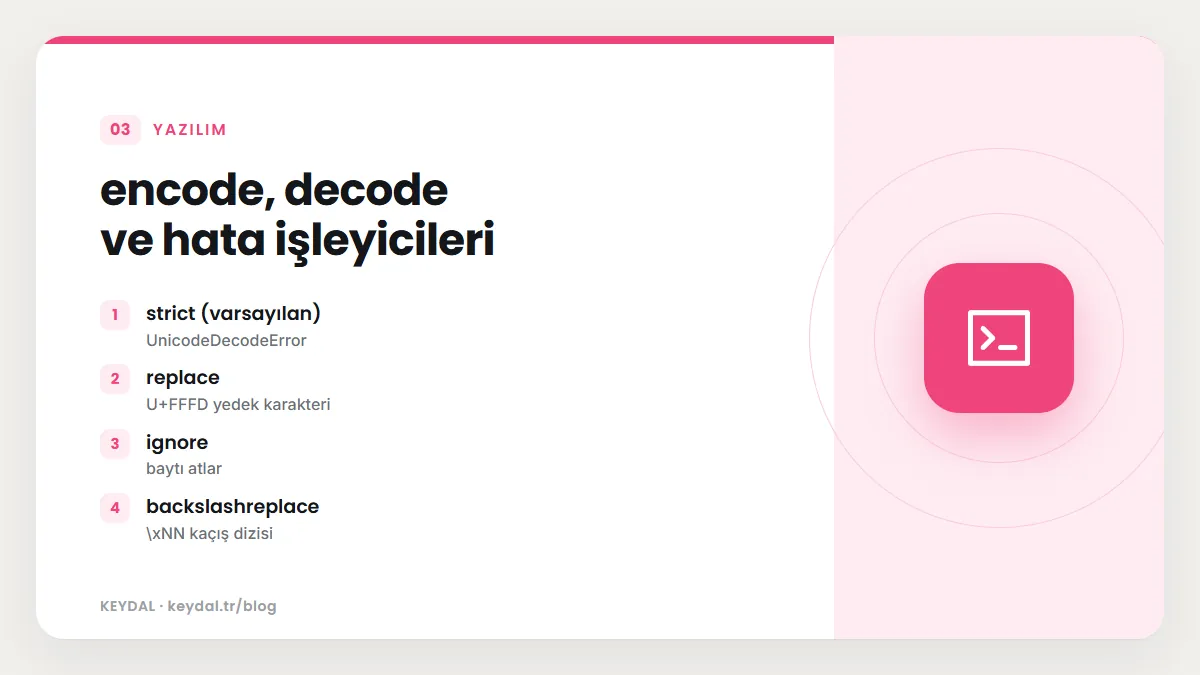
str.encode() ve bytes.decode() metotlarının varsayılan kodlaması 'utf-8', varsayılan hata modu 'strict' olur. Katı modda çevrilemeyen bir karakter ya da çözülemeyen bir bayt görüldüğünde UnicodeEncodeError veya UnicodeDecodeError fırlatılır; ikisi de ValueError sınıfından türeyen UnicodeError sınıfının alt sınıfıdır.
En sık görülen senaryo, cp1254 ile kaydedilmiş eski bir metni UTF-8 sanarak okumaktır. cp1254'te Ç harfi tek bayttır (0xC7); UTF-8 çözücüsü bu baytı iki baytlık bir karakterin başlangıcı sanar, arkasından uygun bir devam baytı gelmeyince hata verir:
eski = 'Çağrı Şükrü'.encode('cp1254')
print(eski)
# çıktı: b'\xc7a\xf0r\xfd \xde\xfckr\xfc'
print(eski.decode('cp1254'))
# çıktı: Çağrı Şükrü
print(eski.decode('utf-8'))
# Traceback (most recent call last):
#   File "ornek.py", line 6, in <module>
#     print(eski.decode('utf-8'))
#           ~~~~~~~~~~~^^^^^^^^^
# UnicodeDecodeError: 'utf-8' codec can't decode byte 0xc7 in position 0: invalid continuation byte
Kodlamayı bildiğiniz sürece çözüm basittir: doğru kodlamayla çözün. Bilmediğiniz ya da bozuk veriyle karşılaştığınızda errors parametresi davranışı belirler. UnicodeError nesnesinin encoding, start, end ve reason öznitelikleri sorunun yerini gösterir:
bozuk = 'Işık'.encode('cp1254')

for hata in ('replace', 'ignore', 'backslashreplace'):
    print(hata, repr(bozuk.decode('utf-8', errors=hata)))
# çıktı: replace 'I��k'
# çıktı: ignore 'Ik'
# çıktı: backslashreplace 'I\\xfe\\xfdk'

try:
    bozuk.decode('utf-8')
except UnicodeDecodeError as e:
    print(e.encoding, e.start, e.end, e.reason)
# çıktı: utf-8 1 2 invalid start byte
replace çözülemeyen her bayt yerine U+FFFD yedek karakterini (genellikle soru işaretli bir kare olarak görünür) koydu; ignore baytları sessizce attı ve "Işık" kelimesi "Ik" oldu. Bu yüzden ignore veri kaybına yol açar; yalnızca kaybın kabul edilebilir olduğu yerlerde kullanın. Kodlama yönünde ek işleyiciler de vardır:
metin = 'Fiyat: 50€ - Şube'
print(metin.encode('ascii', errors='replace'))
# çıktı: b'Fiyat: 50? - ?ube'
print(metin.encode('ascii', errors='xmlcharrefreplace'))
# çıktı: b'Fiyat: 50€ - Şube'
print(metin.encode('ascii', errors='backslashreplace'))
# çıktı: b'Fiyat: 50\\u20ac - \\u015eube'
print(metin.encode('ascii', errors='namereplace'))
# çıktı: b'Fiyat: 50\\N{EURO SIGN} - \\N{LATIN CAPITAL LETTER S WITH CEDILLA}ube'
metin.encode('ascii')
# UnicodeEncodeError: 'ascii' codec can't encode character '\u20ac' in position 9: ordinal not in range(128)| Hata modu | decode | encode |
|---|---|---|
| strict (varsayılan) | UnicodeDecodeError | UnicodeEncodeError |
| replace | U+FFFD yedek karakteri | soru işareti |
| ignore | baytı atlar | karakteri atlar |
| backslashreplace | \xNN kaçış dizisi | \uNNNN kaçış dizisi |
| xmlcharrefreplace | yok | &#NNNN; XML karakter referansı |
| namereplace | yok | \N{AD} kaçış dizisi |
| surrogateescape | baytı U+DC80-U+DCFF aralığına taşır | aynı baytları geri üretir |
surrogateescape, HOWTO belgesinde kodlaması bilinmeyen ama ASCII uyumlu olduğu bilinen bir dosyanın yalnızca ASCII kısımlarını değiştirip baytları bozmadan geri yazmak için önerilir.
Eski Türkçe kodlamalar
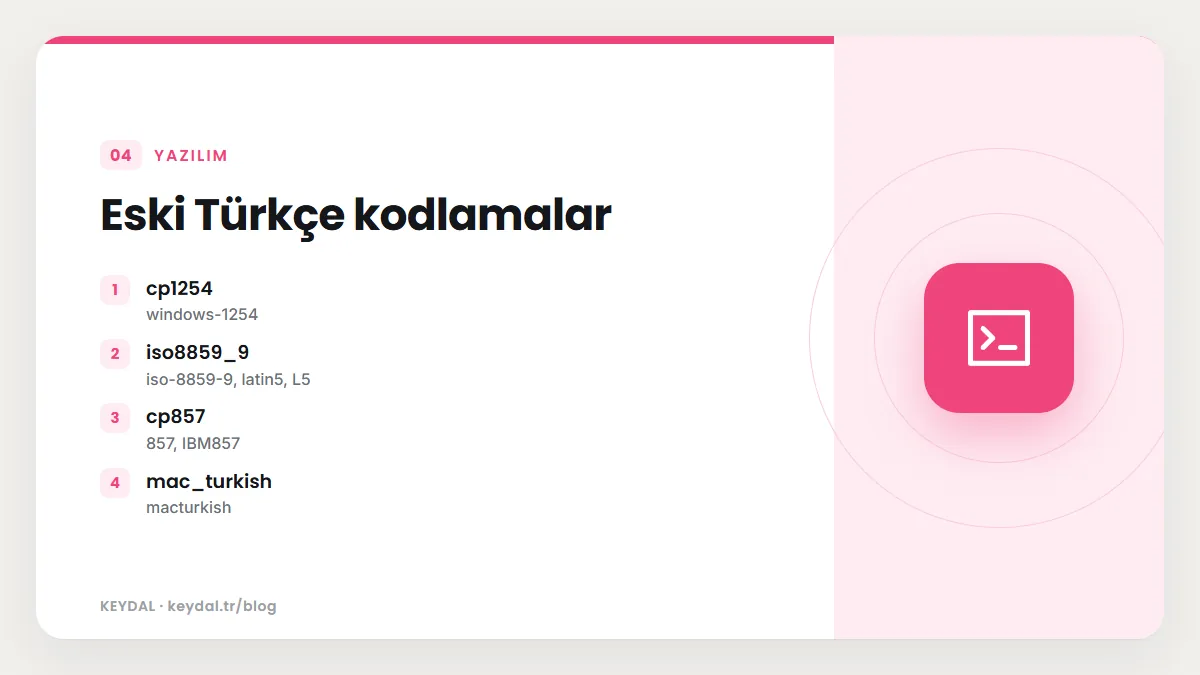
UTF-8 öncesinden kalan dosyalar, eski veritabanı dökümleri ya da bazı Windows programlarının ürettiği CSV dosyaları hâlâ Türkçeye özel kod sayfalarıyla karşınıza çıkabilir. codecs modülünün standart kodlama tablosunda Türkçe için şu kodlamalar listelenir:
| Kodlama | Takma adlar | Nerede görülür |
|---|---|---|
| cp1254 | windows-1254 | Türkçe Windows uygulamaları |
| iso8859_9 | iso-8859-9, latin5, L5 | Eski Unix ve web sayfaları |
| cp857 | 857, IBM857 | DOS dönemi komut satırı |
| mac_turkish | macturkish | Eski Mac uygulamaları |
| utf_8_sig | utf-8-sig | Başında BOM olan UTF-8 dosyalar |
Kodlama adları büyük küçük harf, tire ve alt çizgi farkına duyarsızdır; 'utf-8' ve 'UTF_8' aynı kodlamayı gösterir. Bir dosyanın kodlaması bilinmiyorsa en sağlam yol veriyi üreten taraftan öğrenmektir; tahmine dayalı çözümleme Türkçe gibi dillerde yanlış sonuç verebilir.
Dosyalarda kodlama ve BOM
open() fonksiyonunun encoding ve errors parametreleri, encode ve decode ile aynı şekilde çalışır ve parça parça okurken bir karakterin baytlarının iki okumaya bölünmesi gibi ayrıntıları sizin yerinize halleder. Bu yüzden HOWTO belgesi elle bayt okuyup çözmek yerine metin modunda dosya açmayı önerir.
Python 3.15 ile encoding verilmediğinde kullanılan varsayılan kodlama, işletim sisteminin yerel ayarından bağımsız olarak UTF-8 oldu (PEP 686). Aşağıdaki çıktılar bunu gösteriyor: Windows'un yerel kodlaması cp1254, ama Python'un tercih ettiği kodlama UTF-8:
import sys, locale

print(sys.getfilesystemencoding())
# çıktı: utf-8
print(sys.flags.utf8_mode)
# çıktı: 1
print(locale.getpreferredencoding(False))
# çıktı: utf-8
print(locale.getencoding())
# çıktı: cp1254
Yine de sürüm notları, farklı Python sürümleriyle uyumlu kalmak için encoding değerini her zaman açıkça yazmayı önerir. Eski sistemin kod sayfasını bilerek kullanmak isterseniz encoding='locale' yazabilirsiniz. Ayrıntılar Python 3.15 yenilikleri ve dosya okuma yazma yazılarında.
BOM (byte order mark), U+FEFF karakterinin dosyanın başına yazılmasıdır. UTF-8'de bayt sırası olmadığı için gerekmez, ama bazı programlar dosyanın UTF-8 olduğunu belirtmek için ekler. Bu dosyayı düz utf-8 ile okursanız ilk satırın başında görünmez bir \ufeff karakteri kalır ve örneğin CSV başlığındaki ilk sütun adı eşleşmez. utf-8-sig kodlaması BOM varsa okurken atlar, yazarken ekler:
with open('bomlu.txt', 'w', encoding='utf-8-sig') as f:
    f.write('ad;soyad\n')

with open('bomlu.txt', 'rb') as f:
    print(f.read()[:5])
# çıktı: b'\xef\xbb\xbfad'
with open('bomlu.txt', encoding='utf-8') as f:
    print(repr(f.readline()))
# çıktı: '\ufeffad;soyad\n'
with open('bomlu.txt', encoding='utf-8-sig') as f:
    print(repr(f.readline()))
# çıktı: 'ad;soyad\n'
Excel ile açılacak noktalı virgüllü Türkçe CSV dosyalarında bu kodlamanın pratik kullanımını csv modülü yazısında bulabilirsiniz.
Türkçe İ ve ı sorunu
str.lower() ve str.upper(), Unicode Standardı'nın "varsayılan büyük küçük harf dönüşümü" bölümündeki algoritmayı uygular. Bu algoritma dilden bağımsızdır ve Türkçenin dört i harfi için beklediğimiz eşleşmeyi yapmaz:
print('I'.lower())
# çıktı: i
print('i'.upper())
# çıktı: I
print('ı'.upper())
# çıktı: I
kucuk = 'İ'.lower()
print(kucuk, len(kucuk), [hex(ord(c)) for c in kucuk])
# çıktı: i̇ 2 ['0x69', '0x307']
print('İSTANBUL'.lower() == 'istanbul')
# çıktı: False
print('ıiIİ'.casefold())
# çıktı: ıiii̇
Sonuçları tek tek okuyalım. Noktasız büyük I küçültüldüğünde Türkçe kurala göre ı olmalıyken i oldu. Noktalı küçük i büyütüldüğünde İ yerine I oldu. Noktalı büyük İ ise küçültüldüğünde iki kod noktasına dönüştü: düz i ve U+0307 birleştirici üst nokta. Bu yüzden 'İSTANBUL'.lower() sonucu görünüşte "istanbul" olsa da uzunluğu 9 karakterdir ve 'istanbul' ile eşit değildir. casefold() da aynı varsayılan kurala dayanır; ß harfini "ss" yapmak gibi dönüşümleri vardır ama Türkçe i kuralını uygulamaz.
Python'un standart kütüphanesinde Türkçe kurallı bir lower() yoktur. Pratik bir çözüm, dönüşümden önce yalnızca iki sorunlu harfi str.translate() ile elle eşlemektir:
BUYUK = str.maketrans({'i': 'İ', 'ı': 'I'})
KUCUK = str.maketrans({'I': 'ı', 'İ': 'i'})

def tr_upper(s):
    return s.translate(BUYUK).upper()

def tr_lower(s):
    return s.translate(KUCUK).lower()

print(tr_upper('istanbul ılgaz'))
# çıktı: İSTANBUL ILGAZ
print(tr_lower('İSTANBUL ILGAZ'))
# çıktı: istanbul ılgaz
print(tr_lower('DİYARBAKIR') == 'diyarbakır')
# çıktı: TrueAynı görünen ama eşit olmayan metinler: normalizasyon
Unicode'da bazı karakterler iki farklı biçimde yazılabilir. Ş harfi tek bir kod noktası (U+015E) olabileceği gibi, S harfi ve ardından gelen birleştirici çengel işareti (U+0327) olarak da yazılabilir. Ekranda aynı görünürler ama Python için farklı metinlerdir. Özellikle macOS dosya sistemlerinden, kopyala yapıştır işlemlerinden ya da farklı klavye düzenlerinden gelen metinlerde bu duruma rastlanabilir. unicodedata.normalize() metni dört normal biçimden birine çevirir: birleşik biçim NFC, ayrıştırılmış biçim NFD ve uyumluluk dönüşümlü NFKC ile NFKD.
import unicodedata

birlesik = 'S\u0327'          # S + birleştirici çengel (U+0327)
hazir = 'Ş'
print(birlesik, hazir, birlesik == hazir)
# çıktı: Ş Ş False
print(len(birlesik), len(hazir))
# çıktı: 2 1

nfc = unicodedata.normalize('NFC', birlesik)
print(nfc == hazir, len(nfc))
# çıktı: True 1
print(len(unicodedata.normalize('NFD', 'Şişli')))
# çıktı: 7
for c in unicodedata.normalize('NFD', 'ğ'):
    print(hex(ord(c)), unicodedata.name(c))
# çıktı: 0x67 LATIN SMALL LETTER G
# çıktı: 0x306 COMBINING BREVE
Kullanıcıdan gelen metinleri karşılaştırmadan ya da veritabanına yazmadan önce tek bir biçime (genellikle NFC) normalleştirmek bu tür görünmez farkları ortadan kaldırır. HOWTO belgesi büyük küçük harf duyarsız karşılaştırma için NFD(NFD(s).casefold()) kalıbını verir; ancak yukarıda gördüğümüz gibi bu kalıp da Türkçe i kuralını uygulamaz.
unicodedata ile karakter bilgisi
unicodedata modülü Unicode Karakter Veritabanı'na erişim sağlar. name() karakterin resmî adını, category() iki harfli genel kategorisini (Ll küçük harf, Lu büyük harf, Sc para simgesi, So diğer simge gibi), lookup() addan karakteri verir. Python 3.15 ile veritabanı Unicode 17.0.0 sürümüne güncellendi ve karakterin ait olduğu bloğu döndüren block() fonksiyonu eklendi.
import unicodedata

for c in 'ğİ€😀':
    print(c, hex(ord(c)), unicodedata.category(c), unicodedata.name(c))
# çıktı: ğ 0x11f Ll LATIN SMALL LETTER G WITH BREVE
# çıktı: İ 0x130 Lu LATIN CAPITAL LETTER I WITH DOT ABOVE
# çıktı: € 0x20ac Sc EURO SIGN
# çıktı: 😀 0x1f600 So GRINNING FACE
print(unicodedata.lookup('LATIN SMALL LETTER DOTLESS I'))
# çıktı: ı
print('\N{LATIN CAPITAL LETTER I WITH DOT ABOVE}')
# çıktı: İ
len() kod noktası sayar; kullanıcının tek karakter olarak gördüğü birim (grafem kümesi) birden çok kod noktasından oluşabilir. Bayrak emojisi iki bölgesel gösterge harfinden, birleştirici işaretli bir harf iki kod noktasından oluşur. 3.15 ile gelen iter_graphemes(), metni Unicode Standart Eki 29'daki kurallara göre kullanıcı karakterlerine böler:
import unicodedata

bayrak = '🇹🇷'
aile = 'a\u0301b'
print(len(bayrak), len(aile))
# çıktı: 2 3
print([str(g) for g in unicodedata.iter_graphemes(bayrak + aile)])
# çıktı: ['🇹🇷', 'á', 'b']
print(unicodedata.block('ş'), '|', unicodedata.block('😀'))
# çıktı: Latin Extended-A | Emoticons
Kullanıcı adı ya da tweet uzunluğu gibi "ekranda görünen karakter sayısı" sınırlarını uygularken bu ayrım önemlidir: len() ile kesmek bir emojiyi ya da bir harfin aksanını ortasından bölebilir.
Düzenli ifadelerde Türkçe harfler
re modülünde str desenleri varsayılan olarak Unicode kurallarıyla eşleşir: \w ç, ğ, ş gibi harfleri kapsar. re.ASCII bayrağı verilirse \w yalnızca İngilizce harf, rakam ve alt çizgiyle sınırlanır. Belgelerin özellikle belirttiği bir ayrıntı da şudur: [a-z] ya da [A-Z] deseni IGNORECASE ile birlikte kullanıldığında 52 ASCII harfin yanında İ (U+0130), ı (U+0131), ſ (U+017F) ve Kelvin işareti (U+212A) ile de eşleşir. Ş ve Ğ gibi harfler bu sınıfa girmez.
import re

print(re.findall(r'[a-z]+', 'Işık', re.IGNORECASE))
# çıktı: ['I', 'ık']
print(re.findall(r'[a-z]+', 'Işık', re.IGNORECASE | re.ASCII))
# çıktı: ['I', 'k']
print(re.findall(r'\w+', 'çağ 2026', re.ASCII))
# çıktı: ['a', '2026']
print(re.findall(r'\w+', 'çağ 2026'))
# çıktı: ['çağ', '2026']
Türkçe kelimeleri yakalamak istiyorsanız [a-z] yerine \w ya da harfleri açıkça listeleyen bir sınıf ([a-zçğıöşü]) kullanın. Modülün geri kalanı için Python re modülü yazısına bakabilirsiniz.
Sık yapılan hatalar
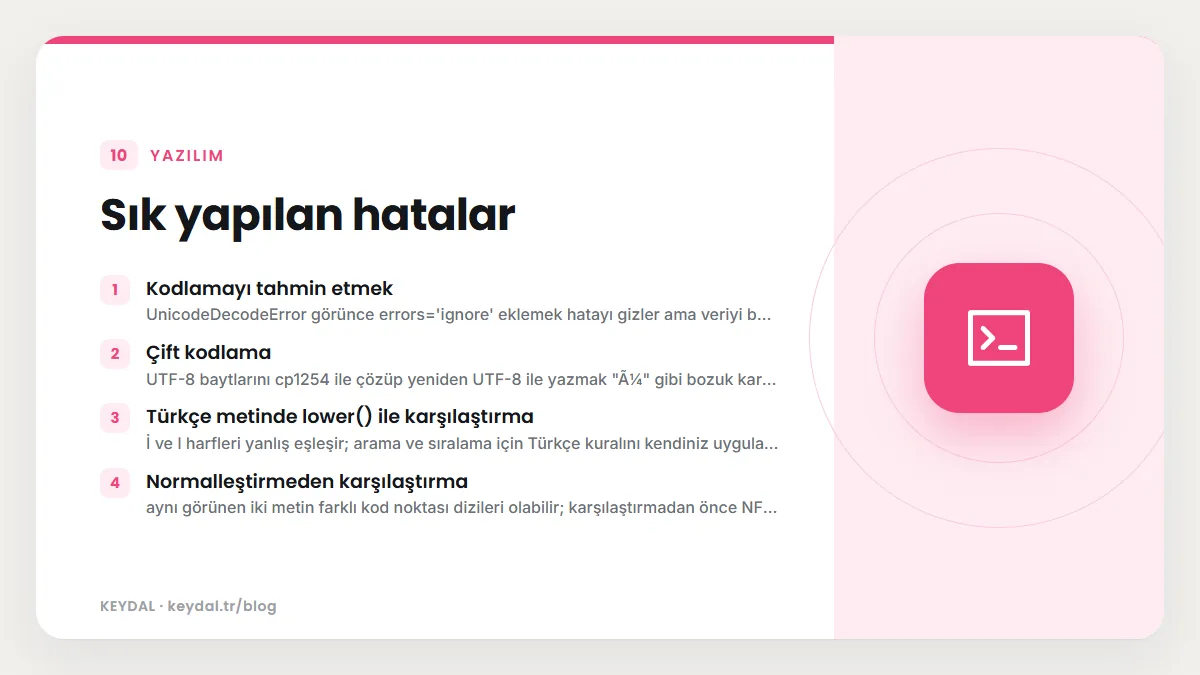
- Kodlamayı tahmin etmek:
UnicodeDecodeErrorgörünceerrors='ignore'eklemek hatayı gizler ama veriyi bozar. Önce verinin gerçek kodlamasını bulun. - Çift kodlama: UTF-8 baytlarını cp1254 ile çözüp yeniden UTF-8 ile yazmak "ü" gibi bozuk karakterler üretir. Okuma ve yazmada aynı, doğru kodlamayı kullanın.
- Türkçe metinde
lower()ile karşılaştırma: İ ve I harfleri yanlış eşleşir; arama ve sıralama için Türkçe kuralını kendiniz uygulayın. - Normalleştirmeden karşılaştırma: aynı görünen iki metin farklı kod noktası dizileri olabilir; karşılaştırmadan önce NFC uygulayın.
len()ile görünen karakter sayısını ölçmek: emoji ve birleştirici işaretlerde yanlış sonuç verir.- BOM'u unutmak: Windows araçlarından gelen dosyalarda ilk satırdaki
\ufeffbaşlık eşleşmesini bozar;utf-8-sigile okuyun.
Sık Sorulan Sorular
UnicodeDecodeError: 'utf-8' codec can't decode byte hatası neden olur?
Okunan baytlar UTF-8 kurallarına uymuyor demektir; çoğunlukla dosya cp1254 ya da iso8859_9 gibi başka bir kodlamayla yazılmıştır. Dosyayı open(yol, encoding='cp1254') ile açmayı deneyin. Hata yakalama ayrıntıları için try/except rehberine bakın.
Python'da Türkçe karakter kullanmak için dosyanın başına coding satırı yazmalı mıyım?
Hayır. Kaynak dosyaların varsayılan kodlaması UTF-8 olduğundan editörünüz dosyayı UTF-8 kaydediyorsa ek satıra gerek yoktur. # -*- coding: ... -*- satırı yalnızca kaynak dosya başka bir kodlamayla kaydedilmişse gerekir.
casefold() ile lower() arasındaki fark nedir?
casefold() büyük küçük harf ayrımını tamamen kaldırmak için tasarlanmıştır ve lower() metodundan daha "agresiftir"; belgelerdeki örnekte Almanca ß harfini "ss" yapar. Büyük küçük harf duyarsız karşılaştırmada önerilen budur, ancak Türkçe i kuralını o da uygulamaz.
Konsolda Türkçe karakterler bozuk görünüyor, ne yapmalıyım?
Python 3.15 UTF-8 modunda çalıştığı için standart akışlar UTF-8 kullanır. Bozulma genellikle çıktıyı okuyan terminalin ya da yönlendirilen programın başka bir kodlama beklemesinden kaynaklanır. Python tarafında PYTHONIOENCODING ortam değişkeniyle standart akışların kodlaması değiştirilebilir; ayrıntılar Command line and environment sayfasında.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: Python öğrenme rehberi · String metotları · Dosya okuma yazma · csv modülü · re modülü · Python 3.15 yenilikleri