List comprehension, bir yinelenebilirin her elemanına bir ifade uygulayarak (ve isterseniz bir koşulla süzerek) tek satırda yeni bir liste oluşturan Python söz dizimidir: [x ** 2 for x in range(10)]. Aynı yapının süslü parantezli biçimleri küme ({x for x in ...}) ve sözlük ({k: v for k, v in ...}) üretir; normal parantezli biçimi ise liste yerine değerleri tek tek üreten bir generator ifadesidir. Python 3.15 bu ailenin tamamına * ve ** ile açma (unpacking) desteği ekledi.
Bu yazıda comprehension'ın denk geldiği for döngüsünü, filtreleme ile koşullu ifade arasındaki farkı, birden çok for içeren ve iç içe comprehension'ları, dict ve set comprehension'ı, generator ifadelerinin tembel (lazy) davranışını, kapsam kurallarını ve 3.15'teki PEP 798 yeniliğini Python 3.15.2 ile çalıştırılmış örneklerle anlatıyoruz. Temel döngüler için for ve while döngüleri, genel öğrenme sırası için Python öğrenme rehberi sayfasına bakabilirsiniz.
Temel söz dizimi ve denk döngü
Bir list comprehension köşeli parantez içinde önce bir ifade, ardından bir for cümleciği ve isteğe bağlı olarak başka for veya if cümleciklerinden oluşur. for cümleciğinin söz dizimi bir for döngüsünün başlığıyla aynıdır, yalnızca sonda iki nokta yoktur. Dil başvuru belgesi, çalışma anında comprehension'ın kabaca bir sonuç listesi oluşturup döngüde her elemanı ekleyen küçük bir fonksiyon tanımlayıp çağırmaya denk olduğunu anlatır. Aşağıdaki iki kod aynı listeyi üretir:
kareler = []
for x in range(10):
    kareler.append(x ** 2)
print(kareler)   # çıktı: [0, 1, 4, 9, 16, 25, 36, 49, 64, 81]

kareler2 = [x ** 2 for x in range(10)]
print(kareler == kareler2)   # çıktı: True
Tutorial'daki önemli bir gözlem: normal for döngüsü x adında bir değişken oluşturur (ya da var olanın üzerine yazar) ve bu değişken döngü bittikten sonra da yaşar. Comprehension ise ayrı, örtük olarak iç içe geçmiş bir kapsamda çalışır; hedef değişken dışarı "sızmaz". Bu, comprehension'ı yan etkisiz ve daha öngörülebilir kılar.
for x in range(3):
    pass
print(x)            # çıktı: 2

x = 'eski değer'
kareler = [x ** 2 for x in range(5)]
print(x)            # çıktı: eski değer
print(kareler)      # çıktı: [0, 1, 4, 9, 16]
En sık kullanılan kalıplar şunlardır: her elemanı dönüştürmek, belirli elemanları seçmek, her elemana bir fonksiyon ya da metot uygulamak ve elemanlardan çiftler (tuple) üretmek. Tutorial, aynı listeyi list(map(lambda x: x**2, range(10))) ile üreten biçime kıyasla comprehension'ı daha kısa ve okunaklı bulur; map() ve filter() fonksiyonları lambda, map ve filter yazısında.
vec = [-4, -2, 0, 2, 4]
print([x * 2 for x in vec])        # çıktı: [-8, -4, 0, 4, 8]
print([x for x in vec if x >= 0])  # çıktı: [0, 2, 4]
print([abs(x) for x in vec])       # çıktı: [4, 2, 0, 2, 4]

meyveler = ['  muz', '  ayva ', 'çilek  ']
print([m.strip() for m in meyveler])      # çıktı: ['muz', 'ayva', 'çilek']
print([(x, x ** 2) for x in range(4)])    # çıktı: [(0, 0), (1, 1), (2, 4), (3, 9)]
Filtre (if) ile koşullu ifade (if-else) farkı
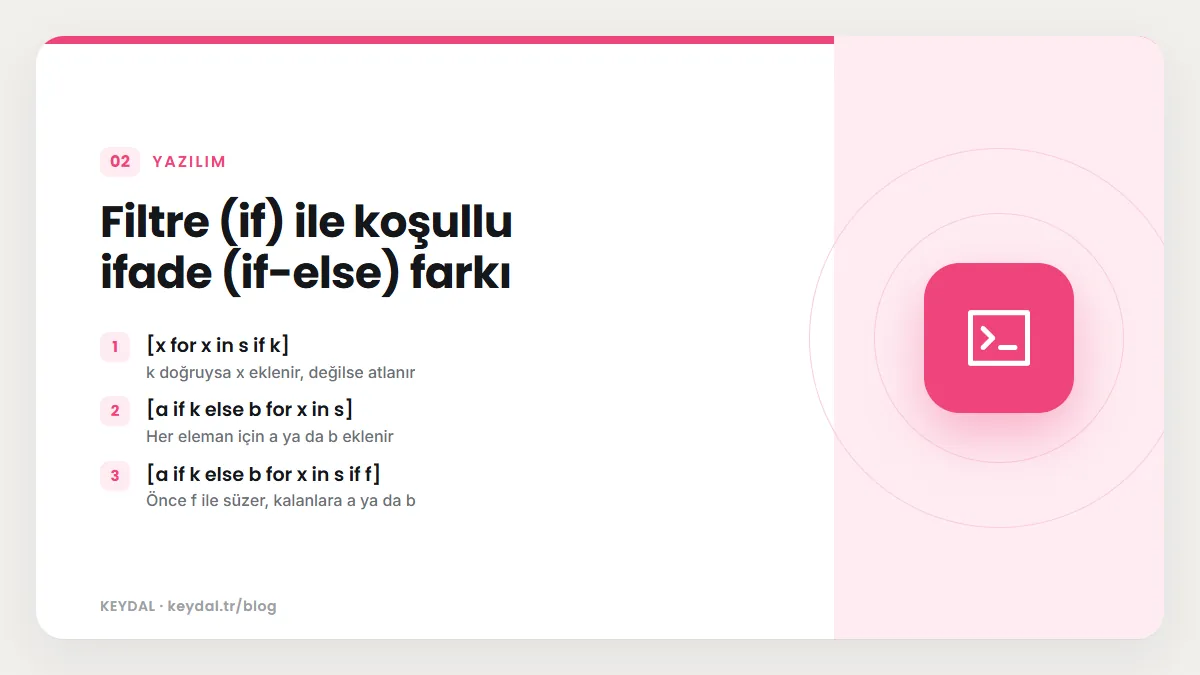
Yeni başlayanların en çok karıştırdığı konu if'in nerede durduğudur. Sondaki if bir filtredir: koşul yanlışsa eleman sonuca hiç eklenmez, bu yüzden else alamaz. Başa, ifadenin içine yazılan A if koşul else B ise bir koşullu ifadedir: her eleman için sonuca bir değer eklenir, koşul yalnızca hangi değerin ekleneceğini belirler; burada else zorunludur. İkisini birlikte de kullanabilirsiniz. Koşullu ifadenin kendisi if, elif, else koşullar yazısında anlatılıyor.
sayilar = [1, 2, 3, 4, 5, 6]
print([n for n in sayilar if n % 2 == 0])                  # çıktı: [2, 4, 6]
print(['çift' if n % 2 == 0 else 'tek' for n in sayilar])
# çıktı: ['tek', 'çift', 'tek', 'çift', 'tek', 'çift']
print([n * 10 if n > 3 else n for n in sayilar if n != 2])  # çıktı: [1, 3, 40, 50, 60]

for yanlis in ['[n for n in s if n > 0 else 0]', '[n if n > 0 for n in s]']:
    try:
        compile(yanlis, 'ornek', 'eval')
    except SyntaxError as hata:
        print(hata.msg)
# çıktı: invalid syntax
# çıktı: expected 'else' after 'if' expression| Yazım | Ne yapar | Sonuç uzunluğu |
|---|---|---|
| [x for x in s if k] | k doğruysa x eklenir, değilse atlanır | En fazla len(s) |
| [a if k else b for x in s] | Her eleman için a ya da b eklenir | Tam olarak len(s) |
| [a if k else b for x in s if f] | Önce f ile süzer, kalanlara a ya da b | En fazla len(s) |
Birden çok for: iç içe döngülerin sırası
Bir comprehension'da birden çok for ve if cümleciği olabilir. Kural basittir: cümlecikler, aynı sırayla alt alta yazılmış iç içe döngüler gibi soldan sağa iç içe geçer ve en içteki noktaya her ulaşıldığında ifade değerlendirilip sonuca eklenir. Tutorial bunu "iki kodda for ve if sırasının aynı olduğuna dikkat edin" diye vurgular. İki boyutlu bir listeyi düzleştirmek bu yapının klasik kullanımıdır.
print([(x, y) for x in [1, 2, 3] for y in [3, 1, 4] if x != y])
# çıktı: [(1, 3), (1, 4), (2, 3), (2, 1), (2, 4), (3, 1), (3, 4)]

# Aynısının döngü hali:
ciftler = []
for x in [1, 2, 3]:
    for y in [3, 1, 4]:
        if x != y:
            ciftler.append((x, y))
print(len(ciftler))    # çıktı: 7

matris = [[1, 2, 3], [4, 5, 6], [7, 8, 9]]
print([sayi for satir in matris for sayi in satir])
# çıktı: [1, 2, 3, 4, 5, 6, 7, 8, 9]
İfade bir tuple ise parantez içine alınmalıdır. Parantezi unutursanız Python 3.15.2 aşağıdaki gibi açıklayıcı bir söz dizimi hatası verir (dosya yolu ornek.py olarak kısaltıldı):
print([x, x ** 2 for x in range(6)])
#   File "ornek.py", line 1
#     print([x, x ** 2 for x in range(6)])
#            ^^^^^^^^^
# SyntaxError: did you forget parentheses around the comprehension target?
İç içe comprehension
Comprehension'ın baştaki ifadesi herhangi bir ifade olabilir, başka bir comprehension da. Tutorial'daki örnekte 3x4'lük bir matrisin satır ve sütunları iç içe bir comprehension ile yer değiştirir. Buradaki okuma sırası önemlidir: içteki comprehension, dıştaki for'un her adımında yeniden çalışır. Aynı tutorial, gerçek kodda karmaşık akışlar yerine yerleşik fonksiyonları tercih etmenizi, bu örnek için de zip()'in işi çok daha iyi yapacağını söyler.
matris = [
    [1, 2, 3, 4],
    [5, 6, 7, 8],
    [9, 10, 11, 12],
]
print([[satir[i] for satir in matris] for i in range(4)])
# çıktı: [[1, 5, 9], [2, 6, 10], [3, 7, 11], [4, 8, 12]]
print(list(zip(*matris)))
# çıktı: [(1, 5, 9), (2, 6, 10), (3, 7, 11), (4, 8, 12)]

tablo = [[0] * 3 for _ in range(2)]   # her satır ayrı liste
tablo[0][0] = 1
print(tablo)    # çıktı: [[1, 0, 0], [0, 0, 0]]
Son satırdaki desen ayrıca önemlidir: iki boyutlu bir tablo kurarken [[0] * 3] * 2 yazmak aynı satırı iki kez paylaştırır. Python SSS çok boyutlu liste için tam olarak comprehension'lı biçimi önerir; tuzağın ayrıntısı liste metotları yazısında.
Dict comprehension ve set comprehension
Süslü parantez içinde anahtar: değer çiftiyle başlayan comprehension bir sözlük üretir. Sözlük öğelerini dolaşırken for k, v in d.items() açması en yaygın kullanımdır: değerleri dönüştürmek, belirli kayıtları seçmek ya da anahtar ve değerin yerini değiştirmek. Aynı anahtar birden fazla kez üretilirse, sözlük gösterimindeki genel kurala göre sonradan gelen değer öncekinin üzerine yazar. Python 3.8'den beri dict comprehension'da anahtar, değerden önce değerlendirilir.
fiyatlar = {'elma': 10, 'armut': 15, 'muz': 30}
print({urun: f * 2 for urun, f in fiyatlar.items()})   # çıktı: {'elma': 20, 'armut': 30, 'muz': 60}
print({k: v for k, v in fiyatlar.items() if v > 12})   # çıktı: {'armut': 15, 'muz': 30}
print({v: k for k, v in fiyatlar.items()})             # çıktı: {10: 'elma', 15: 'armut', 30: 'muz'}
print({k: len(k) for k in ['elma', 'kivi', 'karpuz']}) # çıktı: {'elma': 4, 'kivi': 4, 'karpuz': 6}
print({x % 3: x for x in range(10)})                   # çıktı: {0: 9, 1: 7, 2: 8}
Süslü parantez içinde tek bir ifadeyle başlayan comprehension ise bir küme üretir ve tekrarlar otomatik olarak düşer. Kümeler sırasız olduğu için örnekte sonucu sorted() ile yazdırıyoruz. Kümelerin diğer özellikleri set ve küme işlemleri, sözlüklerinkiler sözlük metotları yazısında.
print(sorted({h.lower() for h in ['a', 'A', 'b', 'C', 'c']}))   # çıktı: ['a', 'b', 'c']
kelimeler = ['Python', 'pip', 'paket', 'Linux']
print(sorted({k[0].lower() for k in kelimeler}))               # çıktı: ['l', 'p']
Generator ifadeleri: tembel üretim
Tuple comprehension diye bir şey yoktur. Normal parantez içine yazılan aynı söz dizimi bir generator ifadesi oluşturur: sonucu bellekte bir kerede kurmak yerine, değerleri istendikçe tek tek üreten bir yineleyici (iterator) döndürür. Tuple istiyorsanız generator ifadesini tuple()'a verirsiniz. Generator ifadesi bir fonksiyon çağrısının tek konumsal argümanıysa ve başka argüman yoksa kendi parantezleri atlanabilir; sum(x ** 2 for x in range(10)) bu yüzden geçerlidir. Başka argüman da varsa parantez gerekir.
print(tuple(x ** 2 for x in range(5)))     # çıktı: (0, 1, 4, 9, 16)
g = (x ** 2 for x in range(5))
print(type(g).__name__)                    # çıktı: generator

print(sum(x ** 2 for x in range(10)))               # çıktı: 285
print(sum((x ** 2 for x in range(10)), start=1000)) # çıktı: 1285
print(any(n > 3 for n in [1, 5, 2]))                # çıktı: True
print(max(len(k) for k in ['a', 'abc', 'ab']))      # çıktı: 3

g = (x * 2 for x in [1, 2, 3])
print(list(g))    # çıktı: [2, 4, 6]
print(list(g))    # çıktı: []
Son iki satır generator'ların temel özelliğini gösterir: bir kez tüketildiklerinde tükenirler ve ikinci kez dolaşıldıklarında hiçbir şey üretmezler. Sonuca birden çok kez ihtiyacınız varsa list comprehension kullanın. Generator'lar yalnızca bir kez dolaşılacak, özellikle büyük veya sonsuz veri akışlarında belleği korur.
Dil başvuru belgesi değerlendirme zamanlaması hakkında ince bir kural da tanımlar: en soldaki for cümleciğinin yinelenebilir ifadesi generator ifadesi tanımlanırken hemen değerlendirilir, bu yüzden oradaki bir hata ilk değer istenene kadar beklemez. Diğer tüm ifadeler ise tembeldir ve ancak değer istendiğinde çalışır.
try:
    g = (x for x in tanimsiz)
except NameError as hata:
    print('tanımlarken:', hata)   # çıktı: tanımlarken: name 'tanimsiz' is not defined

g = (bilinmeyen for x in range(3))
print('generator oluşturuldu')   # çıktı: generator oluşturuldu
try:
    list(g)
except NameError as hata:
    print('tüketirken:', hata)    # çıktı: tüketirken: name 'bilinmeyen' is not defined
Generator fonksiyonları, yield ve yineleyici protokolünün ayrıntıları için generator, yield ve iterator yazısına bakabilirsiniz.
Kapsam kuralları ve iki tuzak
Comprehension'ın gövdesi, en soldaki yinelenebilir ifadesi hariç, ayrı bir iç kapsamda çalışır. En soldaki yinelenebilir dış kapsamda değerlendirilip iç kapsama argüman olarak geçirilir. Bunun sınıf gövdesinde şaşırtıcı bir sonucu vardır: çalışma modeli belgelerine göre sınıf bloğunda tanımlanan isimlerin kapsamı metotlara ve comprehension'lara uzanmaz. Bu yüzden sınıf gövdesindeki bir comprehension, sınıf değişkenini en soldaki yinelenebilir olarak kullanabilir ama ifadenin içinde kullanamaz. Kapsam kurallarının geneli kapsam, global ve nonlocal yazısında.
class Ayar:
    katsayi = 3
    sinirlar = [1, 2, 3]
    ikiye = [s * 2 for s in sinirlar]        # çalışır: sinirlar en soldaki yinelenebilir
    try:
        kat = [s * katsayi for s in sinirlar]
    except NameError as hata:
        print(hata)    # çıktı: name 'katsayi' is not defined

print(Ayar.ikiye)      # çıktı: [2, 4, 6]
İkinci tuzak atama ifadesiyle (walrus, :=) ilgilidir. Belgelere göre atama ifadeleri comprehension'ın yinelenebilir kısmında (yani in'den sonra) ve doğrudan sınıf tanımında bulunan comprehension'larda kullanılamaz; filtre if'i içinde kullanıldığında ise parantez içine alınması zorunludur. Doğru kullanıldığında walrus, bir fonksiyonu filtrede ve ifadede iki kez çağırmaktan kurtarır:
def sayiya(metin):
    try:
        return int(metin)
    except ValueError:
        return None

veriler = ['3', 'x', '10', '-2']
print([n for s in veriler if (n := sayiya(s)) is not None])   # çıktı: [3, 10, -2]
Python 3.15 yeniliği: comprehension içinde açma (PEP 798)
Python 3.15 ile liste, küme ve sözlük comprehension'ları ile generator ifadeleri * ve ** ile açmayı destekliyor. Bu, Python 3.5'te liste ve sözlük gösterimlerine gelen açma söz diziminin ([0, *x], {**a, **b}) comprehension'lara genişletilmesidir. Sürüm notları bunu iç içe comprehension'ın, itertools.chain()'in ve itertools.chain.from_iterable()'ın doğrudan bir alternatifi olarak tanımlar. List ya da set comprehension'ın ifadesi yıldızlıysa her eleman açılır ve sıfır veya daha fazla eleman olarak sonuca eklenir; dict comprehension'da ** ile açılan her eşleme sonuca kayıtlarını ekler ve aynı anahtarda sonraki değer kazanır.
listeler = [[1, 2], [3, 4], [5]]
print([*L for L in listeler])              # çıktı: [1, 2, 3, 4, 5]
print([x for L in listeler for x in L])    # çıktı: [1, 2, 3, 4, 5]

kumeler = [{1, 2}, {2, 3}, {3, 4}]
print({*s for s in kumeler})               # çıktı: {1, 2, 3, 4}

ayarlar = [{'renk': 'mavi', 'adet': 8}, {'renk': 'sarı'}, {'adet': 5}]
print({**d for d in ayarlar})              # çıktı: {'renk': 'sarı', 'adet': 5}

gen = (*L for L in listeler)
print(list(gen))                           # çıktı: [1, 2, 3, 4, 5]

karisik = [[1, 2, 3], 'kedi', {'anahtar': 'değer'}]
print([*e for e in karisik])               # çıktı: [1, 2, 3, 'k', 'e', 'd', 'i', 'anahtar']
Son örnekte görüldüğü gibi açma her yinelenebilirle çalışır: string harflerine, sözlük anahtarlarına ayrılır. Açılan değer yinelenebilir değilse, ya da ** ile açılan değer bir eşleme değilse TypeError alırsınız. ** list comprehension'da kullanılamaz; bu bir söz dizimi hatasıdır. Bu yenilik eski Python sürümlerinde çalışmaz, kodunuzu 3.14 veya öncesinde de çalıştırmanız gerekiyorsa iki for'lu biçimi ya da itertools.chain kullanın. Sürümün tüm yenilikleri Python 3.15 yenilikleri yazısında.
try:
    [*e for e in [1, 2]]
except TypeError as hata:
    print(hata)    # çıktı: Value after * must be an iterable, not int

try:
    {**d for d in [1]}
except TypeError as hata:
    print(hata)    # çıktı: 'int' object is not a mapping

try:
    compile('[**d for d in x]', 'ornek', 'eval')
except SyntaxError as hata:
    print(hata.msg)   # çıktı: cannot use dict unpacking in list comprehension
Ne zaman comprehension kullanmamalı?
Comprehension bir değer üretmek için vardır. Yalnızca yan etki için, örneğin her eleman için print() çağırmak amacıyla comprehension yazmak, içi None dolu gereksiz bir liste üretir. Python SSS bu durumu açıkça ayırır: dönüş değerlerini bir listede toplamak istiyorsanız comprehension zarif bir çözümdür, fonksiyonu yalnızca çalıştırmak istiyorsanız düz bir for döngüsü yeterlidir. Okunabilirlik de bir ölçüttür: üçten fazla cümlecik, iç içe koşullu ifadeler veya uzun ifadeler biriktiğinde döngüye ya da yardımcı bir fonksiyona dönmek kodu anlaşılır kılar. İçinde yield kullanılamaz, istisna yakalamak için try yazılamaz; bunlara ihtiyaç varsa ifadeyi bir fonksiyona taşıyın, tıpkı walrus örneğindeki sayiya() gibi.
# Kaçının: yalnızca yan etki için liste kuruluyor
sonuc = [print(k) for k in ['a', 'b']]
# çıktı: a
# çıktı: b
print(sonuc)    # çıktı: [None, None]

# Tercih edin:
for k in ['a', 'b']:
    print(k)
# çıktı: a
# çıktı: b
Uygulamalı mini örnek: noktalı virgüllü veriyi işlemek
Bir dosyadan okunmuş gibi düşündüğümüz noktalı virgüllü satırları önce list comprehension ile alanlarına ayırıyor, puanı boş olanları dict comprehension'daki filtreyle atıyor, ardından 80 ve üzeri alanları bir generator ifadesiyle seçip sıralıyoruz. Gerçek CSV dosyaları için tırnak ve ayırıcı kurallarını doğru işleyen csv modülü kullanılmalıdır.
satirlar = ['ad;puan', 'Ayşe;91', 'Can;72', 'Ece;', 'Mert;85']
kayitlar = [s.split(';') for s in satirlar[1:]]
puanlar = {ad: int(p) for ad, p in kayitlar if p}
gecenler = sorted(ad for ad, p in puanlar.items() if p >= 80)

print(kayitlar[2])     # çıktı: ['Ece', '']
print(puanlar)         # çıktı: {'Ayşe': 91, 'Can': 72, 'Mert': 85}
print(gecenler)        # çıktı: ['Ayşe', 'Mert']
print(round(sum(puanlar.values()) / len(puanlar), 1))   # çıktı: 82.7
Dört biçim bir arada
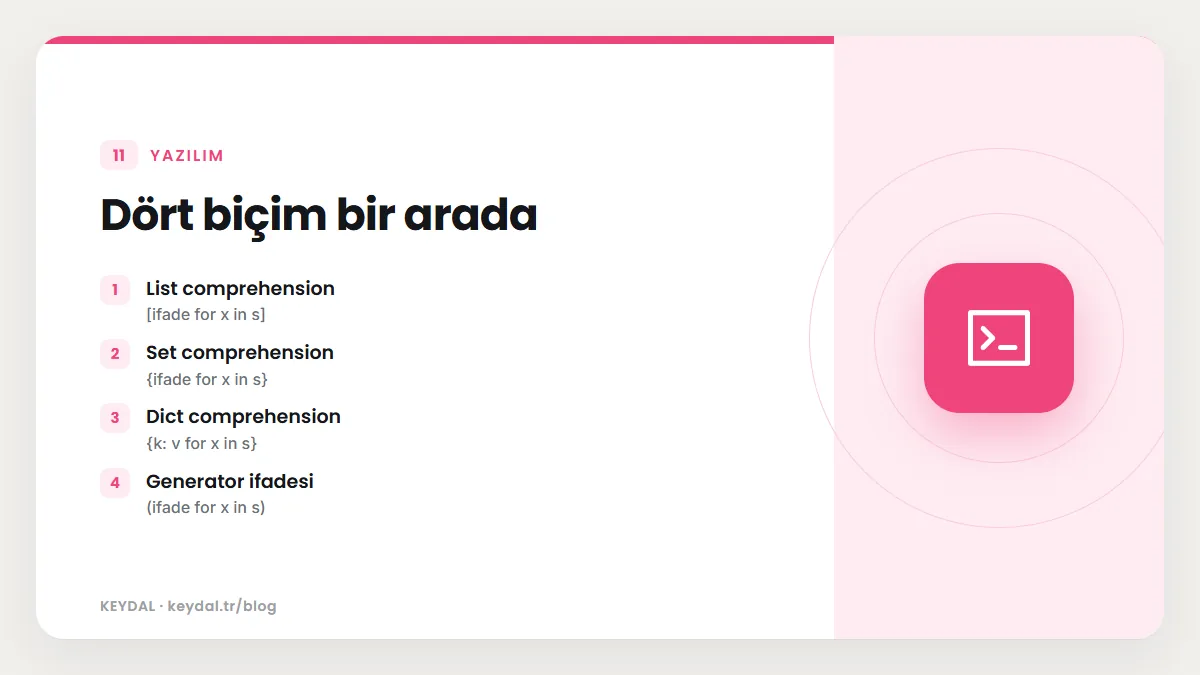
| Biçim | Söz dizimi | Sonuç | Not |
|---|---|---|---|
| List comprehension | [ifade for x in s] | list | Sıra korunur, tekrarlar kalır |
| Set comprehension | {ifade for x in s} | set | Tekrarlar düşer, sırasız |
| Dict comprehension | {k: v for x in s} | dict | Aynı anahtarda son değer kazanır |
| Generator ifadesi | (ifade for x in s) | generator | Tembel, bir kez tüketilir |
| 3.15 açma (liste/küme) | [*x for x in s] | list veya set | Her elemanı düzleştirir |
| 3.15 açma (sözlük) | {**d for d in s} | dict | Eşlemeleri birleştirir |
async def fonksiyonları içinde async for içeren asenkron comprehension'lar da yazılabilir; 3.15 açma desteği asenkron generator ifadelerini de kapsar. Bu konu asyncio, async ve await yazısının kapsamında.
Sık yapılan hatalar
- Filtre
if'ineelseeklemek:elsegerekiyorsa koşullu ifadeyi başa,for'dan önceye taşıyın. - Tuple üreten ifadeyi parantezsiz yazmak:
[(x, y) for ...]biçiminde yazın. - Birden çok
for'un sırasını ters düşünmek: soldakifordıştaki döngüdür. - Bir generator'ı iki kez dolaşmaya çalışmak: ikinci dolaşım boş gelir.
- Sınıf gövdesindeki comprehension'da sınıf değişkenini ifadede kullanmak:
NameErrorverir. - Yalnızca yan etki için comprehension yazmak: düz
fordöngüsü kullanın. - 3.15'e özgü
[*x for x in s]yazımını eski sürümlerde çalıştırmak: söz dizimi hatası alırsınız.
Sık Sorulan Sorular
List comprehension for döngüsünden hızlı mı?
Resmî belgeler genel bir hız oranı vermez. Python SSS, bir listeden birden çok elemanı silmenin yolları arasında comprehension'lı dilim atamasının muhtemelen en hızlısı olduğunu söyler, ama asıl tavsiye okunabilirlik yönündedir: basit dönüştürme ve süzme işlerinde comprehension kısa ve nettir; karmaşık mantık için döngü daha anlaşılırdır. Kendi kodunuzda ölçmek için timeit modülünü kullanabilirsiniz.
Comprehension içinde değişken tanımlayabilir miyim?
Döngü hedefleri comprehension'ın kendi kapsamında kalır. Bir ara sonucu hem filtrede hem ifadede kullanmak için filtrede parantez içinde walrus kullanabilir (if (n := f(x)) is not None) ya da ek bir for cümleciğiyle tek elemanlı bir yinelenebilir dolaşabilirsiniz (for n in [f(x)]).
Liste yerine generator ifadesi ne zaman seçilmeli?
Sonucu yalnızca bir kez, sırayla tüketecekseniz, örneğin sum(), any(), max() ya da ''.join() gibi bir fonksiyona verecekseniz generator ifadesi yeterlidir ve tüm listeyi bellekte kurmaz. Sonuca indeksle erişecek, uzunluğunu alacak ya da birden çok kez dolaşacaksanız liste gerekir.
Comprehension ile bir sözlüğü filtreleyip sıralayabilir miyim?
Filtreleme için evet: {k: v for k, v in d.items() if koşul}. Sıralama için önce sorted(d.items(), key=...) ile çiftleri sıralayıp sonucu dict()'e verin; sözlük ekleme sırasını koruduğu için yeni sözlük sıralı dolaşılır.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: Python öğrenme rehberi · Liste metotları · Sözlük metotları · Kümeler · Generator ve yield · itertools ve functools