Node.js'te veri sıkıştırmak için yerleşik node:zlib modülü kullanılır. Modül Gzip, Deflate/Inflate, Brotli ve Zstd algoritmalarını destekler. Küçük veriler için tek adımda çalışan gzipSync(), brotliCompress() gibi kolaylık yöntemleri; dosya ve ağ trafiği gibi büyük veriler için ise createGzip(), createBrotliCompress() gibi Transform stream üreten yöntemler vardır. Belgelere göre zlib'in sıkıştırma ve açma işlemleri Node'un Streams API'si etrafında kuruludur ve modülün kararlılık etiketi Stability: 2 - Stable'dır; yalnızca Zstd desteği Stability: 1 - Experimental olarak işaretlidir.
Bu yazıda algoritmaları karşılaştırıyor, tek seferlik ve stream tabanlı kullanımı, util.promisify ile Promise'e çevirmeyi, bozuk ve kesik veride oluşan hataları, HTTP yanıtını Accept-Encoding'e göre sıkıştırmayı, açılan veri boyutunu sınırlamayı ve iş parçacığı havuzu ile ilgili uyarıları Node.js v26.13.0 ile çalıştırılmış örneklerle anlatıyoruz. Stream bağlama ve hata yönetimi için pipeline ve backpressure yazısına, serinin tamamı için Node.js öğrenme rehberi sayfasına bakabilirsiniz.
Algoritmalar: gzip, deflate, brotli ve zstd
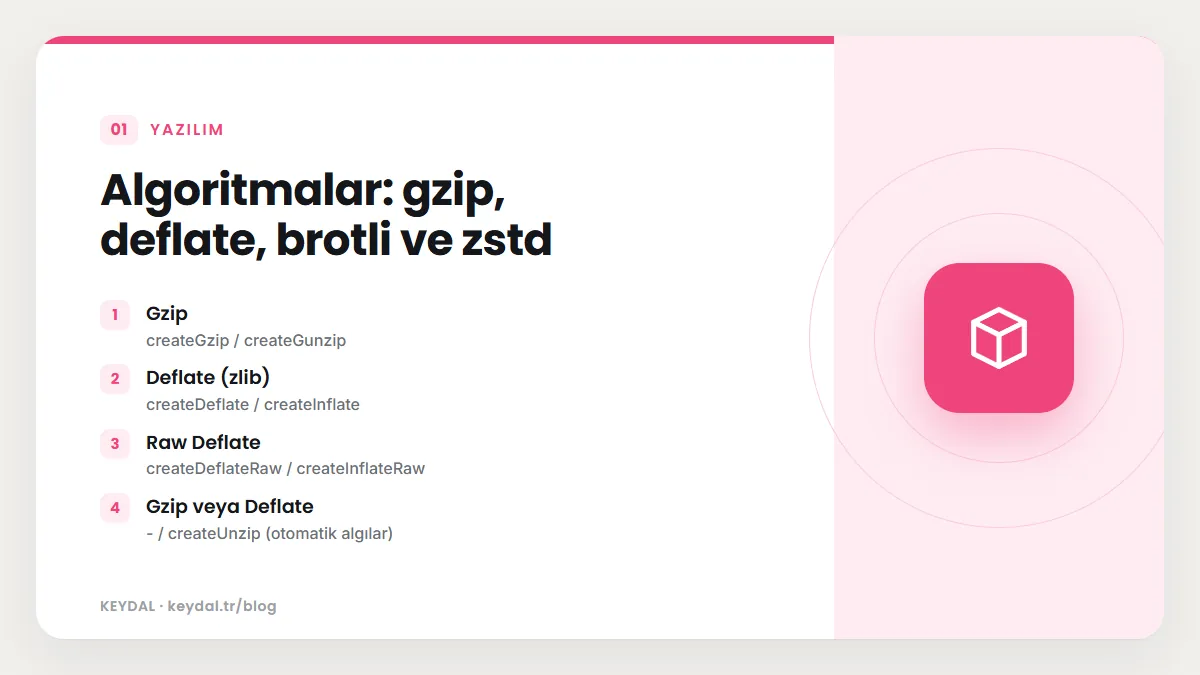
Gzip ve Deflate aynı sıkıştırma algoritmasını kullanır, fark kapsayıcı biçimdedir: Deflate (zlib biçimi) küçük bir başlık ve sağlama toplamı ekler, Gzip ise dosya biçimi olarak daha geniş bir başlık taşır. Raw Deflate hiç başlık içermez. Brotli genellikle metinde daha iyi oran sağlar ve HTTP'de br adıyla geçer. Zstd ise belgelerde deneysel işaretli, v23.8.0 ve v22.15.0 ile eklenmiş en yeni seçenektir. Aşağıdaki örnek aynı tekrar eden metni üç yöntemle sıkıştırıyor:
import { gzipSync, gunzipSync, deflateSync, brotliCompressSync, brotliDecompressSync } from 'node:zlib';

const metin = 'Node.js zlib ile sıkıştırma. '.repeat(200);
const girdi = Buffer.from(metin);

const gz = gzipSync(girdi);
const df = deflateSync(girdi);
const br = brotliCompressSync(girdi);

console.log('ham:', girdi.length); // çıktı: ham: 6600
console.log('gzip:', gz.length, 'deflate:', df.length, 'brotli:', br.length); // çıktı: gzip: 94 deflate: 82 brotli: 59
console.log(gz.subarray(0, 2).toString('hex')); // çıktı: 1f8b
console.log(gunzipSync(gz).toString() === metin); // çıktı: true
console.log(brotliDecompressSync(br).equals(girdi)); // çıktı: true
Bu sayılar yalnızca bu yapay ve çok tekrarlı girdi içindir; gerçek veride oranlar içeriğe göre çok değişir, bu yüzden genel bir "en iyi algoritma" sıralaması vermiyoruz. Gzip çıktısının ilk iki baytı her zaman 1f 8b'dir; bu imza, bir buffer'ın gzip olup olmadığını anlamak için kullanılır. Deflate ile gzip arasındaki 12 baytlık fark başlık ve sağlama alanlarından gelir. Sıkıştırma sonucu ikili veri olduğu için Buffer olarak döner; ayrıntılar Buffer yazısında.
| Biçim | Sıkıştır / Aç (stream) | HTTP adı | Kararlılık |
|---|---|---|---|
| Gzip | createGzip / createGunzip | gzip | Stable |
| Deflate (zlib) | createDeflate / createInflate | deflate | Stable |
| Raw Deflate | createDeflateRaw / createInflateRaw | yok | Stable |
| Gzip veya Deflate | - / createUnzip (otomatik algılar) | gzip, deflate | Stable |
| Brotli | createBrotliCompress / createBrotliDecompress | br | Stable |
| Zstd | createZstdCompress / createZstdDecompress | zstd | Experimental |
Kolaylık yöntemleri ve promisify
Belgelerin "Convenience methods" bölümündeki yöntemler (gzip, gunzip, deflate, inflate, unzip, brotliCompress ...) ilk argüman olarak Buffer, TypedArray, DataView, ArrayBuffer ya da string alır ve sonucu callback(err, sonuc) ile verir. Her birinin Sync ile biten eşzamanlı bir eşi vardır. Callback'li sürümü Promise'e çevirmek için belgeler util.promisify'ı gösterir; bu yardımcının çalışma mantığı util.promisify yazısında anlatılıyor. unzip gzip ve deflate başlıklarını otomatik algılar, bu yüzden verinin hangisi olduğunu bilmediğinizde işe yarar:
import { gzip, gunzip, unzip, deflate } from 'node:zlib';
import { promisify } from 'node:util';

const gzipAsync = promisify(gzip);
const gunzipAsync = promisify(gunzip);
const unzipAsync = promisify(unzip);
const deflateAsync = promisify(deflate);

const sikisik = await gzipAsync('merhaba zlib');
console.log((await gunzipAsync(sikisik)).toString()); // çıktı: merhaba zlib

const d = await deflateAsync('deflate verisi');
console.log((await unzipAsync(d)).toString()); // çıktı: deflate verisi
console.log((await unzipAsync(sikisik)).toString()); // çıktı: merhaba zlib

try {
  await gunzipAsync(Buffer.from('bu gzip değil'));
} catch (err) {
  console.log(err.code, err.message); // çıktı: Z_DATA_ERROR incorrect header check
}

try {
  await gunzipAsync(sikisik.subarray(0, sikisik.length - 5));
} catch (err) {
  console.log(err.code, err.message); // çıktı: Z_BUF_ERROR unexpected end of file
}
İki farklı hata türü vardır. Gzip olmayan veriyi açmaya çalışmak Z_DATA_ERROR ("incorrect header check") verir. Kesilmiş, yani sonu eksik gzip verisi ise Z_BUF_ERROR ("unexpected end of file") üretir; belgeler v5.0.0'dan beri kesik girdinin hata olayıyla sonuçlandığını belirtir. Verinin eksik olduğunu bildiğiniz ve yalnızca başını görmek istediğiniz özel durumlarda belgeler finishFlush: zlib.constants.Z_SYNC_FLUSH seçeneğini gösterir; ancak bu durumda verinin erken bitip bitmediğini ya da bütünlük kontrolünün geçip geçmediğini anlayamazsınız, sonucu kendiniz doğrulamanız gerekir.
Stream ile dosya sıkıştırmak ve açmak
Büyük dosyalar için zlib'in Transform stream'leri pipeline() ile okuma ve yazma stream'lerinin arasına konur. Böylece dosya hiçbir zaman tamamen belleğe alınmaz ve backpressure korunur. Sıkıştırma düzeyini level seçeneğiyle verebilirsiniz; belgelere göre hızı en çok bu ayar etkiler: yüksek düzey daha iyi oran ama daha uzun süre, düşük düzey daha az sıkıştırma ama çok daha hızlı işlem demektir:
import { createReadStream, createWriteStream } from 'node:fs';
import { writeFile, stat, readFile } from 'node:fs/promises';
import { createGzip, createGunzip } from 'node:zlib';
import { pipeline } from 'node:stream/promises';

await writeFile('erisim.log', '127.0.0.1 - GET /index.html 200\n'.repeat(20000));

await pipeline(createReadStream('erisim.log'), createGzip({ level: 9 }), createWriteStream('erisim.log.gz'));
console.log((await stat('erisim.log')).size, (await stat('erisim.log.gz')).size); // çıktı: 640000 1623

await pipeline(createReadStream('erisim.log.gz'), createGunzip(), createWriteStream('erisim-geri.log'));
const a = await readFile('erisim.log');
const b = await readFile('erisim-geri.log');
console.log(a.equals(b)); // çıktı: true
Aynı satırın 20.000 kez tekrarlandığı yapay bir log olduğu için oran çok yüksek çıktı; gerçek loglarda böyle bir sonuç beklemeyin. Açılan dosyanın asıl dosyayla bayt bayt aynı olduğunu Buffer.equals() ile doğruladık. Belgelerin bellek ayarı bölümüne göre deflate için varsayılan bellek ihtiyacı windowBits = 15 ve memLevel = 8 değerleriyle yaklaşık 256K, inflate için 32K'dır; ek olarak varsayılanı 16K olan chunkSize boyutunda bir çıktı tamponu kullanılır. windowBits: 14, memLevel: 7 gibi daha küçük değerler belleği yarıya indirir ama genellikle sıkıştırma oranını düşürür. Brotli'de bu ayarların karşılığı BROTLI_PARAM_QUALITY ve BROTLI_PARAM_LGWIN parametreleridir.
HTTP yanıtlarını sıkıştırmak
İstemci, kabul ettiği sıkıştırma türlerini Accept-Encoding başlığıyla bildirir; sunucu kullandığı türü Content-Encoding başlığıyla söyler. Belgelerdeki sunucu örneği iki önemli noktanın altını çizer: her istekte yeniden sıkıştırmak pahalıdır, sıkıştırılmış sonuç önbellekte tutulmalıdır; ve aynı adres için sıkıştırılmış ve sıkıştırılmamış iki farklı yanıt olabileceğini ara önbelleklere bildirmek için Vary: Accept-Encoding başlığı eklenmelidir. Belgeler ayrıca kendi örneğindeki düzenli ifadenin standarda tam uyan bir Accept-Encoding ayrıştırıcısı olmadığını açıkça not eder. Aşağıdaki örnek sayfayı başlangıçta bir kez Brotli ve gzip ile sıkıştırıp önbellekten sunuyor:
import http from 'node:http';
import { brotliCompressSync, gzipSync, constants } from 'node:zlib';

const sayfa = Buffer.from('<h1>Merhaba</h1>\n'.repeat(500));
// Sıkıştırılmış halleri bir kez üretip önbellekte tutuyoruz
const onbellek = {
  br: brotliCompressSync(sayfa, { params: { [constants.BROTLI_PARAM_MODE]: constants.BROTLI_MODE_TEXT } }),
  gzip: gzipSync(sayfa),
};

const server = http.createServer((req, res) => {
  const kabul = req.headers['accept-encoding'] ?? '';
  res.setHeader('Vary', 'Accept-Encoding');
  res.setHeader('Content-Type', 'text/html; charset=utf-8');
  if (/\bbr\b/.test(kabul)) {
    res.writeHead(200, { 'Content-Encoding': 'br' }).end(onbellek.br);
  } else if (/\bgzip\b/.test(kabul)) {
    res.writeHead(200, { 'Content-Encoding': 'gzip' }).end(onbellek.gzip);
  } else {
    res.writeHead(200).end(sayfa);
  }
});

server.listen(0, async () => {
  const base = `http://localhost:${server.address().port}/`;
  for (const ae of ['br, gzip', 'gzip', 'identity']) {
    const r = await fetch(base, { headers: { 'Accept-Encoding': ae } });
    const govde = await r.text();
    console.log(ae, '|', r.headers.get('content-encoding'), '|', govde.length);
  }
  server.close();
});
// çıktı: br, gzip | br | 8500
// çıktı: gzip | gzip | 8500
// çıktı: identity | null | 8500
Üç istekte de sunucu farklı Content-Encoding ile yanıt verdi, ama text() ile okunan gövde her seferinde 8500 karakterlik açılmış HTML oldu: bu örnekte Node'un fetch'i gzip ve br kodlu gövdeyi bizim yerimize açtı. node:http istemcisiyle (http.get) çalışırken ise açmayı siz yaparsınız; belgelerdeki istemci örneği content-encoding başlığına bakıp yanıtı uygun açıcı stream'den (createGunzip, createBrotliDecompress, ya da her ikisini algılayan createUnzip) geçirir. Brotli için kullandığımız BROTLI_MODE_TEXT, belgelerde UTF-8 metin için ayarlanmış kip olarak geçer. Sunucu kurma ayrıntıları node:http yazısında, istemci tarafı fetch yazısında.
Akan (streaming) yanıtlarda sıkıştırıcı veriyi daha iyi oran için tamponda biriktirebilir. Belgelerin "Flushing" bölümü, kısmi veriyi istemciye hemen ulaştırmak için sıkıştırma stream'inde flush() çağrılabileceğini, ancak bunun sıkıştırma kalitesini düşürebileceğini anlatır.
Açma bombalarına karşı: maxOutputLength
Sıkıştırma çok tekrarlı veride çok yüksek oranlara ulaşabildiği için, birkaç kilobaytlık bir girdi açıldığında yüzlerce megabayta dönüşebilir. Dışarıdan gelen sıkıştırılmış veriyi açarken bu bir risktir. Kolaylık yöntemlerinde maxOutputLength seçeneği çıktı boyutunu sınırlar; belgelere göre varsayılanı buffer.kMaxLength'tir, yani pratikte sınırsızdır. Aynı örnek deneysel Zstd yöntemlerini ve zlib.crc32() sağlama toplamını da gösteriyor:
import { gzipSync, gunzipSync, zstdCompressSync, zstdDecompressSync, crc32 } from 'node:zlib';

const bomba = gzipSync(Buffer.alloc(10 * 1024 * 1024)); // 10 MiB sıfır
console.log('sıkışık boyut:', bomba.length); // çıktı: sıkışık boyut: 10221
try {
  gunzipSync(bomba, { maxOutputLength: 1024 * 1024 });
} catch (err) {
  console.log(err.name, err.code); // çıktı: RangeError ERR_BUFFER_TOO_LARGE
}

const z = zstdCompressSync('zstd denemesi');
console.log(zstdDecompressSync(z).toString()); // çıktı: zstd denemesi

console.log(crc32('merhaba')); // çıktı: 1994389773
10 MiB'lık sıfır dizisi yaklaşık 10 KB'a sıkıştı; 1 MiB sınırıyla açmaya çalışınca ERR_BUFFER_TOO_LARGE koduyla RangeError alındı. Stream ile açarken bu seçenek geçerli değildir; orada açılan stream'den geçen toplam baytı kendiniz sayıp sınırı aşınca pipeline'ı iptal etmelisiniz. YAML kayıtlarına göre v26.5.0 ile eklenen rejectGarbageAfterEnd seçeneği ise sıkıştırılmış akışın bitişinden sonra gelen fazladan baytları (gzip'te ek üyeler dahil) hata sayar. zlib.crc32() (v22.2.0 ve v20.15.0 ile geldi) veri iletiminde hata tespiti için 32 bit bir sağlama toplamı hesaplar; belgeler bunun kriptografik doğrulamaya uygun olmadığını açıkça belirtir, bütünlük ve kimlik doğrulaması için crypto hash ve HMAC kullanılmalıdır.
İş parçacığı havuzu ve performans uyarıları
Belgelere göre açıkça eşzamanlı olanlar dışındaki tüm zlib API'leri Node'un iç iş parçacığı havuzunu (threadpool) kullanır. Bu, sıkıştırmanın ana iş parçacığını bloklamadığı anlamına gelir, ama havuz sınırlıdır ve dosya sistemi gibi başka işlerle paylaşılır. Belgeler ayrıca çok sayıda zlib nesnesini aynı anda oluşturmanın ciddi bellek parçalanmasına yol açabileceğini, bir döngüde 30.000 deflate çağrısını eşzamanlı başlatan örneği "bunu yapmayın" notuyla gösterir. Önerilen çözüm, aynı içeriği tekrar tekrar sıkıştırmak yerine sonucu önbelleğe almaktır; yukarıdaki HTTP örneği bu yüzden sayfayı başlangıçta bir kez sıkıştırdı.
Web uyumlu alternatif: CompressionStream
Node, tarayıcılarla aynı API'ye sahip global CompressionStream ve DecompressionStream sınıflarını da sunar. Globals belgesine göre bu API v23.11.0 ve v22.15.0 ile kararlı olarak işaretlendi, v24.7.0 ve v22.20.0 ile brotli biçimini de kabul etmeye başladı. Web stream'leriyle çalışırken (ör. fetch gövdesi, Blob.stream()) ya da tarayıcıyla paylaşılan kodda kullanışlıdır:
const kaynak = new Blob(['web uyumlu sıkıştırma '.repeat(50)]).stream();
const sikisik = kaynak.pipeThrough(new CompressionStream('gzip'));
const geri = sikisik.pipeThrough(new DecompressionStream('gzip'));
const metin = await new Response(geri).text();
console.log(metin.length, metin.slice(0, 21)); // çıktı: 1100 web uyumlu sıkıştırma
Uygulamalı mini örnek: eski logları gece arşivlemek
Sunucunuzda her gün yeni bir log dosyası oluştuğunu ve yedi günden eski dosyaları sıkıştırıp silmek istediğinizi düşünün. Betik önce klasördeki dosyaları ve tarihlerini listeler (klasör işlemleri ve fs.stat yazılarındaki yöntemlerle), sonra her eski dosya için pipeline(createReadStream(f), createGzip(), createWriteStream(f + '.gz')) çalıştırır. Pipeline başarıyla bittikten sonra, ve ancak o zaman, asıl dosyayı siler. Dosyaları tek tek sırayla işlemek, belgelerin uyardığı çok sayıda eşzamanlı zlib nesnesi sorununu da önler. Herhangi bir adım hata verirse pipeline diğer stream'leri kapatır, betik hatayı kaydeder ve asıl dosya silinmeden kalır.
Sık yapılan hatalar
- Sunucuda istek başına gzipSync çalıştırmak: Ana iş parçacığını bloklar; statik içeriği önceden sıkıştırıp önbellekte tutun.
- Vary: Accept-Encoding başlığını unutmak: Ara önbellekler sıkıştırılmış yanıtı onu desteklemeyen istemciye verebilir.
- Content-Encoding ile gövdeyi uyumsuz göndermek: Başlık br derken gzip göndermek istemcide açma hatasına yol açar.
- Dışarıdan gelen veriyi sınırsız açmak:
maxOutputLengthverin ya da stream'de bayt sayın. - Sıkıştırılmış veriyi string olarak saklamak: Çıktı ikilidir; Buffer olarak tutun ya da base64'e çevirin.
- pipe() ile zincir kurup hataları dinlememek: Bozuk girdi Z_DATA_ERROR ile hata verir;
pipeline()kullanın. - crc32'yi güvenlik kontrolü sanmak: Belgelere göre kriptografik doğrulama için uygun değildir.
Sık Sorulan Sorular
gzip mi brotli mi kullanmalıyım?
İkisi de kararlı ve HTTP'de yaygın desteklenir. Belgeler genel bir sıralama vermez; oran ve hız içeriğe ve seçtiğiniz düzeye bağlıdır. İstemci ikisini de kabul ediyorsa kendi verinizle ikisini ölçüp karar verin; desteklemeyen istemciler için gzip ya da sıkıştırmasız yanıtı yedek olarak tutun.
unzip fonksiyonu .zip dosyası açar mı?
Hayır. zlib.unzip() gzip ya da deflate verisini başlığından tanıyıp açar; ZIP arşiv biçimiyle ilgisi yoktur. ZIP arşivleri için v26.8.0 ile eklenen ve henüz "Early development" aşamasındaki ayrı API'ler vardır.
Sıkıştırma düzeyini nasıl ayarlarım?
zlib tabanlı sınıflarda level seçeneğiyle (ör. createGzip({ level: 9 })), Brotli'de params içinde zlib.constants.BROTLI_PARAM_QUALITY ile ayarlanır. Belgelere göre hızı en çok etkileyen ayar budur.
Zstd üretimde kullanılabilir mi?
Zstd desteği belgelerde Experimental (1) olarak işaretli. Bayrak gerekmez, ama deneysel API'ler sürümler arasında değişebileceği için üretimde kullanmadan önce kendi Node sürümünüzün belgesini kontrol edin.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: Node.js öğrenme rehberi · stream.pipeline ve backpressure · node:http ile sunucu · Node.js Buffer kullanımı · util.promisify ve inspect · Node.js performans optimizasyonu