Node.js'te Buffer, sabit uzunlukta bir bayt dizisini temsil eden sınıftır. Dosyadan okunan ham veri, ağdan gelen paketler, sıkıştırılmış içerik ya da bir şifreleme çıktısı JavaScript string'i değil bayt dizisidir; Node bu baytları Buffer nesnesi olarak verir. Buffer, JavaScript'in Uint8Array sınıfının bir alt sınıfıdır ve ona encoding dönüşümü, ikili sayı okuma/yazma ve karşılaştırma gibi ek yöntemler ekler. Yeni bir buffer oluşturmak için Buffer.from(), Buffer.alloc() ve dikkatli kullanılması gereken Buffer.allocUnsafe() yöntemleri vardır.
Bu yazıda buffer oluşturma yollarını, karakter kodlamalarını (utf8, base64, hex, latin1), Uint8Array ile ilişkiyi, subarray ile kopya arasındaki farkı, çok baytlı karakterlerin parçalara bölünmesi sorununu ve ikili protokollerde sayı okuma yöntemlerini Node.js v26.13.0 ile çalıştırılmış örneklerle anlatıyoruz. Buffer'ların parça parça aktığı yapıları öğrenmek için stream yazısına, tüm seriyi görmek için Node.js öğrenme rehberi sayfasına bakabilirsiniz.
Buffer nedir, neden string yetmez?
JavaScript string'leri UTF-16 kod birimlerinden oluşan metinlerdir. Oysa disk ve ağ yalnızca bayt bilir: bir PNG dosyası, gzip ile sıkıştırılmış bir yanıt ya da TCP üzerinden gelen bir ikili protokol mesajı metin değildir. Bu veriyi string'e çevirmeye çalışmak hem bozulmaya hem de gereksiz bellek kullanımına yol açar. Buffer bu ham baytları olduğu gibi tutar; ancak siz bir encoding belirttiğinizde metne dönüştürülür.
Node.js belgelerine göre Buffer sınıfı global kapsamda erişilebilir olsa da açıkça import { Buffer } from 'node:buffer' ile içe aktarılması önerilir. Node'un buffer kabul eden API'leri düz Uint8Array nesnelerini de kabul eder; yani elinizde bir Uint8Array varsa çoğu zaman onu Buffer'a çevirmeniz gerekmez. Modülün kararlılık etiketi Stability: 2 - Stable'dır.
Buffer oluşturmak: from, alloc ve allocUnsafe
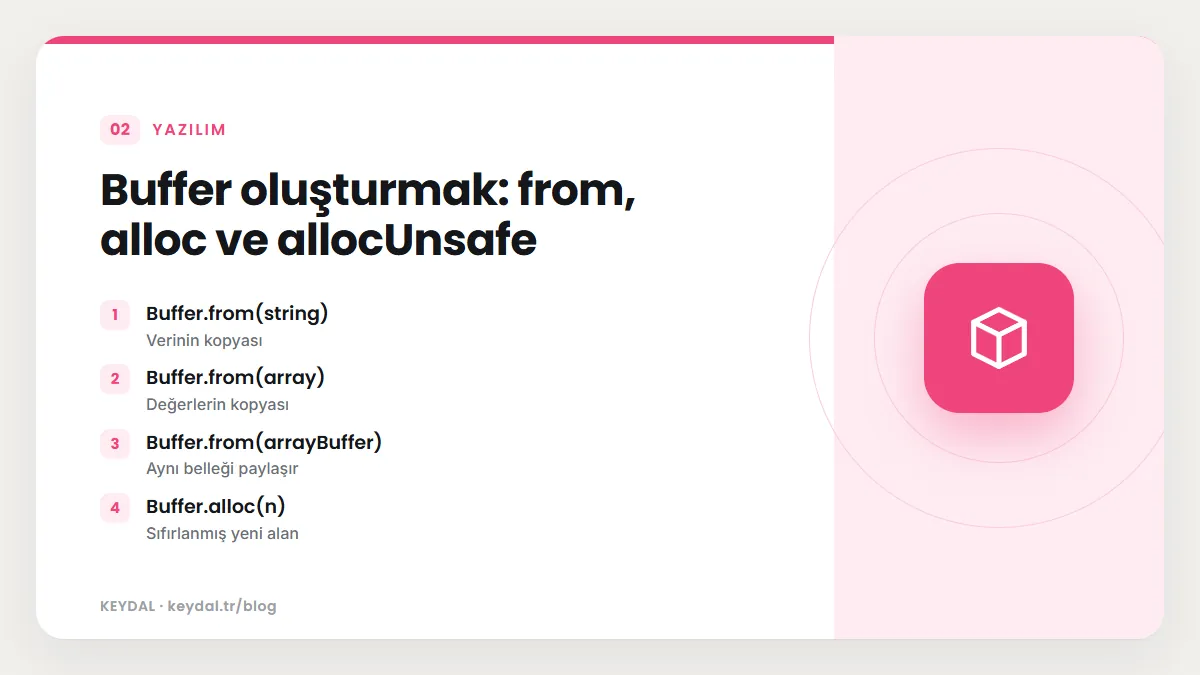
En sık kullanacağınız yöntem Buffer.from()'dur. String, dizi, başka bir buffer ya da ArrayBuffer alabilir. String verdiğinizde varsayılan encoding UTF-8'dir. Sayı dizisi verdiğinizde her eleman 0-255 aralığına sığacak şekilde kırpılır; belgelerin ifadesiyle değer value & 255 işlemiyle daraltılır. Bu yüzden 300 sayısı 0x2c (44), -1 ise 0xff (255) olur:
import { Buffer } from 'node:buffer';

const a = Buffer.from('Merhaba');
const b = Buffer.alloc(4);
const c = Buffer.alloc(4, 'ab');
const d = Buffer.from([72, 105, 300, -1]);

console.log(a); // çıktı: <Buffer 4d 65 72 68 61 62 61>
console.log(b); // çıktı: <Buffer 00 00 00 00>
console.log(c); // çıktı: <Buffer 61 62 61 62>
console.log(d); // çıktı: <Buffer 48 69 2c ff>
console.log(a.length, a.toString()); // çıktı: 7 Merhaba
Buffer.alloc(size, fill) belirtilen boyutta yeni bir buffer ayırır ve onu sıfırla (ya da verdiğiniz fill değeriyle) doldurur. Örnekteki Buffer.alloc(4, 'ab') dört baytlık alanı "ab" desenini tekrarlayarak doldurdu. Buffer.allocUnsafe(size) ise belleği sıfırlamadan ayırır; daha hızlıdır ama içinde önceki işlemlerden kalmış, hassas olabilecek eski veri bulunabilir. Belgeler bu buffer'ın içeriğini tamamen üzerine yazmadan okumanın eski verinin sızmasına yol açabileceği konusunda açıkça uyarır.
| Yöntem | Bellek | Ne zaman |
|---|---|---|
| Buffer.from(string) | Verinin kopyası | Metni bayta çevirirken |
| Buffer.from(array) | Değerlerin kopyası | Bilinen bayt değerlerinden |
| Buffer.from(arrayBuffer) | Aynı belleği paylaşır | TypedArray belleğini görmek için |
| Buffer.alloc(n) | Sıfırlanmış yeni alan | Varsayılan güvenli seçim |
| Buffer.allocUnsafe(n) | Sıfırlanmamış alan | Hemen tamamen dolduracaksanız |
| Buffer.allocUnsafeSlow(n) | Havuz dışı, sıfırlanmamış | Uzun süre tutulacak küçük parçalar |
Belgelerde anlatılan bir ayrıntı daha: Buffer.allocUnsafe(), Buffer.from(string), Buffer.from(array) ve Buffer.concat() küçük boyutlu buffer'ları önceden ayrılmış ortak bir iç havuzdan dilimleyebilir. Havuzun boyutu Buffer.poolSize ile görülür; YAML kayıtlarına göre bu varsayılan değer v26.3.0 ile 8192'den 65536'ya yükseltildi. Buffer.alloc() ise bu havuzu hiçbir zaman kullanmaz. Küçük bir parçayı uzun süre saklayacaksanız belgeler havuz dışı Buffer.allocUnsafeSlow() ile ayrı bir alan açıp ilgili baytları oraya kopyalamayı önerir; aksi halde küçük dilim, havuzdaki büyük bloğun tamamını bellekte tutabilir.
Karakter kodlamaları: utf8, base64, hex, latin1
Buffer ile string arasında dönüşüm yaparken bir encoding belirtebilirsiniz; belirtmezseniz UTF-8 kullanılır. Encoding adları büyük/küçük harfe duyarlı değildir: 'utf8', 'UTF8' ve 'utf-8' aynıdır. Türkçe metinde en önemli nokta, karakter sayısı ile bayt sayısının farklı olmasıdır. "ı", "ş", "ğ" gibi harfler UTF-8'de iki bayt tutar, bu yüzden string.length ile Buffer.byteLength() farklı sonuç verir:
import { Buffer } from 'node:buffer';

const metin = 'Işık ğüş';
console.log(metin.length); // çıktı: 8
console.log(Buffer.byteLength(metin)); // çıktı: 13
console.log(Buffer.byteLength(metin, 'utf16le')); // çıktı: 16

const buf = Buffer.from(metin);
console.log(buf.toString('hex')); // çıktı: 49c59fc4b16b20c49fc3bcc59f
console.log(buf.toString('base64')); // çıktı: ScWfxLFrIMSfw7zFnw==
console.log(buf.toString('base64url')); // çıktı: ScWfxLFrIMSfw7zFnw
console.log(Buffer.from('ScWfxLFrIMSfw7zFnw==', 'base64').toString()); // çıktı: Işık ğüş

console.log(Buffer.from('1ag123', 'hex')); // çıktı: <Buffer 1a>
console.log(Buffer.from('1a7', 'hex')); // çıktı: <Buffer 1a>
console.log(Buffer.isEncoding('UTF-8'), Buffer.isEncoding('windows-1254')); // çıktı: true false
Bu örnekten çıkan dersler şunlardır. HTTP'de Content-Length başlığı gibi bayt sayısı isteyen her yerde Buffer.byteLength() kullanmalısınız; HTTP sunucusu yazısındaki JSON örneği bunu yapar. base64url, URL ve dosya adlarında güvenli alfabeyi kullanır ve buffer'ı string'e çevirirken dolgu karakterini (=) atar. hex çözümlemesi ilk geçersiz karakterde ya da tek kalan basamakta durur ve hata vermeden veriyi keser; bu sessiz kesilme hata ayıklarken şaşırtıcı olabilir.
| Encoding | Türü | Not |
|---|---|---|
| utf8 (utf-8) | Metin | Varsayılan; geçersiz baytlar U+FFFD olur |
| utf16le (ucs2) | Metin | Karakter başına 2 veya 4 bayt, yalnızca little-endian |
| latin1 (binary) | Metin | Yalnızca U+0000-U+00FF, karakter başına 1 bayt |
| base64 | İkiliden metne | Çözerken boşlukları yok sayar, URL güvenli alfabeyi de kabul eder |
| base64url | İkiliden metne | Kodlarken dolgu (=) eklemez |
| hex | İkiliden metne | Her bayt iki onaltılık karakter |
| ascii | Eski | Yalnızca geriye uyumluluk için |
Node'un desteklediği encoding listesinde Windows-1254 (Türkçe Windows kod sayfası) bulunmaz; Buffer.isEncoding('windows-1254') bu yüzden false döndürür. Belgeler ayrıca tarayıcıların WHATWG Encoding standardı gereği latin1 etiketini win-1252 olarak yorumladığını, bu yüzden bir sunucunun latin1 dediği içeriği Node'da 'latin1' ile çözmenin bazı karakterleri yanlış gösterebileceğini not eder. 'binary' adı da yanıltıcıdır: aslında latin1'in takma adıdır ve ikili veri için özel bir anlam taşımaz.
Buffer ve Uint8Array: subarray görünüm, kopya değil
Her Buffer aynı zamanda bir Uint8Array'dir; TypedArray'in tüm yöntemleri ve özellikleri kullanılabilir. Ancak belgeler bazı ince uyumsuzlukları vurgular. En önemlisi dilimleme davranışıdır: TypedArray.prototype.slice() verinin kopyasını üretirken eski Buffer.prototype.slice() kopya oluşturmadan aynı belleğe bakan bir görünüm döndürür. Bu fark yalnızca geriye uyumluluk için vardır ve buf.slice() artık kullanımdan kaldırılmış (Stability: 0 - Deprecated) durumdadır; yerine buf.subarray() önerilir:
import { Buffer } from 'node:buffer';

const asil = Buffer.from('kedi');
const gorunum = asil.subarray(0, 2);
const kopya = Buffer.from(asil.subarray(0, 2));

asil[0] = 0x4b; // 'K'
console.log(gorunum.toString()); // çıktı: Ke
console.log(kopya.toString()); // çıktı: ke

const u8 = new Uint8Array([1, 2, 3]);
const u8dilim = u8.slice(0, 2);
u8[0] = 99;
console.log(u8dilim); // çıktı: Uint8Array(2) [ 1, 2 ]

console.log(asil instanceof Uint8Array); // çıktı: true
console.log(Buffer.isBuffer(u8), Buffer.isBuffer(asil)); // çıktı: false true
subarray() ile aldığınız parça, asıl buffer değiştiğinde onunla birlikte değişti; çünkü iki nesne aynı belleği paylaşıyor. Gerçek bir kopya istiyorsanız Buffer.from(parca) ile yeni bir buffer oluşturun. Bu ayrım özellikle bir ağ akışından gelen büyük parçadan küçük bir başlık kesip uzun süre saklarken önemlidir: görünüm sakladığınız sürece arkadaki büyük bellek de serbest bırakılamaz.
Aynı mantık Buffer.from(arrayBuffer) için de geçerlidir: bir Uint16Array'in kendisini verirseniz değerler kopyalanır ve 0-255 aralığına kırpılır, ama arr.buffer verirseniz Node aynı belleği paylaşan bir buffer oluşturur. Buffer.from(), TypedArray.from()'dan farklı olarak eşleme (map) fonksiyonu da kabul etmez.
Çok baytlı karakterler parçalara bölününce: StringDecoder
Stream'lerden gelen veri rastgele bayt sınırlarında bölünür. Bir Türkçe karakterin iki baytı farklı parçalara düşerse, her parçayı ayrı ayrı toString() ile çevirmek bozuk karakter üretir. Belgelerdeki kurala göre UTF-8 olarak geçerli olmayan bayt dizileri U+FFFD yedek karakterine dönüştürülür. Çözüm ya parçaları önce birleştirip sonra çevirmek ya da node:string_decoder modülünü kullanmaktır:
import { Buffer } from 'node:buffer';
import { StringDecoder } from 'node:string_decoder';

const bayt = Buffer.from('ş'); // 2 bayt: c5 9f
const parca1 = bayt.subarray(0, 1);
const parca2 = bayt.subarray(1);

console.log(parca1.toString() + parca2.toString()); // çıktı: ��
console.log(Buffer.concat([parca1, parca2]).toString()); // çıktı: ş

const cozucu = new StringDecoder('utf8');
let sonuc = cozucu.write(parca1);
sonuc += cozucu.write(parca2);
sonuc += cozucu.end();
console.log(sonuc); // çıktı: şStringDecoder, tamamlanmamış çok baytlı karakteri iç tamponunda tutar ve sonraki write() ya da end() çağrısına kadar bekletir. Pratikte bu işi çoğu zaman siz yapmazsınız: bir okunabilir stream'de setEncoding('utf8') çağırdığınızda ya da fs.createReadStream(dosya, { encoding: 'utf8' }) kullandığınızda Node aynı korumayı sizin için uygular. Elinizdeki tüm parçaları biriktirip sonunda tek seferde çevirecekseniz Buffer.concat() en basit yoldur.
İkili veri okuma ve yazma: readUInt16BE, writeUInt32BE
Dosya biçimleri ve ağ protokolleri çoğu zaman sabit konumlarda sayılar içerir: ilk iki bayt sürüm, sonraki dört bayt uzunluk gibi. Buffer bu iş için readUInt8, readUInt16BE/LE, readInt32BE/LE, readBigUInt64BE, readFloatLE gibi okuma ve bunların write... karşılıklarını sunar. BE (big-endian) en anlamlı baytı önce, LE (little-endian) en az anlamlı baytı önce yazar. Aynı dört baytı farklı sırayla okumak tamamen farklı sayı verir:
import { Buffer } from 'node:buffer';

// Basit bir ikili başlık: 2 bayt sürüm, 4 bayt uzunluk (big-endian)
const baslik = Buffer.alloc(6);
baslik.writeUInt16BE(3, 0);
baslik.writeUInt32BE(1500, 2);
console.log(baslik); // çıktı: <Buffer 00 03 00 00 05 dc>

console.log(baslik.readUInt16BE(0)); // çıktı: 3
console.log(baslik.readUInt32BE(2)); // çıktı: 1500
console.log(baslik.readUInt32LE(2)); // çıktı: 3691315200

try {
  baslik.readUInt32BE(4);
} catch (err) {
  console.log(err.name, err.code); // çıktı: RangeError ERR_OUT_OF_RANGE
  console.log(err.message);
  // çıktı: The value of "offset" is out of range. It must be >= 0 and <= 2. Received 4
}

const a = Buffer.from('abc');
const b = Buffer.from('abd');
console.log(a.equals(Buffer.from('abc')), Buffer.compare(a, b)); // çıktı: true -1
console.log(JSON.stringify(Buffer.from('hi'))); // çıktı: {"type":"Buffer","data":[104,105]}
Okuma yöntemleri sınır dışına taşan bir ofset aldığında sessizce yanlış değer döndürmez, ERR_OUT_OF_RANGE koduyla RangeError fırlatır. Hata mesajı izin verilen aralığı da söyler: 6 baytlık buffer'da 4 baytlık bir sayı en fazla 2. ofsetten başlayabilir. Buffer'ları karşılaştırmak için === kullanmayın; iki ayrı nesne aynı içeriğe sahip olsa bile === nesne kimliğini karşılaştırır. İçerik eşitliği için buf.equals(), sıralama için Buffer.compare() kullanılır. JSON.stringify() bir buffer'ı { type: 'Buffer', data: [...] } biçimine çevirir ve Buffer.from() bu biçimi geri okuyabilir; JSON'un genel kuralları için JSON.parse ve stringify yazısına bakabilirsiniz.
Doğrulama ve dönüştürme yardımcıları
node:buffer modülü buffer içeriğini doğrulayan küçük fonksiyonlar da içerir. isUtf8() girdinin yalnızca geçerli UTF-8 olup olmadığını, isAscii() yalnızca ASCII olup olmadığını söyler. transcode() bir buffer'ı desteklenen encoding'ler (ascii, utf8, utf16le, ucs2, latin1, binary) arasında yeniden kodlar; hedefte karşılığı olmayan karakterler yerine yedek karakter koyar. Belgelere göre Buffer.alloc()'a sayı yerine başka bir tür vermek TypeError üretir:
import { Buffer, isUtf8, transcode } from 'node:buffer';

const iyi = Buffer.from('çay');
const bozuk = Buffer.from([0x63, 0xff, 0x61]);
console.log(isUtf8(iyi), isUtf8(bozuk)); // çıktı: true false
console.log(bozuk.toString()); // çıktı: c�a

const latin = transcode(Buffer.from('café'), 'utf8', 'latin1');
console.log(latin); // çıktı: <Buffer 63 61 66 e9>
console.log(Buffer.poolSize); // çıktı: 65536

try {
  Buffer.alloc('10');
} catch (err) {
  console.log(err.name, err.code); // çıktı: TypeError ERR_INVALID_ARG_TYPE
}
Dışarıdan gelen veriyi metin olarak işlemeden önce isUtf8() ile kontrol etmek, sessiz U+FFFD dönüşümlerini fark etmenizi sağlar. v26 sürüm çizgisinde iki yeni yardımcı daha eklendi: YAML kayıtlarına göre Buffer.stringLength() ve buffer.isLatin1() v26.11.0 ile geldi. Buffer.stringLength(buf), baytları çözmeden buf.toString()'in üreteceği string'in UTF-16 uzunluğunu verir; Buffer.byteLength()'ın tersi gibi düşünebilirsiniz:
import { Buffer } from 'node:buffer';

const buf = Buffer.from('çay 5₺');
console.log(buf.length, Buffer.stringLength(buf)); // çıktı: 9 6
console.log(buf.toString().length); // çıktı: 6Uygulamalı mini örnek: base64 ile gelen veriyi doğrulamak
Bir API'nin size JSON içinde base64 kodlu bir dosya gönderdiğini düşünün. Yapmanız gerekenler sırasıyla şunlardır: string'i Buffer.from(deger, 'base64') ile çözmek, boyutu buf.length ile kontrol etmek (string uzunluğu değil), metin bekliyorsanız isUtf8() ile doğrulamak ve ancak ondan sonra toString() çağırmak. Base64 çözümlemesi boşluk karakterlerini yok saydığı için kullanıcıdan gelen satır sonları sorun çıkarmaz, ama Buffer.byteLength(str, 'base64') belgelere göre geçerli girdi varsayar ve boşluk içeren girdide gerçek buffer boyutundan büyük sonuç verebilir. Kesin boyut için önce çözüp sonra length'e bakın.
Sık yapılan hatalar
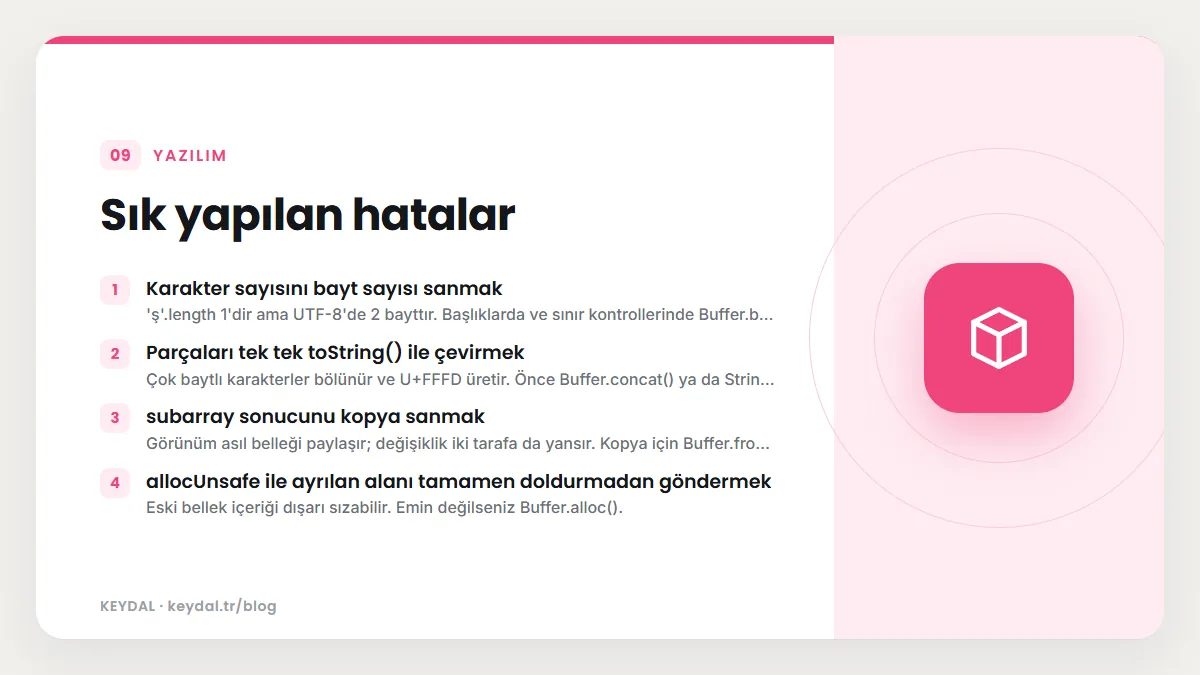
- Karakter sayısını bayt sayısı sanmak:
'ş'.length1'dir ama UTF-8'de 2 bayttır. Başlıklarda ve sınır kontrollerindeBuffer.byteLength()kullanın. - Parçaları tek tek toString() ile çevirmek: Çok baytlı karakterler bölünür ve U+FFFD üretir. Önce
Buffer.concat()ya daStringDecoderkullanın. - subarray sonucunu kopya sanmak: Görünüm asıl belleği paylaşır; değişiklik iki tarafa da yansır. Kopya için
Buffer.from(parca). - allocUnsafe ile ayrılan alanı tamamen doldurmadan göndermek: Eski bellek içeriği dışarı sızabilir. Emin değilseniz
Buffer.alloc(). - Buffer'ları === ile karşılaştırmak: İçerik değil nesne kimliği karşılaştırılır;
equals()kullanın. - new Buffer() kullanmak: Kullanımdan kaldırılmıştır ve argüman türüne göre farklı davranır.
Sık Sorulan Sorular
Buffer ile Uint8Array arasında hangisini kullanmalıyım?
Node API'leri ikisini de kabul eder. Tarayıcıyla paylaşılacak kodda Uint8Array daha taşınabilirdir; encoding dönüşümü, ikili sayı okuma ya da Buffer.concat gerekiyorsa Buffer daha pratiktir. Belgelere göre Buffer.prototype yöntemleri bir Uint8Array üzerinde de çağrılabilir.
Bir Buffer en fazla ne kadar büyük olabilir?
Sınır buffer.constants.MAX_LENGTH değeridir. Belgelere göre 64 bit mimarilerde Number.MAX_SAFE_INTEGER (yaklaşık 8 PiB), 32 bit mimarilerde 2^31 - 1 (yaklaşık 2 GiB). Pratikte sınırdan çok önce kullanılabilir bellek biter; büyük dosyaları belleğe almak yerine stream kullanın.
Türkçe Windows-1254 kodlu bir dosyayı nasıl okurum?
Buffer'ın encoding listesinde Windows-1254 yoktur. Global TextDecoder farklı kodlamalar destekleyebilir, ancak bu yazının kaynağı olan buffer belgesi bunu kapsamaz; kullanmadan önce Node.js belgelerindeki TextDecoder bölümüne bakın.
Buffer.from(string) ile Buffer.alloc arasındaki fark nedir?
Buffer.from(string) metnin baytlarının kopyasını içeren, tam gerektiği kadar büyük bir buffer üretir. Buffer.alloc(n) ise içeriği sıfır olan n baytlık boş bir alan ayırır; sonradan write() ya da writeUInt... ile doldurursunuz.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: Node.js öğrenme rehberi · Node.js stream nedir · Node.js dosya okuma · Node.js crypto hash ve HMAC · Node.js zlib ile sıkıştırma · JavaScript string metotları