Python'da JSON ile çalışmak için standart kütüphanedeki json modülü yeterlidir: json.dumps() bir Python nesnesini JSON metnine, json.loads() JSON metnini Python nesnesine çevirir. Dosyayla çalışırken aynı işi json.dump() ve json.load() yapar. Türkçe karakterlerin \u00e7 gibi kaçış dizilerine dönüşmemesi için ensure_ascii=False, okunabilir çıktı için indent=2 kullanırsınız. Modül Python ile birlikte gelir; ayrıca paket kurmanız gerekmez.
Bu yazıda dönüşüm tablosunu, anahtarların neden her zaman metne dönüştüğünü, datetime ya da set gibi JSON'un tanımadığı tipleri nasıl çevireceğinizi, okurken object_hook, parse_float ve Python 3.15 ile gelen array_hook parametrelerini, hata mesajlarını ve komut satırı aracını göreceksiniz. Örneklerin tamamı Python 3.15.2 ile çalıştırıldı ve çıktı yorumları gerçek çıktıdır. Python'a yeni başlıyorsanız önce Python öğrenme rehberi sayfasındaki sıralamaya göz atabilirsiniz.
Dört temel fonksiyon: dumps, loads, dump, load
İsimlerin sonundaki s harfi “string” anlamına gelir. dumps ve loads bellekteki bir str ile çalışır; dump ve load ise açık bir dosya nesnesine yazar ya da ondan okur. Belgelere göre loads() girdi olarak str dışında bytes ve bytearray da kabul eder; bu durumda verinin UTF-8, UTF-16 ya da UTF-32 ile kodlanmış olması gerekir. Yazma tarafında ise modül her zaman str üretir, bytes üretmez; bu yüzden dump() ile kullanacağınız dosyanın metin kipinde açılmış olması gerekir.
import json

urun = {"ad": "Çay bardağı", "fiyat": 49.9, "stokta": True, "etiketler": ["mutfak", "cam"], "indirim": None}
metin = json.dumps(urun)
print(metin)
# çıktı: {"ad": "\u00c7ay barda\u011f\u0131", "fiyat": 49.9, "stokta": true, "etiketler": ["mutfak", "cam"], "indirim": null}
print(json.dumps(urun, ensure_ascii=False))
# çıktı: {"ad": "Çay bardağı", "fiyat": 49.9, "stokta": true, "etiketler": ["mutfak", "cam"], "indirim": null}
geri = json.loads(metin)
print(geri == urun, type(geri["etiketler"]).__name__)
# çıktı: True list
print(json.dumps((1, 2)), json.loads("[1, 2]"))
# çıktı: [1, 2] [1, 2]
Çıktıda üç ayrıntı dikkat çekiyor. Birincisi, True küçük harfle true, None ise null olarak yazıldı; JSON'un kendi sözcükleri bunlardır. İkincisi, varsayılan ayarda Ç, ğ ve ı harfleri \u00c7 biçiminde kaçırıldı. Bu bir hata değildir, geçerli JSON'dur ve geri okunduğunda aynı metni verir; yalnızca insan gözüyle okunması zordur. Üçüncüsü, tuple JSON'a dizi olarak yazılır ama geri okunduğunda liste olur. Yani (1, 2) ile başlayıp [1, 2] ile dönersiniz.
Python ve JSON tip dönüşüm tablosu
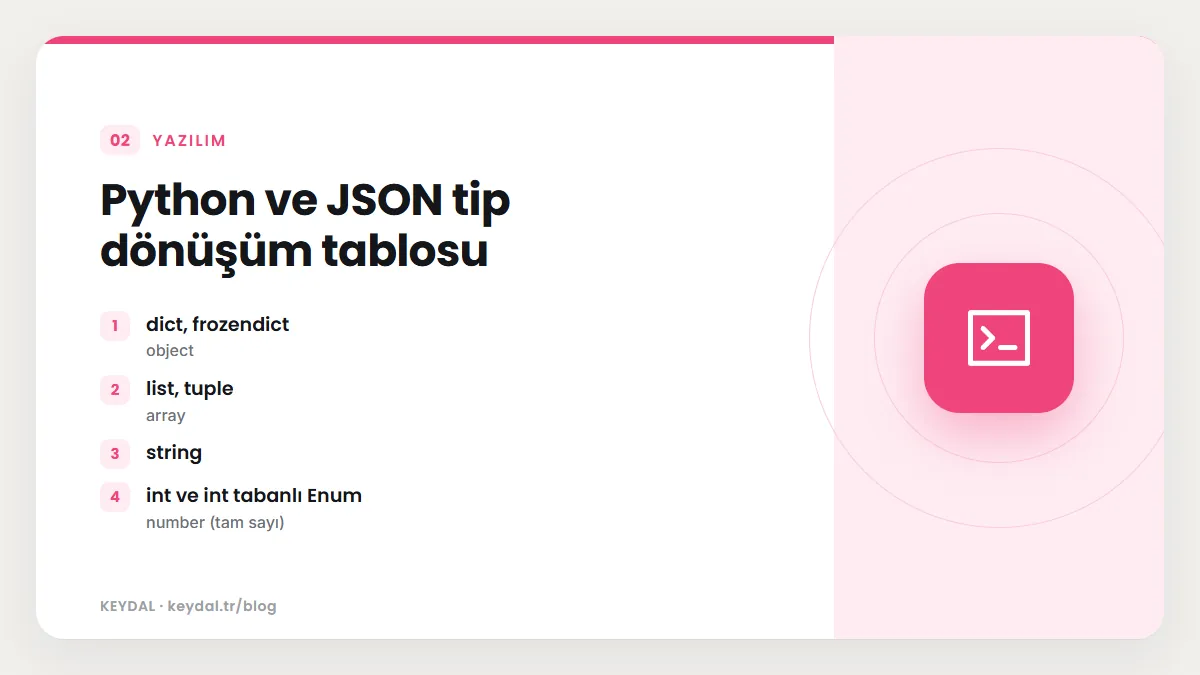
Kodlayıcı (encoder) ve çözücü (decoder) aşağıdaki eşlemeyi kullanır. Tablo, belgedeki iki ayrı tablonun birleştirilmiş hâlidir. Python 3.15 ile frozendict de nesne olarak yazılabilen tipler arasına girdi.
| Python (yazarken) | JSON | Python (okurken) |
|---|---|---|
| dict, frozendict | object | dict |
| list, tuple | array | list |
| str | string | str |
| int ve int tabanlı Enum | number (tam sayı) | int |
| float ve float tabanlı Enum | number (ondalıklı) | float |
| True / False | true / false | True / False |
| None | null | None |
Bu tabloda olmayan her tip, örneğin datetime, date, Decimal, set, kendi yazdığınız sınıflar ya da bytes, varsayılan ayarlarla TypeError verir. Bunları nasıl çevireceğinizi aşağıda ayrı bir başlıkta göreceksiniz.
Okunabilir çıktı: indent, sort_keys ve separators
indent pozitif bir tam sayıysa her seviye o kadar boşlukla girintilenir; bir metin verirseniz (örneğin "\t") her seviye için o metin kullanılır. Sıfır, negatif sayı ya da boş metin verdiğinizde girinti eklenmez ama her öğe yeni satıra geçer. sort_keys=True sözlükleri anahtara göre sıralar; belgeler bunun özellikle testlerde iki çıktıyı gün gün karşılaştırmak için yararlı olduğunu söyler. separators ise öğe ve anahtar ayırıcılarını belirleyen iki elemanlı bir tuple'dır.
import json

veri = {"sehir": "İzmir", "ilce": ["Bornova", "Karşıyaka"], "kod": 35}
print(json.dumps(veri, ensure_ascii=False, indent=2, sort_keys=True))
# çıktı: {
# çıktı:   "ilce": [
# çıktı:     "Bornova",
# çıktı:     "Karşıyaka"
# çıktı:   ],
# çıktı:   "kod": 35,
# çıktı:   "sehir": "İzmir"
# çıktı: }
print(json.dumps(veri, ensure_ascii=False, separators=(",", ":")))
# çıktı: {"sehir":"İzmir","ilce":["Bornova","Karşıyaka"],"kod":35}
separators verilmediğinde varsayılan değer duruma göre değişir: indent yoksa (', ', ': '), indent varsa satır sonlarında gereksiz boşluk kalmasın diye (',', ': ') kullanılır. En küçük çıktıyı istiyorsanız, örneğin bir API yanıtında birkaç bayt kazanmak için, (',', ':') verin. Okunabilirlik ile boyut arasında tercih yapmanız gerekir; insanların okuyacağı yapılandırma dosyalarında girintili, makineler arası trafikte sıkıştırılmış biçim mantıklıdır.
| Ayar | Etkisi | Ne zaman |
|---|---|---|
| ensure_ascii=False | Türkçe ve diğer ASCII dışı karakterler olduğu gibi yazılır | İnsanın okuyacağı dosyalar, UTF-8 kullanan sistemler |
| indent=2 veya 4 | Her seviye yeni satır ve girinti | Yapılandırma, log incelemesi |
| sort_keys=True | Anahtarlar sıralanır | Testler, sürüm kontrolünde fark okuma |
| separators=(",", ":") | Boşluksuz en kısa çıktı | Ağ trafiği, büyük veri |
| allow_nan=False | nan ve inf için ValueError | Standarda sıkı uyum gerektiğinde |
Anahtarlar neden hep metne dönüşür?
JSON'da nesne anahtarları her zaman metindir. Python sözlüğünüzde tam sayı, ondalıklı sayı, bool ya da None anahtarlar varsa modül bunları metne çevirerek yazar. Geri okuduğunuzda anahtarlar metin olarak kalır; belgeler bunu açıkça belirtir: metin olmayan anahtarlar içeren bir sözlükte loads(dumps(x)) != x olabilir. Tuple gibi bu beş tipten biri olmayan anahtarlar ise doğrudan hata verir. skipkeys=True bu anahtarları sessizce atlar.
import json

puanlar = {1: "bir", 2.5: "iki buçuk", False: "hayır", None: "boş"}
s = json.dumps(puanlar, ensure_ascii=False)
print(s)
# çıktı: {"1": "bir", "2.5": "iki buçuk", "false": "hayır", "null": "boş"}
print(json.loads(s) == puanlar)
# çıktı: False
print(json.dumps({10: "a", 9: "b"}, sort_keys=True))
# çıktı: {"9": "b", "10": "a"}
try:
    json.dumps({(1, 2): "nokta"})
except TypeError as e:
    print(type(e).__name__, e)
# çıktı: TypeError keys must be str, int, float, bool or None, not tuple
print(json.dumps({(1, 2): "nokta", "x": 1}, skipkeys=True))
# çıktı: {"x": 1}
Üçüncü satır ince bir ayrıntıyı gösteriyor: sort_keys sıralamayı anahtarlar metne çevrilmeden önce yapar. Bu yüzden 9, 10'dan önce geldi; metin olarak sıralansaydı “10” önce gelirdi. Sayısal kimlikleri sözlük anahtarı yaptığınız bir yapıyı JSON'a yazıp geri okuyorsanız, okuduktan sonra int() ile çevirmeyi unutmayın; aksi hâlde veri[5] yerine veri["5"] yazmanız gerekir ve bu, en sık karşılaşılan şaşırtıcı hatalardan biridir.
JSON tanımayan tipler: default ve JSONEncoder
Bir sipariş kaydında tarih ve küme varsa doğrudan dumps() çağrısı başarısız olur. Python 3.14'ten beri bu hatalara bir istisna notu (exception note) eklenir; not, sorunun iç içe yapıda tam olarak nerede olduğunu söyler. Büyük bir sözlükte hangi alanın sorun çıkardığını bulmak bu sayede kolaylaşır.
import json
from datetime import date

siparis = {"no": 1042, "tarih": date(2026, 11, 7), "etiketler": {"hızlı", "kargo"}}
try:
    json.dumps(siparis)
except TypeError as e:
    print(type(e).__name__ + ":", e)
    print(e.__notes__)
# çıktı: TypeError: Object of type date is not JSON serializable
# çıktı: ["when serializing dict item 'tarih'"]
Çözüm için iki yol vardır. Basit olanı, default parametresine bir fonksiyon vermektir. Kodlayıcı tanımadığı her nesne için bu fonksiyonu çağırır; fonksiyon JSON'a yazılabilen bir değer döndürmeli ya da tanımadığı tip için kendisi TypeError fırlatmalıdır. İkinci yol, json.JSONEncoder sınıfından türetip default() metodunu ezmektir; tanımadığınız tiplerde super().default(o) çağırarak hatayı temel sınıfa bırakırsınız. Sınıf yaklaşımı aynı kuralları birçok yerde kullanacaksanız ve cls= ile tek noktadan vermek istiyorsanız kullanışlıdır.
import json
from datetime import date

def donustur(o):
    if isinstance(o, date):
        return o.isoformat()
    if isinstance(o, set):
        return sorted(o)
    raise TypeError(f"{type(o).__name__} JSON'a çevrilemez")

siparis = {"no": 1042, "tarih": date(2026, 11, 7), "etiketler": {"hızlı", "kargo"}}
print(json.dumps(siparis, default=donustur, ensure_ascii=False))
# çıktı: {"no": 1042, "tarih": "2026-11-07", "etiketler": ["hızlı", "kargo"]}

class Kodlayici(json.JSONEncoder):
    def default(self, o):
        if isinstance(o, date):
            return o.isoformat()
        return super().default(o)

print(json.dumps({"t": date(2026, 1, 2)}, cls=Kodlayici))
# çıktı: {"t": "2026-01-02"}
try:
    json.dumps({"t": 1 + 2j}, cls=Kodlayici)
except TypeError as e:
    print(e)
# çıktı: Object of type complex is not JSON serializable
Kümeyi sorted() ile listeye çevirmemizin nedeni, kümelerin sırasının garanti olmamasıdır; sıralı liste her çalıştırmada aynı çıktıyı verir. Tarihleri ISO 8601 biçiminde (2026-11-07) yazmak, okurken date.fromisoformat() ile geri çevirmeyi kolaylaştırır. Tarih ve saat nesnelerinin ayrıntısı için datetime rehberine bakabilirsiniz. Veri sınıflarını JSON'a yazmak istiyorsanız dataclasses.asdict() ile önce sözlüğe çevirmek yaygın bir yoldur; bu konu dataclasses yazısında anlatılıyor.
Okurken dönüştürme: object_hook, parse_float ve array_hook
loads() ve load() çözümleme sırasında araya girmenizi sağlayan kancalar sunar. object_hook her JSON nesnesi sözlüğe çevrildikten sonra o sözlükle çağrılır ve döndürdüğü değer sözlüğün yerine geçer. object_pairs_hook aynı işi sözlük yerine sıralı bir (anahtar, değer) çiftleri listesiyle yapar; ikisi birlikte verilirse object_pairs_hook önceliklidir. parse_float ve parse_int, sayıların metin hâliyle çağrılır. Para tutarları gibi ondalık hassasiyetinin önemli olduğu veriler için parse_float=Decimal kullanmak, 12.10 değerindeki sondaki sıfırı bile korur.
Python 3.15'te eklenen array_hook ise her JSON dizisi listeye çevrildikten sonra çağrılır. What's New belgesi, object_pairs_hook=frozendict ile array_hook=tuple birlikte verildiğinde baştan sona değiştirilemez (immutable) bir yapı elde edileceğini örnek olarak gösterir. Böyle bir yapı hash'lenebilir; yani sözlük anahtarı ya da küme elemanı olarak kullanılabilir.
import json
from decimal import Decimal

metin = '{"urun": "Kalem", "fiyat": 12.10, "adet": 3, "boyut": [14, 0.7]}'
print(json.loads(metin))
# çıktı: {'urun': 'Kalem', 'fiyat': 12.1, 'adet': 3, 'boyut': [14, 0.7]}
print(json.loads(metin, parse_float=Decimal))
# çıktı: {'urun': 'Kalem', 'fiyat': Decimal('12.10'), 'adet': 3, 'boyut': [14, Decimal('0.7')]}
print(json.loads(metin, array_hook=tuple))
# çıktı: {'urun': 'Kalem', 'fiyat': 12.1, 'adet': 3, 'boyut': (14, 0.7)}

def tarih_coz(d):
    if "tarih" in d:
        from datetime import date
        d["tarih"] = date.fromisoformat(d["tarih"])
    return d

print(json.loads('{"no": 1, "tarih": "2026-11-07"}', object_hook=tarih_coz))
# çıktı: {'no': 1, 'tarih': datetime.date(2026, 11, 7)}
dondurulmus = json.loads('{"ad": "nokta", "koord": [1, 2]}', object_pairs_hook=frozendict, array_hook=tuple)
print(dondurulmus)
# çıktı: frozendict({'ad': 'nokta', 'koord': (1, 2)})
print(hash(dondurulmus) == hash(frozendict(koord=(1, 2), ad="nokta")))
# çıktı: True
Son örnekteki frozendict Python 3.15'te yerleşik tip olarak geldi, bu yüzden içe aktarmadan kullanılabildi. Bu kod 3.14 ve öncesinde çalışmaz: hem frozendict hem array_hook yoktur. 3.15'in diğer yenilikleri için Python 3.15 yenilikleri yazısına, sözlüklerin ayrıntısı için sözlük metotları rehberine bakabilirsiniz.
Dosyaya yazma ve okuma
Dosyayla çalışırken iki kurala dikkat edin. Birincisi, dosyayı encoding="utf-8" ile açın. Python 3.15'te UTF-8 kipi varsayılan olsa da kodlamayı açıkça yazmak, kodunuzun eski sürümlerde de aynı davranmasını sağlar ve niyetinizi belli eder. İkincisi, ensure_ascii=False kullanıyorsanız dosyanın gerçekten UTF-8 olarak yazıldığından emin olun. Dosya açma kipleri ve kodlama konusunun tamamı dosya okuma ve yazma yazısında anlatılıyor.
import json

ayarlar = {"tema": "koyu", "dil": "tr", "yazı_boyutu": 14}
with open("ayarlar.json", "w", encoding="utf-8") as f:
    json.dump(ayarlar, f, ensure_ascii=False, indent=2)

with open("ayarlar.json", encoding="utf-8") as f:
    okunan = json.load(f)
print(okunan)
# çıktı: {'tema': 'koyu', 'dil': 'tr', 'yazı_boyutu': 14}
Sık yapılan bir hata, aynı dosyaya art arda birden fazla dump() çağrısı yapmaktır. Belgeler JSON'un çerçeveli (framed) bir protokol olmadığını, bu yüzden böyle bir dosyanın geçersiz olacağını belirtir. İki nesne yan yana yazılır ve okuyucu ilk nesneden sonra “Extra data” hatası verir. Birden fazla kaydı tek dosyada tutmanın iki doğru yolu vardır: hepsini bir listeye koyup tek seferde yazmak ya da her satıra bir JSON belgesi yazmak (JSON Lines). İkinci yöntem log ve olay kayıtları için uygundur, çünkü dosyanın tamamını belleğe almadan satır satır işleyebilirsiniz.
import json

with open("iki.json", "w", encoding="utf-8") as f:
    json.dump({"a": 1}, f)
    json.dump({"b": 2}, f)
with open("iki.json", encoding="utf-8") as f:
    icerik = f.read()
print(icerik)
# çıktı: {"a": 1}{"b": 2}
try:
    json.loads(icerik)
except json.JSONDecodeError as e:
    print(e)
# çıktı: Extra data: line 1 column 9 (char 8)

kayitlar = [{"olay": "giriş", "kullanici": "ayse"}, {"olay": "çıkış", "kullanici": "ayse"}]
with open("olaylar.jsonl", "w", encoding="utf-8") as f:
    for k in kayitlar:
        f.write(json.dumps(k, ensure_ascii=False) + "\n")
with open("olaylar.jsonl", encoding="utf-8") as f:
    for satir in f:
        print(json.loads(satir)["olay"])
# çıktı: giriş
# çıktı: çıkış
Sonunda fazladan veri olan bir metinden yalnızca ilk belgeyi okumanız gerekirse json.JSONDecoder().raw_decode() kullanılabilir. Bu metot (nesne, bitiş konumu) çiftini döndürür; yukarıdaki icerik için sonuç ({'a': 1}, 8) olur. Dosya yollarıyla daha rahat çalışmak isterseniz Path.read_text() ve json.loads() birlikteliği de iyi bir seçenektir; pathlib rehberine bakabilirsiniz.
Hata mesajlarını okumak: JSONDecodeError
Geçersiz JSON okunduğunda json.JSONDecodeError fırlatılır. Bu sınıf ValueError'dan türediği için except ValueError da onu yakalar. Nesnenin msg, pos, lineno ve colno öznitelikleri hatanın yerini verir. En sık dört hata şunlardır: tek tırnak kullanmak (JSON yalnızca çift tırnak kabul eder), sondaki fazla virgül, kapanmamış parantez ve boş metin.
import json

for bozuk in ["{'ad': 'Ali'}", '{"ad": "Ali",}', '{"ad": "Ali"', '']:
    try:
        json.loads(bozuk)
    except json.JSONDecodeError as e:
        print(f"{e.msg} | satır {e.lineno}, sütun {e.colno}, konum {e.pos}")
# çıktı: Expecting property name enclosed in double quotes | satır 1, sütun 2, konum 1
# çıktı: Illegal trailing comma before end of object | satır 1, sütun 13, konum 12
# çıktı: Expecting ',' delimiter | satır 1, sütun 13, konum 12
# çıktı: Expecting value | satır 1, sütun 1, konum 0
print(issubclass(json.JSONDecodeError, ValueError))
# çıktı: True
Boş metinde gelen Expecting value mesajı çoğu zaman JSON'un kendisinde değil, veriyi getiren adımda bir sorun olduğunu gösterir: dosya boş olabilir ya da bir web servisi JSON yerine boş yanıt veya HTML hata sayfası döndürmüş olabilir. Tek tırnaklı metin genellikle bir Python sözlüğünün str() ile yazdırılmış hâlidir; bu durumda sorunun kaynağı JSON yerine print() çıktısını kaydetmektir. Python'daki istisna yönetiminin genel kuralları için try-except rehberine göz atın.
Standarda uyum: NaN, tekrar eden anahtarlar ve büyük sayılar
Modül varsayılan ayarlarla RFC 7159'u harfiyen uygulamaz ve geçerli JavaScript olan ama geçerli JSON olmayan iki uzantıyı kabul eder. Birincisi NaN, Infinity ve -Infinity değerleridir: Python'daki float('nan') bu adlarla yazılır ve geri okunur. Başka bir dildeki sıkı bir çözücü bu çıktıyı reddedebilir. Yazarken allow_nan=False ile ValueError alırsınız; okurken parse_constant ile bu değerleri reddedebilirsiniz.
import json

print(json.dumps([float("nan"), float("inf"), -float("inf")]))
# çıktı: [NaN, Infinity, -Infinity]
try:
    json.dumps(float("nan"), allow_nan=False)
except ValueError as e:
    print(e)
# çıktı: Out of range float values are not JSON compliant: nan

def reddet(sabit):
    raise ValueError(f"geçersiz JSON sayısı: {sabit}")

try:
    json.loads('{"oran": NaN}', parse_constant=reddet)
except ValueError as e:
    print(e)
# çıktı: geçersiz JSON sayısı: NaN
print(json.dumps(2**70), json.loads("1e400"))
# çıktı: 1180591620717411303424 inf
İkinci uzantı, aynı nesnede tekrar eden anahtarlardır. Modül hata vermez, son değeri tutar: '{"x": 1, "x": 2, "x": 3}' okunduğunda sonuç {'x': 3} olur. Bu davranışı değiştirmek için belgeler object_pairs_hook parametresini önerir; aşağıdaki fonksiyon tekrar eden anahtar gördüğünde hata fırlatır.
import json

def tekrar_yok(ciftler):
    anahtarlar = [k for k, _ in ciftler]
    tekrar = {k for k in anahtarlar if anahtarlar.count(k) > 1}
    if tekrar:
        raise ValueError(f"tekrarlanan anahtar: {sorted(tekrar)}")
    return dict(ciftler)

try:
    json.loads('{"x": 1, "y": 0, "x": 2}', object_pairs_hook=tekrar_yok)
except ValueError as e:
    print(e)
# çıktı: tekrarlanan anahtar: ['x']
Büyük sayılar konusunda da dikkatli olun. Python 2**70 gibi bir tam sayıyı eksiksiz yazar, ancak belgeler JSON'u okuyan birçok sistemin sayıları IEEE 754 çift duyarlıklı ondalık sayıya çevirdiğini ve bu yüzden hassasiyet kaybı yaşanabileceğini hatırlatır. Tarayıcıdaki JavaScript bu değeri tam olarak saklayamaz. Çok büyük kimlikleri ya da Decimal tutarları başka sistemlere gönderiyorsanız metin olarak yazmak daha güvenlidir. Ayrıca belgeler güvenilmeyen kaynaklardan gelen JSON için bir uyarı içerir: kötü niyetli bir girdi çözücünün çok fazla işlemci ve bellek tüketmesine yol açabilir, bu yüzden okunacak verinin boyutunu sınırlamanız önerilir.
Komut satırından JSON doğrulama: python -m json
Modül bir betik olarak da çalışır ve bir JSON dosyasını doğrulayıp girintili olarak yazdırır. Python 3.14'ten beri önerilen yazım python -m json biçimidir; eski python -m json.tool hâlâ çalışır ama yumuşak kullanımdan kaldırılmış (soft deprecated) durumdadır. Yine 3.14 ile çıktı varsayılan olarak renkli gösterilir. Dosya adı vermezseniz standart girdiden okur. --sort-keys, --no-ensure-ascii, --indent, --tab, --compact ve her satırı ayrı belge olarak okuyan --json-lines seçenekleri vardır.
python -m json ayarlar.json
python -m json --no-ensure-ascii --sort-keys veri.json
python -m json --compact veri.json
echo '{1.2:3.4}' | python -m json
# Expecting property name enclosed in double quotes: line 1 column 2 (char 1)
Geçersiz girdi verildiğinde komut hata mesajını yazdırıp sıfırdan farklı bir çıkış koduyla biter; bu yüzden bir kabuk betiğinde ya da CI adımında dosyanın geçerli JSON olup olmadığını denetlemek için kullanılabilir. Denememizde --no-ensure-ascii verilmediğinde İ harfinin \u0130 olarak yazıldığını gördük; Türkçe içerikli dosyaları incelerken bu seçeneği eklemek okumayı kolaylaştırır.
Sık yapılan hatalar
- Python sözlüğünü
str(sozluk)ile yazıp JSON sanmak. Çıktı tek tırnaklı olur veloads()bunu okuyamaz; her zamanjson.dumps()kullanın. ensure_asciivarsayılanını unutup Türkçe harflerin bozulduğunu düşünmek.\u011fbozulma değil kaçış dizisidir; okunabilir çıktı içinensure_ascii=Falseverin.- Sayısal anahtarlarla sözlük yazıp geri okuduktan sonra
veri[5]aramak. Anahtar artık"5"metnidir. - Aynı dosyaya birden fazla
dump()yapmak. Liste ya da JSON Lines kullanın. defaultfonksiyonunda tanınmayan tipler için hata fırlatmamak ve sessiznulldeğerleri üretmek.- Para tutarlarını
floatolarak okumak. Hassasiyet gerekiyorsaparse_float=Decimalkullanın.
Sık Sorulan Sorular
json.dumps ile json.dump arasındaki fark nedir?
dumps() sonucu bir str olarak döndürür; dump() ise aynı metni doğrudan verdiğiniz dosya nesnesine yazar. Parametreleri aynıdır. Okuma tarafında loads() ile load() arasında da aynı ilişki vardır.
Türkçe karakterler neden \u00e7 gibi görünüyor?
ensure_ascii varsayılan olarak True'dur ve ASCII dışındaki tüm karakterleri kaçış dizisine çevirir. Veri bozulmaz; geri okunduğunda aynı metin elde edilir. Okunabilir çıktı için ensure_ascii=False verin ve dosyayı UTF-8 ile yazın. Karakter kodlaması konusu Unicode ve Türkçe karakter yazısında ayrıntılı anlatılıyor.
datetime nesnesini JSON'a nasıl yazarım?
JSON'un tarih tipi yoktur. default parametresine tarihleri isoformat() ile metne çeviren bir fonksiyon verin; okurken object_hook içinde fromisoformat() ile geri çevirin. Yukarıdaki örneklerde iki yön de gösterildi.
Sözlüğün anahtar sırası korunur mu?
Evet. Belgelere göre kodlayıcı ve çözücü girdi ve çıktı sırasını varsayılan olarak korur; sıra ancak alttaki kap sırasız bir yapıysa kaybolur. Alfabetik sıra istiyorsanız sort_keys=True verin.
JSON yerine pickle kullanabilir miyim?
pickle Python'a özgü nesneleri saklar ama başka dillerle uyumlu değildir. JSON ise metin tabanlıdır ve hemen her dilde okunur. Farklı sistemler arasında veri alışverişi için JSON, yalnızca Python içinde kalan geçici veriler için diğer seçenekler düşünülebilir.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: Python öğrenme rehberi · datetime ile tarih ve saat · dosya okuma ve yazma · pathlib · csv modülü · sqlite3 veritabanı · sözlük metotları · CSV ve JSON dönüşümü