MongoDB'de aggregation sonucunu bir koleksiyona yazmanın iki yolu vardır: $out hedef koleksiyonu sonuçla tamamen değiştirir, $merge ise sonucu mevcut koleksiyona belge belge birleştirir (ekler, günceller, korur ya da atar). İkisi de pipeline'ın son aşaması olmak zorundadır. Önceden hesaplanmış bu sonuç koleksiyonlarına on-demand materialized view denir; her sorguda yeniden hesaplanan standart view'lardan farklı olarak diskte saklanır.
Bu yazıda iki aşamanın söz dizimini ve seçeneklerini, aralarındaki farkları, $merge ile artımlı olarak tazelenen bir özet koleksiyonunun nasıl kurulacağını ve db.createView() ile oluşturulan standart view'ların ne zaman daha uygun olduğunu anlatıyoruz. Pipeline aşamalarına yeniyseniz aggregation pipeline yazısıyla başlayın.
$out: sonucu yeni bir koleksiyona yazmak
$out iki biçimde yazılır. Dize verirseniz sonuç aynı veritabanındaki o koleksiyona gider; belge verirseniz hedef veritabanını da seçersiniz:
// Aynı veritabanına
{ $out: "aylikRapor" }

// Başka bir veritabanına
{ $out: { db: "raporlar", coll: "aylikRapor" } }
Replica set veya standalone sunucuda hedef veritabanı yoksa $out onu da oluşturur. MongoDB 7.0.3 ve 7.1'den beri timeseries seçeneğiyle time series koleksiyonuna da yazabilir; bu durumda timeField zorunludur. Time series koleksiyonlarının ayrıntıları time series yazısında anlatılıyor.
Mevcut koleksiyonun yerine geçme
Hedef koleksiyon zaten varsa $out onu aggregation tamamlandığında atomik olarak değiştirir. Belgelerdeki adımlar şöyledir: önce geçici bir koleksiyon oluşturulur, mevcut koleksiyonun indeks tanımları buraya kopyalanır, belgeler geçici koleksiyona yazılır ve son olarak renameCollection komutu dropTarget: true ile çalışarak geçici koleksiyonu hedefin yerine koyar.
Bu tasarımın pratik sonuçları önemlidir. Yeni bir koleksiyon aggregation bitene kadar görünmez; aggregation başarısız olursa koleksiyon hiç oluşmaz. Mevcut bir koleksiyon üzerine yazarken hata çıkarsa eski koleksiyona dokunulmaz. İndeks tanımları korunduğu için raporu okuyan sorgularınız aynı indekslerle çalışmaya devam eder. Öte yandan sonuçlar bir unique indeksi (hedefin _id indeksi dahil) ihlal ederse pipeline tamamlanamaz.
$out kısıtları
- Hedef sharded bir koleksiyon olamaz (girdi koleksiyonu sharded olabilir). Sharded hedef için
$mergekullanılır. - Capped koleksiyona yazamaz.
- Transaction içinde, view tanımında,
$lookup,$facetve$unionWithalt pipeline'larında kullanılamaz. - Hedef koleksiyonda schema validation varsa ve
validationActiondeğerierrorise, geçersiz bir belge işlemi hata ile durdurur; mevcut koleksiyon değişmez. --oplogseçeneğiyle çalışan birmongodumpsürerken bir istemci$outiçeren aggregation çalıştırırsa döküm başarısız olur.
$merge: sonucu mevcut koleksiyonla birleştirmek
$merge çok daha esnektir. Hedef koleksiyon yoksa onu oluşturur; varsa her sonuç belgesini, belirlediğiniz tanımlayıcı alanlara göre mevcut belgelerle karşılaştırır. Tam söz dizimi şöyledir:
{ $merge: {
     into: "hedef",                 // veya { db: "vt", coll: "hedef" }
     on: "_id",                     // isteğe bağlı; tek alan veya alan dizisi
     let: { },                      // isteğe bağlı; whenMatched pipeline'ı için değişkenler
     whenMatched: "merge",          // replace | keepExisting | merge | fail | pipeline
     whenNotMatched: "insert"       // insert | discard | fail
} }
Bütün varsayılanları kullanıyor ve aynı veritabanına yazıyorsanız kısa biçim yeterlidir: { $merge: "hedef" }. Varsayılanlar whenMatched: "merge" ve whenNotMatched: "insert" değerleridir.
whenMatched seçenekleri
| Değer | Eşleşen belge bulunduğunda |
|---|---|
| merge (varsayılan) | Alanları birleştirir: yeni alanlar eklenir, ortak alanlar sonuçtaki değerle değişir |
| replace | Mevcut belgeyi sonuç belgesiyle tamamen değiştirir |
| keepExisting | Mevcut belgeyi olduğu gibi bırakır |
| fail | İşlemi durdurur; o ana kadar yazılanlar geri alınmaz |
| pipeline | Mevcut belgeyi özel bir güncelleme pipeline'ı ile değiştirir |
Belgelerdeki örneğe benzer şekilde düşünürsek: hedefte { _id: 1, a: 1, b: 1 }, sonuçta { _id: 1, b: 5, z: 1 } varsa merge sonucu { _id: 1, a: 1, b: 5, z: 1 } olur. replace seçseydiniz a alanı kaybolurdu.
Pipeline biçiminde yalnızca $addFields/$set, $project/$unset ve $replaceRoot/$replaceWith aşamaları kullanılabilir. Pipeline içinde $alan hedef koleksiyondaki mevcut belgeyi, $$new.alan ise yeni sonuç belgesini gösterir. $$new değişkeni yalnızca let yazılmadığında kullanılabilir; let belirtmezseniz varsayılanı { new: "$$ROOT" } olur. Pipeline, on alanlarının değerini değiştiremez.
db.satislar.aggregate( [
   { $group: { _id: "$urunId", adet: { $sum: "$adet" } } },
   { $merge: {
        into: "urunToplamlari",
        whenMatched: [ { $set: { adet: { $add: [ "$adet", "$$new.adet" ] } } } ],
        whenNotMatched: "insert"
   } }
] )
Bu sorgu her ürün için satış adetlerini toplar. Ürün hedefte zaten varsa yeni adedi mevcut adede ekler, yoksa yeni belge olarak yazar. Böyle bir pipeline'ı aynı veri üzerinde iki kez çalıştırırsanız adetler iki kez eklenir; bu yüzden toplanan veriyi bir tarih aralığıyla sınırlamak gerekir.
on alanı ve unique indeks şartı
on, bir sonuç belgesinin hedefteki hangi belgeyle eşleştiğine karar veren alan veya alanlardır. Kurallar şöyledir:
$merge,onalanlarına karşılık gelen ve yalnızca bu alanları anahtar olarak içeren bir unique indeks ister. Hedef koleksiyon zaten varsa bu indeks de önceden var olmalıdır.- İndeks sparse olabilir ama partial olamaz; aggregation ile aynı collation'a sahip olmalıdır.
- Hedef koleksiyon yoksa
onyalnızca_idolabilir ve_idindeksi otomatik oluşur. Başka bir alan kullanmak istiyorsanız koleksiyonu önce o alanlar üzerinde unique indeks oluşturarak yaratın. - Sonuç belgelerinde
onalanları bulunmalıdır (alan_idise ve yoksa MongoDB onu ekler). Alanlar dizi değeri taşıyamaz. - MongoDB 8.0 ve öncesinde
onalanları eksik veyanullolamaz; 8.1'den beri destekleyen indeks sparse değilse eksik veyanullolabilir. - Hedef sharded bir koleksiyonsa varsayılan
on, shard key alanları ile_idalanıdır; kendiondeğerinizi verirseniz bütün shard key alanlarını içermelidir.
// Hedef henüz yoksa önce unique indeksi oluşturun
db.gunlukOzet.createIndex( { gun: 1 }, { unique: true } )

db.siparisler.aggregate( [
   { $group: {
        _id: { $dateToString: { format: "%Y-%m-%d", date: "$tarih" } },
        ciro: { $sum: "$tutar" }
   } },
   { $project: { _id: 0, gun: "$_id", ciro: 1 } },
   { $merge: { into: "gunlukOzet", on: "gun", whenMatched: "replace", whenNotMatched: "insert" } }
] )
$project aşamasında _id: 0 yazmamızın nedeni şudur: on alanı _id değilken sonuçta _id bulunursa ve hedefteki belgenin _id değeri farklıysa, replace veya merge mevcut belgenin _id değerini değiştirmeye çalışır ve $merge hata verir. Belgeler bu durumda _id alanını önceki bir aşamada çıkarmayı önerir. Sonuç belgesinde _id yoksa $merge yeni eklenen belge için onu kendisi üretir.
Hata ve geri alma davranışı
$out ile en büyük fark burada ortaya çıkar. $merge hedefi ilk belgeyi yazdığı anda oluşturur ve koleksiyon hemen görünür olur. Aggregation yarıda hata verirse o ana kadar yazılan belgeler geri alınmaz. Schema validation hatasında ilk geçersiz belge hatayı fırlatır, geçerli belgeler yine de yazılır. Bu yüzden $merge içeren işleri tekrar çalıştırıldığında doğru sonuç verecek şekilde (örneğin replace ile ve sınırlı tarih aralığıyla) tasarlamak gerekir.
Aynı koleksiyona yazmak
$merge, aggregate edilen koleksiyonun kendisine de yazabilir. Ancak belgeler bunun belgelerin birden fazla kez güncellenmesine, hatta sonsuz döngüye yol açabileceği konusunda uyarır: güncelleme belgenin diskteki fiziksel konumunu değiştirirse $merge onu yeni bir belge sanabilir. Bu duruma Halloween problemi denir. Mümkünse ayrı bir hedef koleksiyon kullanın.
$out ve $merge karşılaştırması
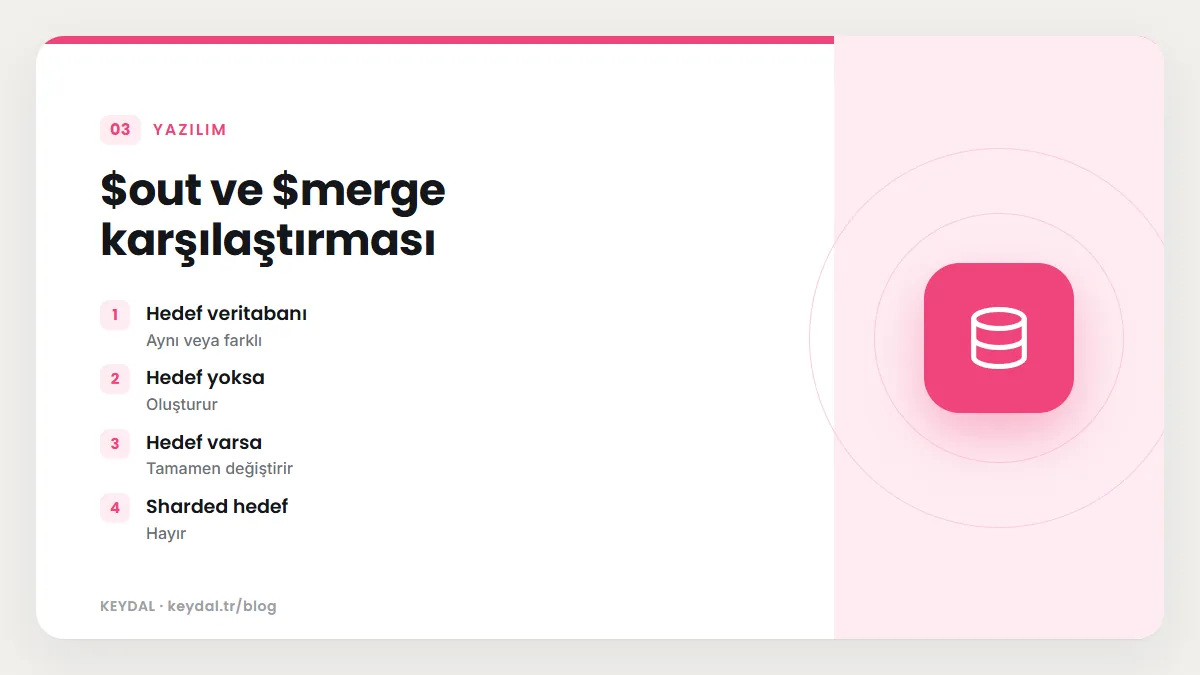
| Özellik | $out | $merge |
|---|---|---|
| Hedef veritabanı | Aynı veya farklı | Aynı veya farklı |
| Hedef yoksa | Oluşturur | Oluşturur |
| Hedef varsa | Tamamen değiştirir | Belge bazında ekler, birleştirir, değiştirir veya korur |
| Sharded hedef | Hayır | Evet |
| Time series hedef | Evet (7.0.3 ve 7.1 sonrası) | Hayır |
| Hata olursa | Mevcut koleksiyon değişmez | Yazılmış belgeler geri alınmaz |
| Transaction ve view içinde | Kullanılamaz | Kullanılamaz |
| SQL karşılığı | SELECT INTO, INSERT INTO SELECT | MERGE, INSERT INTO SELECT |
Belgeler önemli bir ayrıntıyı da vurgular: $merge ile replace kullanarak koleksiyonun bütün belgelerini değiştirebilirsiniz, ama bu yalnızca sonuçlar mevcut her belge için bir eşleşme içeriyorsa olur. Sonuçtan bağımsız olarak koleksiyonu baştan kurmak istiyorsanız doğru araç $out aşamasıdır.
Mini örnek: artımlı tazelenen materialized view
Materialized view, diskte saklanan ve okunurken yeniden hesaplanmayan önceden hesaplanmış bir aggregation sonucudur. Belgelerdeki yöntem, tazeleme işini bir mongosh fonksiyonuna koyup yalnızca değişen dönemi yeniden hesaplamaktır. Aşağıdaki fonksiyon, verilen günden itibaren günlük ciroyu yeniden hesaplar:
function gunlukOzetiTazele(baslangic) {
   db.siparisler.aggregate( [
      { $match: { tarih: { $gte: baslangic } } },
      { $group: {
           _id: { $dateToString: { format: "%Y-%m-%d", date: "$tarih" } },
           siparisSayisi: { $sum: 1 },
           ciro: { $sum: "$tutar" }
      } },
      { $merge: { into: "gunlukCiro", whenMatched: "replace", whenNotMatched: "insert" } }
   ] )
}

// İlk kurulum: geçmişin tamamı
gunlukOzetiTazele( new Date("2026-01-01") )

// Sonraki çalıştırmalar: yalnızca son günler
gunlukOzetiTazele( new Date("2026-11-06") )
Grup anahtarı günün tarihi olduğu için _id her gün için benzersizdir ve on yazmamıza gerek kalmaz; hedef ilk çalıştırmada otomatik oluşur. whenMatched: "replace" sayesinde aynı gün tekrar hesaplandığında eski satır yenisiyle değişir, yani fonksiyonu aynı aralıkla birden fazla kez çalıştırmak sonucu bozmaz. Raporu okuyan uygulama artık yalnızca db.gunlukCiro.find() yapar ve büyük siparisler koleksiyonunu taramaz.
Standart view: kaydedilmiş sorgu
Standart view, başka bir koleksiyon veya view üzerinde tanımlanmış bir aggregation pipeline'ıdır. İçeriği diske yazılmaz, her sorguda yeniden hesaplanır ve salt okunurdur; view'a yazma işlemi hata döndürür.
db.createView(
   "aktifMusteriler",
   "musteriler",
   [ { $match: { aktif: true } }, { $unset: [ "tcKimlik", "telefon" ] } ]
)

db.aktifMusteriler.find( { sehir: "İzmir" } )
Aynı view'ı db.createCollection("aktifMusteriler", { viewOn: "musteriler", pipeline: [ ... ] }) biçiminde de oluşturabilirsiniz. Belgelerdeki kullanım örneklerinden biri tam olarak budur: kişisel verileri dışarıda bırakan bir view tanımlamak. Erişim denetimi açıksa view'ı sorgulamak için yalnızca view üzerinde find yetkisi gerekir; kaynak koleksiyonda find yetkisi gerekmez.
View kuralları
- View, kaynak koleksiyonla aynı veritabanında oluşturulmalıdır ve oluşturulduktan sonra yeniden adlandırılamaz.
- View pipeline'ı, iç içe pipeline'lar dahil,
$outveya$mergeiçeremez. - Standart view kaynak koleksiyonun indekslerini kullanır; view üzerinde doğrudan genel indeks oluşturamazsınız.
- Collation belirtilmezse view kaynak koleksiyonun collation ayarını devralmaz, basit ikili karşılaştırma kullanır.
find()ile view sorgularken$,$elemMatch,$sliceprojeksiyon operatörleri ve$metadesteklenmez;$textve map-reduce da kullanılamaz.- View'ı değiştirmek için ya silip yeniden oluşturursunuz ya da
collModkomutunuviewOnvepipelineile çalıştırırsınız. - View pipeline'ı bloklayan sıralama ve gruplama için 100 megabaytlık bellek sınırına tabidir.
Standart view mı, materialized view mı?
| Özellik | Standart view | Materialized view |
|---|---|---|
| Saklama | Diske yazılmaz, okunurken hesaplanır | Diske yazılır, diskten okunur |
| Tazelik | Her zaman güncel | Son tazeleme anı kadar güncel |
| İndeks | Kaynak koleksiyonun indeksleri | Kendi indeksleri oluşturulabilir |
| Okuma performansı | Pipeline karmaşıklığına bağlı | Daha iyi; fark veri ve pipeline büyüdükçe artar |
| Oluşturma | db.createView() | $merge veya $out içeren aggregation |
Kısaca: veri her an güncel olmalıysa ve sorgu ucuzsa standart view, sorgu pahalıysa ve birkaç dakikalık gecikme kabul edilebiliyorsa materialized view seçin. MongoDB 9.0 ile $convert bir nesneyi binData türüne dönüştürebiliyor; bu dönüşümü kullanan view'lar eski sürüme dönüldüğünde hata verir. Ayrıntı için MongoDB 9.0 yenilikleri yazısına bakın.
Sık yapılan hatalar
- $out ile canlı koleksiyonu ezmek: hedef adını yanlış yazarsanız veri kaybedersiniz.
- on alanı için unique indeks oluşturmamak: mevcut hedefte
$mergebu indeks olmadan çalışmaz. - on alanı _id değilken sonuçta _id bırakmak: eşleşen belgede
_iddeğişmeye çalışır ve işlem hata verir. - $merge hatasında geri alma beklemek: yazılmış belgeler kalır; işi yeniden çalıştırılabilir tasarlayın.
- View'a yazmaya çalışmak: standart view salt okunurdur.
- Pahalı pipeline'ı standart view yapmak: her okuma pipeline'ı baştan çalıştırır; bu durumda materialized view daha uygundur.
Sık Sorulan Sorular
$out ile yazılan koleksiyonun indeksleri kaybolur mu?
Hayır. Belgelere göre $out mevcut koleksiyonun indeks tanımlarını kopyalar ve yeni koleksiyonda yeniden oluşturur. Hedef ilk kez oluşuyorsa elbette yalnızca _id indeksi olur; gereken diğer indeksleri bir kez oluşturmanız yeterlidir.
$merge ile çalışan işi secondary üyede çalıştırabilir miyim?
MongoDB 5.0'dan beri, kümedeki bütün üyelerin feature compatibility version değeri 5.0 veya üzerindeyse ve read preference secondary okumaya izin veriyorsa $merge ve $out içeren pipeline'lar secondary üyede çalışabilir; yazma işlemleri yine primary üyeye gider. Sürücünüzün bunu destekleyip desteklemediğini sürücü belgelerinden kontrol edin. Read preference konusu write concern ve read concern yazısında anlatılıyor.
Materialized view kendiliğinden güncellenir mi?
Hayır; bu yazıda anlatılan view'lar "on-demand" türdendir, yani tazeleme pipeline'ını siz çalıştırırsınız. Bunu uygulamanızdaki bir zamanlanmış görevle veya sunucunuzdaki bir zamanlayıcıyla düzenli hale getirebilirsiniz.
$lookup sonucunu bir view içinde kullanabilir miyim?
Evet, view pipeline'ı $lookup içerebilir. Birden fazla view'ı birleştiriyorsanız bunların collation ayarları aynı olmalıdır.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: MongoDB öğrenme rehberi · Aggregation pipeline · $group ve accumulator · $lookup ile join · Unique ve partial index · mongodump ve mongorestore