MariaDB Vector, bir yapay zekâ modelinin ürettiği vektörleri (embedding) MariaDB tablosunda saklayıp en yakın komşu araması yapmanızı sağlayan özelliktir. Sütunu VECTOR(N) tipinde tanımlar, VECTOR INDEX ekler ve sorguda ORDER BY VEC_DISTANCE_EUCLIDEAN(...) ya da VEC_DISTANCE_COSINE(...) ile birlikte LIMIT kullanırsınız. Belgelere göre özellik MariaDB Community Server 11.7 ile (rolling sürüm) geldi ve onu içeren ilk uzun süreli destek sürümü olan 11.8'den itibaren genel kullanıma açıktır; dolayısıyla MariaDB 12.3 LTS'te de kullanılabilir.
Bu yazıda vektör tipini, vektör index seçeneklerini, veriyi ekleme biçimlerini, uzaklık fonksiyonlarını, index'in hangi sorgularda gerçekten kullanıldığını ve ilgili sistem değişkenlerini resmî belgelerdeki örneklerle anlatıyoruz. Vektörleri üreten modelin seçimi ve çağrılması MariaDB'nin değil uygulamanızın işidir; bu yazı veritabanı tarafına odaklanır. Serinin tamamı için MariaDB öğrenme rehberi sayfasına bakın.
Vektör ve embedding nedir?
Belgelerdeki kısa açıklamaya göre bir vektör, yani embedding, sıralı bir sayı listesidir. Yapay zekâ modelleri metin gibi içerikleri bu tür vektörlere dönüştürür ve anlamca benzer içerikler vektör uzayında birbirine yakın düşer. Anlamsal arama ve RAG (retrieval-augmented generation) uygulamaları, sorguya en yakın vektörleri bularak ilgili içeriği getirir. Klasik kelime aramasından farkı, ortak kelime olmasa da kavramca yakın belgeleri bulabilmesidir; kelime bazlı arama için MariaDB FULLTEXT arama yazısına bakın.
MariaDB vektör index'inde arama için değiştirilmiş bir HNSW (Hierarchical Navigable Small World) algoritması kullanır ve böylece yaklaşık en yakın komşu (approximate nearest neighbor) problemini çözer. Belgelere göre eşzamanlı okuma ve yazma ile tüm transaction izolasyon seviyeleri desteklenir. "Yaklaşık" sözcüğü önemlidir: index, hızı için kesin sıralamadan küçük ölçüde ödün verebilir; bu dengeyi aşağıda anlatılan M ve mhnsw_ef_search ayarlarıyla yönetirsiniz.
VECTOR veri tipi
VECTOR(N) tipinde N, sütundaki tüm vektörlerin sahip olacağı sabit boyut sayısıdır. Belgelere göre en fazla 16383 olabilir ve değeri kullandığınız embedding algoritması belirler. Vektör sütunları 32 bit IEEE 754 kayan noktalı sayılar saklar ve tipin yerleşik bir veri doğrulaması vardır. Vektör index'leri boyuta özgüdür: index'li bir sütuna eklenen her vektör index'in boyutuyla aynı olmalıdır, farklı boyutta vektör eklemek hata verir.
CREATE TABLE v (
     id INT PRIMARY KEY,
     v VECTOR(5) NOT NULL,
     VECTOR INDEX (v)
);
Bu tanımdaki iki kural sık atlanır. Belgelere göre bir tabloda yalnızca bir vektör index'i olabilir ve index'lenen vektör sütunu NOT NULL olmalıdır. Index'i CREATE TABLE içinde tanımlayabileceğiniz gibi CREATE VECTOR INDEX ya da ALTER TABLE ... ADD VECTOR INDEX ile sonradan da ekleyebilirsiniz. Diğer veri tipleri için MariaDB veri tipleri yazısına bakın.
Vektör index seçenekleri: M ve DISTANCE
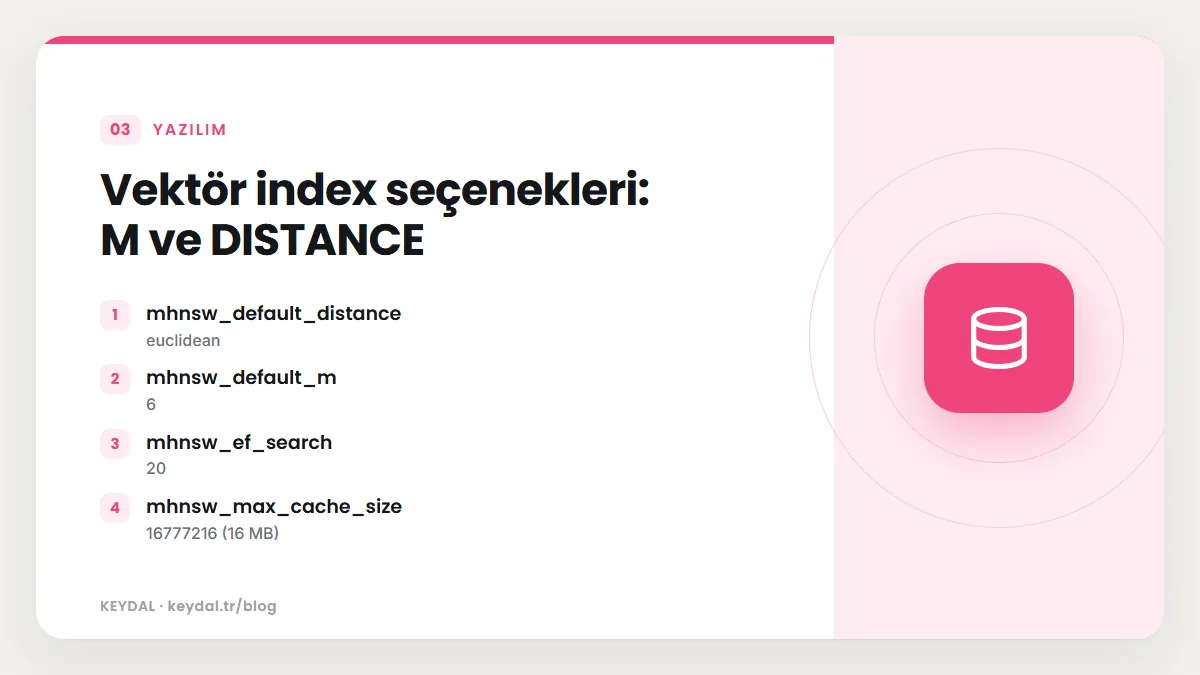
Vektör index'i iki seçenekle yapılandırılır. M, HNSW grafiğinde katman başına bağlantı sayısını belirler; belgelere göre daha büyük değerler SELECT ve INSERT ifadelerini yavaşlatır, index'i büyütür ve bellek tüketimini artırır ama daha doğru sonuç verir. Geçerli aralık 3 ile 200 arasıdır. DISTANCE, index'in hangi uzaklık fonksiyonu için kurulacağını belirler; geçerli değerler euclidean (varsayılan) ve cosine'dır:
CREATE TABLE embeddings (
        doc_id BIGINT UNSIGNED PRIMARY KEY,
        embedding VECTOR(1536) NOT NULL,
        VECTOR INDEX (embedding) M=8 DISTANCE=cosine
);| Değişken | Varsayılan | Görevi |
|---|---|---|
| mhnsw_default_distance | euclidean | DISTANCE verilmezse index için kullanılan ölçüt |
| mhnsw_default_m | 6 | M verilmezse kullanılan değer (aralık 3-200) |
| mhnsw_ef_search | 20 | ORDER BY ... LIMIT N sorgularında aranacak en az aday sayısı (1-10000) |
| mhnsw_max_cache_size | 16777216 (16 MB) | Tek bir vektör index önbelleğinin üst sınırı |
Belgelere göre mhnsw_default_distance değişkeninde euclidean düz çizgi uzaklığını hesaplar ve mutlak büyüklüğün önemli olduğu uzamsal veri ve görüntü gibi işlere uygundur; cosine yönsel benzerliği ölçer ve metin embedding'leri ile anlamsal arama için idealdir. Bu dört değişken MariaDB 11.7.1 ile geldi; ilk üçü oturum düzeyinde de ayarlanabilir, mhnsw_max_cache_size ise yalnızca küreseldir.
Vektör ekleme: ikili değer ya da VEC_FromText
Vektörleri iki şekilde ekleyebilirsiniz. Birincisi, küçük sonlu (little-endian) IEEE float baytlarını doğrudan onaltılık ikili sabit olarak vermektir; belgelerdeki örnek beş boyutlu on vektör ekler:
INSERT INTO v VALUES
     (1, x'e360d63ebe554f3fcdbc523f4522193f5236083d'),
     (2, x'f511303f72224a3fdd05fe3eb22a133ffae86a3f'),
     (3,x'f09baa3ea172763f123def3e0c7fe53e288bf33e'),
     (4,x'b97a523f2a193e3eb4f62e3f2d23583e9dd60d3f'),
     (5,x'f7c5df3e984b2b3e65e59d3d7376db3eac63773e'),
     (6,x'de01453ffa486d3f10aa4d3fdd66813c71cb163f'),
     (7,x'76edfc3e4b57243f10f8423fb158713f020bda3e'),
     (8,x'56926c3fdf098d3e2c8c5e3d1ad4953daa9d0b3e'),
     (9,x'7b713f3e5258323f80d1113d673b2b3f66e3583f'),
     (10,x'6ca1d43e9df91b3fe580da3e1c247d3f147cf33e');
İkincisi, çoğu uygulama için daha pratik olan VEC_FromText() fonksiyonudur. Bu fonksiyon vektörün metin gösterimini, yani sayılardan oluşan bir JSON dizisini, float başına 4 baytlık ikili biçime çevirir. Embedding servisleri genellikle sonucu bir sayı dizisi olarak döndürdüğü için bu diziyi doğrudan VEC_FromText()'e verebilirsiniz:
INSERT INTO v VALUES
  (1,Vec_FromText('[0.418708,0.809902,0.823193,0.598179,0.0332549]')),
  (2,Vec_FromText('[0.687774,0.789588,0.496138,0.57487,0.917617]'));
Ters yönde VEC_ToText() ikili vektörü yeniden bir JSON sayı dizisine çevirir. Belgelerdeki örnekler iki fonksiyonun çıktısını gösterir; [1,2,3] dizisi her biri dört baytlık üç float olarak saklanır:
SELECT HEX(vec_fromtext('[1,2,3]'));
+------------------------------+
| HEX(vec_fromtext('[1,2,3]')) |
+------------------------------+
| 0000803F0000004000004040     |
+------------------------------+

SELECT VEC_ToText(x'e360d63ebe554f3fcdbc523f4522193f5236083d');
+---------------------------------------------------------+
| VEC_ToText(x'e360d63ebe554f3fcdbc523f4522193f5236083d') |
+---------------------------------------------------------+
| [0.418708,0.809902,0.823193,0.598179,0.033255]          |
+---------------------------------------------------------+
Geçersiz bir ikili değer verildiğinde VEC_ToText() NULL döndürür ve 4201 kodlu bir uyarı üretir. Uyarı metni, baytların küçük sonlu IEEE float biçiminde olması gerektiğini ve bunun için VEC_FromText() kullanılmasını önerir:
SELECT VEC_ToText(x'aabbcc');
+-----------------------+
| VEC_ToText(x'aabbcc') |
+-----------------------+
| NULL                  |
+-----------------------+
1 row in set, 1 warning (0.000 sec)

Warning (Code 4201): Invalid binary vector format. Must use IEEE standard float
  representation in little-endian format. Use VEC_FromText() to generate it.
JSON dizileriyle çalışan diğer fonksiyonlar için MariaDB JSON fonksiyonları yazısına bakabilirsiniz.
Uzaklık fonksiyonları
MariaDB üç uzaklık fonksiyonu sunar. VEC_DISTANCE_EUCLIDEAN(v, s) iki nokta arasındaki Öklid (L2) uzaklığını, VEC_DISTANCE_COSINE(v, s) iki vektör arasındaki kosinüs uzaklığını hesaplar; vektörlerin normalize edilmiş olması gerekmez. Her iki fonksiyonda da vektörlerin uzunluğu aynı olmalıdır, farklı uzunluklarda uzaklık tanımsızdır ve sonuç NULL döner. Index ilgili fonksiyon için kurulmamışsa kullanılmaz ve tam tablo taraması yapılır.
En yaygın sorgu, verilen bir vektöre en yakın birkaç kaydı getirmektir: bir kullanıcı arama sorgusu, bir görüntü ya da bir şarkı parçası gibi. Belgelerdeki örnekte 10 numaralı vektörün kendisine en yakın iki kayıt isteniyor; doğal olarak ilk sırada kendisi geliyor:
SELECT id FROM v
  ORDER BY VEC_DISTANCE_EUCLIDEAN(v, x'6ca1d43e9df91b3fe580da3e1c247d3f147cf33e')
  LIMIT 2;
+----+
| id |
+----+
| 10 |
|  7 |
+----+
Kosinüs uzaklığı doğrudan iki sabit vektör arasında da hesaplanabilir:
SELECT VEC_DISTANCE_COSINE(vec_fromtext('[1,2,3]'), vec_fromtext('[3,5,7]'));
+-----------------------------------------------------------------------+
| VEC_DISTANCE_COSINE(vec_fromtext('[1,2,3]'), vec_fromtext('[3,5,7]')) |
+-----------------------------------------------------------------------+
|                                                   0.00258509695694209 |
+-----------------------------------------------------------------------+
Üçüncü fonksiyon VEC_DISTANCE(v, s) geneldir: alttaki index'in türüne göre Öklid ya da kosinüs gibi davranır. Böylece index'i değiştirdiğinizde sorgularınızı yeniden yazmanız gerekmez. Ancak alttaki index belirlenemiyorsa belgelere göre 4206 hatası döner. Bu yüzden genel fonksiyonu yalnızca vektör index'i olan sütunlarda kullanın; index'siz karşılaştırmalarda açık fonksiyon adını yazın:
ERROR 4206 (HY000): Cannot determine distance type for VEC_DISTANCE, index is not foundVektör index'i hangi sorgularda kullanılır?
Belgelerdeki en önemli performans kuralı şudur: iyileştirici vektör index'ini yalnızca ORDER BY ifadesi düz bir VEC_DISTANCE_*(sütun, vektör) çağrısı (ya da onun takma adı) olduğunda, artan sırada sıralandığında ve bir LIMIT ile birlikte kullanıldığında devreye sokar. LIMIT yoksa uzaklık her satır için hesaplanır, yani tam tablo taraması yapılır. Belgeler index'i boşa çıkaran iki yaygın kalıbı ve çözümlerini verir.
Birincisi uzaklığı bir ifadeye sarmaktır. 1 - kosinüs uzaklığı gibi bir benzerlik puanına göre sıralamak istiyorsanız puanı dış sorguda hesaplayın ve iç sorgudaki ORDER BY'ı düz uzaklık üzerinde bırakın. İkincisi bir eşik değere göre süzmektir: ORDER BY ... LIMIT olmadan yazılan WHERE VEC_DISTANCE(...) < eşik index'in yönetemeyeceği bir aralık koşuludur ve tam taramaya düşer. Bunun yerine index'ten ilk K sonucu alıp eşiği onlara uygulayın:
SELECT t.id, 1 - t.distance AS score FROM (
    SELECT id, VEC_DISTANCE_COSINE(embedding, @query) AS distance
    FROM documents ORDER BY distance LIMIT 10
) AS t ORDER BY score DESC;

SELECT * FROM (
    SELECT content, VEC_DISTANCE_COSINE(embedding, @query) AS distance
    FROM documents ORDER BY distance LIMIT 100
) AS t WHERE t.distance < 0.5;
Belgeler buradaki LIMIT'in, eşik uygulanmadan önce index'in döndüreceği satır sayısı için kesin bir üst sınır olduğunu vurgular; çok sayıda satır eşleşebilecekse bu değeri cömert seçin, yoksa sınırın ötesindeki uygun satırlar sessizce kaybolur. Sorgu planını doğrulamak için MariaDB EXPLAIN ve ANALYZE yazısındaki yöntemleri kullanın.
Arama kalitesi ve bellek ayarları
mhnsw_ef_search, ORDER BY ... LIMIT N sorgularında index'te aranacak en az aday sayısını belirler; LIMIT daha küçük olsa bile arama bu sayıdan az satıra bakmaz. Belgelere göre bu, düşük LIMIT değerlerinde arama kalitesini belirgin biçimde artırır, karşılığında arama süresi uzar. Değişken oturum düzeyinde ayarlanabildiği için kalitenin kritik olduğu bir sorgu öncesinde geçici olarak yükseltebilirsiniz:
SET SESSION mhnsw_ef_search = 40;
SET SESSION mhnsw_default_distance = cosine;
mhnsw_max_cache_size tek bir vektör index önbelleğinin kullanabileceği bellek için üst sınırdır ve varsayılanı 16 MB'tır. Büyük index'lerde bu değeri sunucunuzun belleğine göre seçenek dosyasında artırmayı düşünebilirsiniz; genel bellek planlaması için InnoDB buffer pool ve performans ayarları yazısına bakın:
[mariadbd]
mhnsw_max_cache_size = 268435456Küçük bir uygulama: belge arama (RAG) tablosu
Bir destek sitesinde makaleleri anlamsal olarak aramak istediğinizi düşünelim. Uygulamanız her makale için bir embedding modelinden 768 boyutlu bir vektör alıyor ve bu modelin kosinüs benzerliğiyle kullanılmasını öneriyor. Tabloyu kosinüs için kurulmuş bir vektör index'iyle tanımlıyor, vektörü VEC_FromText() ile ekliyor ve kullanıcının sorusunun vektörüne en yakın beş makaleyi getiriyoruz. Soru işaretleri, uygulamanızın hazırlanmış ifadelerle dolduracağı parametrelerdir:
CREATE TABLE belgeler (
  id BIGINT UNSIGNED NOT NULL AUTO_INCREMENT PRIMARY KEY,
  baslik VARCHAR(200) NOT NULL,
  icerik TEXT NOT NULL,
  embedding VECTOR(768) NOT NULL,
  VECTOR INDEX (embedding) DISTANCE=cosine
);

INSERT INTO belgeler (baslik, icerik, embedding)
VALUES (?, ?, VEC_FromText(?));

SELECT id, baslik, VEC_DISTANCE_COSINE(embedding, VEC_FromText(?)) AS uzaklik
  FROM belgeler
 ORDER BY uzaklik
 LIMIT 5;
Bu tasarımda birkaç nokta önemli. Sütun boyutu modelin çıktısıyla birebir aynı olmalı; model değişirse tüm vektörleri yeniden üretmeniz ve gerekirse sütunu yeni boyutla yeniden tanımlamanız gerekir. Sorgudaki uzaklık fonksiyonu index'in DISTANCE değeriyle aynı (cosine), ORDER BY düz uzaklık takma adı üzerinde ve bir LIMIT var; yani index kullanılabilir. Gelen beş makale bir dil modeline bağlam olarak verilerek RAG akışı tamamlanır. Kelime eşleşmesinin de önemli olduğu durumlarda belgeler, FULLTEXT ve vektör aramasının sıralı listelerini Reciprocal Rank Fusion (RRF) ile birleştiren hibrit bir sorgu yaklaşımını ayrı bir sayfada anlatır. Uygulama tarafındaki bağlantı için PHP PDO veritabanı bağlantısı yazısı yardımcı olabilir.
Hibrit arama: FULLTEXT ve vektör sonuçlarını birleştirmek
Belgelerdeki hibrit arama sayfası iki yaklaşımın güçlü yanlarını şöyle özetler: tam metin araması sorgudaki kelimeleri birebir içeren belgeleri bulmakta, vektör araması ise ortak kelime olmasa da kavramca yakın belgeleri bulmakta iyidir. İki aramanın sıralı listelerini birleştirmenin saf yolu, iki listede de geçen kayıtları almaktır; ancak sayfa bunun bir INNER JOIN gibi davrandığını ve yalnızca tek bir sistemin bulduğu, belki de birinci sıradaki sonuçları attığını gösterir.
Önerilen çözüm Reciprocal Rank Fusion'dır (RRF). RRF ham puanlara değil, her kaydın listelerdeki sırasına bakar; her liste için 1 / (k + sıra) değerini toplar. Böylece birbiriyle karşılaştırılamayan puanları normalize etmeye gerek kalmaz. Belgelere göre k sabiti düşük tutulursa en üst sıradaki sonuç çok güçlü olur, yüksek tutulursa birden çok sistemin üzerinde anlaştığı kayıtlar öne çıkar; genel kullanım için 60 sağlam bir başlangıç değeri olarak verilir. Sayfa sorguyu CTE'lerle kurar; CTE sözdizimi için MariaDB CTE ve WITH RECURSIVE, sıra numarası üretmek için MariaDB window fonksiyonları yazılarına bakabilirsiniz.
Sık yapılan hatalar
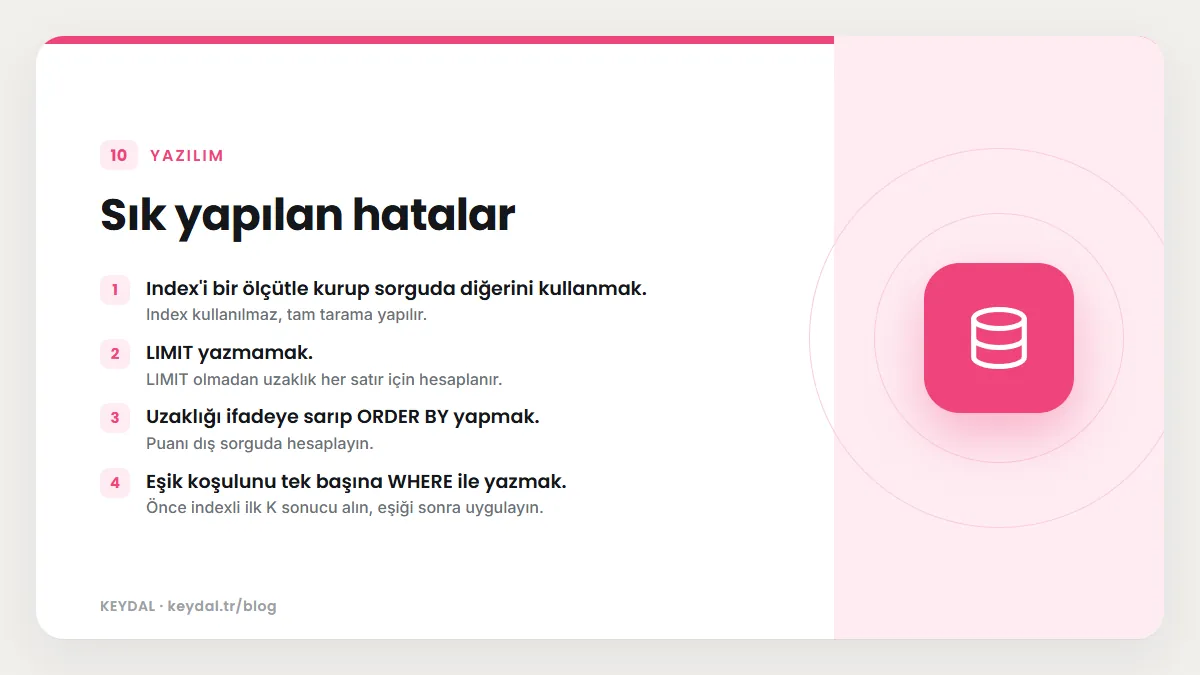
- Index'i bir ölçütle kurup sorguda diğerini kullanmak. Index kullanılmaz, tam tarama yapılır.
- LIMIT yazmamak.
LIMITolmadan uzaklık her satır için hesaplanır. - Uzaklığı ifadeye sarıp ORDER BY yapmak. Puanı dış sorguda hesaplayın.
- Eşik koşulunu tek başına WHERE ile yazmak. Önce indexli ilk K sonucu alın, eşiği sonra uygulayın.
- Index'li sütunu NULL bırakılabilir tanımlamak. Vektör index'li sütun
NOT NULLolmalıdır. - Tabloya ikinci vektör index'i eklemeye çalışmak. Tablo başına bir vektör index'i desteklenir.
- Yanlış bayt sırasıyla ikili vektör göndermek. Emin değilseniz
VEC_FromText()kullanın. - Farklı boyutta vektör eklemek. Tüm vektörler sütunun boyutuyla aynı olmalıdır.
Sık Sorulan Sorular
MariaDB vektör arama hangi sürümde var?
Belgelere göre Community Server'da 11.7 ile geldi ve 11.8 LTS'ten itibaren genel kullanıma açık; 12.3 LTS de bu özelliği içerir. Enterprise Server tarafında özelliğin 11.4 serisine geri taşındığı da belgelerde not edilir; bu seri ise yalnızca Community Server'ı ele alır.
Kosinüs mü Öklid mi seçmeliyim?
Embedding modelinizin önerdiği ölçütü seçin. Belgeler kosinüsü metin embedding'leri ve anlamsal arama için, Öklid'i mutlak büyüklüğün önemli olduğu uzamsal veri ve görüntüler için uygun bulur.
Vektör boyutu en fazla kaç olabilir?
VECTOR(N) için N en fazla 16383 olabilir.
Sonuçlar neden her zaman kesin en yakınlar değil?
Vektör index'i HNSW tabanlı yaklaşık en yakın komşu araması yapar. Doğruluğu artırmak için daha büyük M ile index kurabilir ya da mhnsw_ef_search değerini yükseltebilirsiniz; ikisi de hız ve kaynak maliyetini artırır.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: MariaDB öğrenme rehberi · MariaDB FULLTEXT arama · MariaDB JSON fonksiyonları · MariaDB index oluşturma · MariaDB EXPLAIN ve ANALYZE · MariaDB 12.3 LTS yenilikleri