MariaDB'de bir sorgunun nasıl çalıştırılacağını görmek için sorgunun başına EXPLAIN yazarsınız; sunucu sorguyu çalıştırmaz, optimizer'ın seçtiği planı tablo tablo listeler. Planın gerçekte ne kadar isabetli olduğunu görmek isterseniz ANALYZE deyimini kullanırsınız: bu deyim sorguyu gerçekten çalıştırır, sonuç kümesini atar ve planın yanına ölçülmüş satır sayılarını ekler. Bu ikisi, yavaş bir sorguda ilk bakmanız gereken araçlardır.
Bu yazı MariaDB'ye özgü ayrıntılara odaklanır: EXPLAIN sütunlarının anlamı, type ve Extra değerleri, rowid filtresi gösterimi, MySQL'den farklı olan FORMAT=JSON çıktısı, r_rows ve r_filtered sütunları, çalışan bir sorgunun planını yakalayan SHOW EXPLAIN ve MariaDB 12.0 ile gelen yeni optimizer hint'leri. Genel sorgu optimizasyonu stratejileri için SQL sorgu optimizasyonu rehberine, index tasarımı için MariaDB index oluşturma yazısına bakabilirsiniz.
EXPLAIN deyiminin üç kullanımı
Belgelere göre EXPLAIN üç farklı biçimde yazılabilir. Birincisi yalnızca bir tablo adı alır ve DESCRIBE ile aynı işi yapar, yani tablonun sütunlarını listeler. İkincisi bir SELECT, UPDATE veya DELETE deyiminin önüne gelir ve yürütme planını gösterir. Üçüncüsü başka bir bağlantının o anda çalıştırdığı sorgunun planını getirir.
EXPLAIN tbl_name [col_name | wildcard]

EXPLAIN [EXTENDED | PARTITIONS | FORMAT=JSON]
  {SELECT select_options | UPDATE update_options | DELETE delete_options}

EXPLAIN [FORMAT=JSON] FOR CONNECTION <connection_id>
EXTENDED çıktıya filtered sütununu ekler, PARTITIONS yalnızca bölümlenmiş tablolarda hangi bölümlerin okunacağını görmek için işe yarar (ayrıntı için MariaDB tablo bölümleme yazısı), FORMAT=JSON ise planı tek bir JSON belgesi olarak döndürür. Belgelerin önemli bir notu daha var: EXPLAIN sorguyu çalıştırmasa da tablo meta verisine ihtiyaç duyduğu için SELECT gibi metadata kilidi alabilir. Uzun süren bir ALTER TABLE sırasında EXPLAIN de bekleyebilir; bu durumu SHOW PROCESSLIST ve KILL yazısında anlatılan yöntemlerle izleyebilirsiniz.
İlk örnek: iki tablolu bir join planını okumak
Belgelerdeki basit örnekte t0 tablosunda 10 satır vardır, t1 tablosunun a sütununda ise benzersiz bir index bulunur. İki tablo a sütunu üzerinden birleştirilir:
EXPLAIN SELECT t0.a, t1.b FROM t0, t1 WHERE t0.a = t1.a;+------+-------------+-------+--------+---------------+------+---------+-----------+------+-------------+
| id | select_type | table | type | possible_keys | key | key_len | ref | rows | Extra |
+------+-------------+-------+--------+---------------+------+---------+-----------+------+-------------+
| 1 | SIMPLE | t0 | ALL | NULL | NULL | NULL | NULL | 10 | Using where |
| 1 | SIMPLE | t1 | eq_ref | a | a | 5 | test.t0.a | 1 | |
+------+-------------+-------+--------+---------------+------+---------+-----------+------+-------------+Satırlar join sırasıyla, yukarıdan aşağıya okunur. MariaDB önce t0 tablosunun tamamını tarar (type değeri ALL, tahmini 10 satır). Ardından t0 içindeki her satır için t1 tablosunda benzersiz a index'i üzerinden tek bir eşleşen satırı arar (eq_ref, 1 satır). ref sütunundaki test.t0.a değeri, arama anahtarının önceki tablonun sütunundan geldiğini söyler. Planı okurken iki soru sorun: her tabloya hangi yolla erişiliyor ve her adımda kaç satır bekleniyor.
EXPLAIN sütunları ne anlatır?
| Sütun | Anlamı |
|---|---|
| id | Tabloların hangi sırayla birleştirildiğini gösteren sıra numarası |
| select_type | Tablonun hangi tür SELECT içinden geldiği (SIMPLE, PRIMARY, SUBQUERY, DERIVED vb.) |
| table | Tablonun takma adı; alt sorgular için oluşturulan geçici tablolar subquery# adıyla görünür |
| type | Satırların tablodan nasıl bulunduğu (erişim türü) |
| possible_keys | Satırları bulmak için kullanılabilecek index'ler |
| key | Gerçekte seçilen index; NULL ise index kullanılmıyor |
| key_len | Index'in kaç baytının kullanıldığı; çok sütunlu index'in bir kısmının kullanılıp kullanılmadığını gösterir |
| ref | Index'e anahtar değer olarak verilen referans |
| rows | Her anahtar araması için bulunacağı tahmin edilen satır sayısı |
| Extra | Bu join adımı hakkında ek bilgiler |
rows sütununun bir tahmin olduğunu unutmayın. Değer index istatistiklerinden gelir ve gerçek satır sayısından uzaklaşabilir. Gerçek sayıyı görmek için aşağıda anlatılan ANALYZE deyimine geçmeniz gerekir.
type sütunu: erişim türleri
Planı yorumlarken en çok bakılan sütun type sütunudur. Belgelerin tanımladığı değerlerden en sık karşılaşılanlar şunlardır:
system: tabloda 0 veya 1 satır var.const: tabloda en fazla bir eşleşen satır olabilir; satır optimizasyon aşamasından önce okunur ve sütunları sabit gibi kullanılır. Birincil anahtarla tek satır aramak bu türü verir.eq_ref: satırlar benzersiz bir index ile bulunur. Belgeler bunu bir satırı bulmanın mümkün olan en iyi planı olarak tarif eder.ref: benzersiz olmayan bir index ya da benzersiz bir index'in ön eki kullanılır; ön ek az satırla eşleşiyorsa iyidir.range: tabloya bir veya daha fazla değer aralığı üzerinden index ile erişilir.index: kullanılan index'in tamamı taranır;ALLdeğerinden iyidir ama index büyükse ve tablo önceki bir tabloyla birleştiriliyorsa yine kötüdür.ALL: tablonun tamamı taranır. Optimizer kullanılabilir bir index bulamadığında görülür; büyük tablolarda ve özellikle join içinde sorun işaretidir.fulltext,index_merge,ref_or_null,unique_subquery,index_subquery: tam metin index'i, birden fazla index aralığının birleştirilmesi, NULL için ek arama ve index aramasına dönüştürülmüş alt sorgular gibi özel durumlar.
MariaDB'ye özgü bir ayrıntı da ref|filter, eq_ref|filter veya range|filter gibi birleşik değerlerdir. Bunlar erişim türünün rowid filtresiyle birlikte kullanıldığını anlatır; filter hiçbir zaman tek başına görünmez.
Extra sütunu: dikkat edilecek ifadeler
Extra sütunu noktalı virgülle ayrılmış bir veya daha fazla değer içerir. Bazı değerler optimizasyon aşamasından sonra belirlenir. Pratikte en çok işinize yarayacak olanlar:
Using index: gereken bilgi yalnızca index'ten okunur, gerçek satıra ayrıca gidilmez.Using where: index aramasına ek olarak birWHEREkoşulu satırları eler. Belgeler,ALLerişim türüyle birlikteUsing wheregörmüyorsanız muhtemelen yanlış bir şey yaptığınızı belirtir.Using index condition: koşul index düzeyinde depolama motoruna itilir (index condition pushdown).Using filesort: sıralama için ayrı bir aşama gerekir; sıralanacak sütunlar toplanır ve diskte birleştirmeli sıralama yapılabilir.Using temporary: sonucu tutmak için geçici tablo oluşturulur; çoğunluklaGROUP BY,DISTINCTveyaORDER BYile görülür.Using join buffer: önceki satır birleşimleri bir arabellekte toplanır ve topluca eşleştirilir.Using rowid filter: ikinci bir index'ten kurulan rowid filtresi, satırlar tablodan okunmadan önce kontrol edilir.Impossible WHEREveSelect tables optimized away: koşul her zaman yanlış olduğu için hiç satır dönmeyecek ya da yalnızcaCOUNT(*),MIN(),MAX()kullanıldığı için tablolar sabitlerle değiştirilmiş.
Kötü index kullanımını EXPLAIN ile yakalamak
Belgelerdeki çalışan örnek, altı satırlık küçük bir personel tablosu kullanır. Tabloda birincil anahtar, employee_code üzerinde benzersiz bir anahtar ve first_name, last_name üzerinde iki sütunlu bir index vardır; home_phone sütununda ise index yoktur. Tablo tanımının kısaltılmış hali şöyledir:
CREATE TABLE IF NOT EXISTS `employees_example` (
  `id` int(11) NOT NULL AUTO_INCREMENT,
  `first_name` varchar(30) NOT NULL,
  `last_name` varchar(40) NOT NULL,
  `position` varchar(25) NOT NULL,
  `home_address` varchar(50) NOT NULL,
  `home_phone` varchar(12) NOT NULL,
  `employee_code` varchar(25) NOT NULL,
  PRIMARY KEY (`id`),
  UNIQUE KEY `employee_code` (`employee_code`),
  KEY `first_name` (`first_name`,`last_name`)
) ENGINE=Aria;
Birincil anahtarla arama yapıldığında plan tek satırlık bir const erişimi gösterir:
EXPLAIN SELECT * FROM employees_example WHERE id=1;
+------+-------------+-------------------+-------+---------------+---------+---------+-------+------+-------+
| id   | select_type | table             | type  | possible_keys | key     | key_len | ref   | rows | Extra |
+------+-------------+-------------------+-------+---------------+---------+---------+-------+------+-------+
|    1 | SIMPLE      | employees_example | const | PRIMARY       | PRIMARY | 4       | const |    1 |       |
+------+-------------+-------------------+-------+---------------+---------+---------+-------+------+-------+
Aynı kayıt telefon numarasıyla arandığında ise tablo baştan sona taranır:
EXPLAIN SELECT * FROM employees_example WHERE home_phone='326-555-3492';
+------+-------------+-------------------+------+---------------+------+---------+------+------+-------------+
| id   | select_type | table             | type | possible_keys | key  | key_len | ref  | rows | Extra       |
+------+-------------+-------------------+------+---------------+------+---------+------+------+-------------+
|    1 | SIMPLE      | employees_example | ALL  | NULL          | NULL | NULL    | NULL |    6 | Using where |
+------+-------------+-------------------+------+---------------+------+---------+------+------+-------------+
possible_keys ve key sütunlarının NULL olması, kullanılabilecek bir index bulunmadığını gösterir; rows değeri altı satırın tamamının okunacağını söyler. Altı satırda bu fark hissedilmez, ama aynı plan milyonlarca satırlık bir tabloda her sorguda tam tarama demektir. Telefonla arama gerçek bir ihtiyaçsa home_phone üzerine index eklemek gerekir; ekledikten sonra EXPLAIN komutunu tekrar çalıştırıp key sütununun dolduğunu doğrulayın.
EXPLAIN EXTENDED ve yeniden yazılmış sorgu
EXTENDED anahtar kelimesi çıktıya filtered sütununu ekler. Bu sütun, tablo satırlarının yüzde kaçının koşuldan geçeceğine dair bir tahmindir. EXPLAIN EXTENDED her zaman bir uyarı üretir; hemen ardından SHOW WARNINGS çalıştırırsanız sorgunun optimizer kurallarından geçtikten sonraki halini, yani sütunların ve tabloların nasıl nitelendirildiğini görürsünüz. Optimizer'ın WHERE koşulunu nasıl sadeleştirdiğini anlamak için iyi bir yoldur: belgeler, sabit yayılımı, imkânsız alt ifadelerin silinmesi ve ON koşullarının WHERE içine taşınması gibi dönüşümleri listeler.
Rowid filtresi gösterimi
Rowid filtreleme optimizasyonu uygulandığında EXPLAIN çıktısına yeni bir satır eklenmez; filtrenin uygulandığı tablonun satırı işaretlenir. type sütunu ref|filter, key sütunu arama index'i ile filtrenin kurulduğu index'i, rows sütunu ise 4 (2%) gibi tahmini satır sayısını ve filtrenin beklenen seçiciliğini birlikte gösterir. Belgelerdeki örnekte sunucu her aramada 4 satır bulmayı ve bunların ortalama 4 x 0,02 = 0,08 kadarının filtreden geçmesini bekler. Yüzde tam sayıya yuvarlandığı için çok seçici bir filtre (0%) olarak görünebilir. Bu optimizasyon optimizer_switch içindeki rowid_filter bayrağıyla yönetilir ve varsayılan olarak açıktır. FORMAT=JSON çıktısı bu gösterimi kullanmaz; filtreyi selectivity_pct üyesi olan bir rowid_filter nesnesi olarak raporlar.
EXPLAIN FORMAT=JSON
JSON biçimi her zaman tek satır ve EXPLAIN başlıklı tek sütun döndürür. Belgelerdeki örnekte 100 satırlık, büyük/küçük harf duyarsız collation kullanan bir tablo vardır:
EXPLAIN FORMAT=JSON SELECT * FROM t1 WHERE UPPER(col1)=UPPER(col2)\G*************************** 1. row ***************************
EXPLAIN: {
"query_block": {
"select_id": 1,
"cost": 0.0256761,
"nested_loop": [
{
"table": {
"table_name": "t1",
"access_type": "ALL",
"loops": 1,
"rows": 100,
"cost": 0.0256761,
"filtered": 100,
"attached_condition": "t1.col2 = t1.col1"
}
}
]
}
}attached_condition değerine dikkat edin: tablo büyük/küçük harf duyarsız bir collation kullandığı için UPPER() karşılaştırmanın sonucunu değiştirmez ve optimizer bu fonksiyonu koşuldan çıkarır. Bu yeniden yazımı varsayılan olarak açık olan sargable_casefold optimizer anahtarı yönetir. Belgeler maliyet değerlerinin veriye, sunucu derlemesine ve donanıma göre değiştiğini vurgular; yani cost sayılarını sunucular arasında karşılaştırmayın.
ANALYZE: tahmin ile gerçeği yan yana koymak
ANALYZE deyimi optimizer'ı çağırır, deyimi çalıştırır ve sonuç kümesi yerine EXPLAIN çıktısını, yürütme sırasında toplanan istatistiklerle birlikte döndürür. Sözdizimi yalındır: ANALYZE kelimesinden sonra EXPLAIN ile açıklanabilen herhangi bir deyim gelir. PostgreSQL'deki EXPLAIN ANALYZE komutuna benzer; MariaDB'de eskiden kullanılan EXPLAIN ANALYZE sözdizimi ise belgelerde güncelliğini yitirmiş olarak işaretlidir ve yerini ANALYZE deyimine bırakmıştır.
ANALYZE SELECT * FROM tbl1
WHERE key1
  BETWEEN 10 AND 200 AND
col1 LIKE 'foo%'\G*************************** 1. row ***************************
id: 1
select_type: SIMPLE
table: tbl1
type: range
possible_keys: key1
key: key1
key_len: 5
ref: NULL
rows: 181
r_rows: 181.00
filtered: 100.00
r_filtered: 10.50
Extra: Using index condition; Using whereEXPLAIN çıktısına göre iki yeni sütun vardır. r_rows, tablodan gerçekte okunan satır sayısıdır ve rows tahmininin ölçülmüş karşılığıdır. r_filtered, WHERE koşulu uygulandıktan sonra kalan satırların gerçek yüzdesidir ve filtered tahmininin karşılığıdır. Bu örnekte satır tahmini tutmuş, ama optimizer satırların tamamının koşuldan geçeceğini varsaymışken gerçekte yalnızca yüzde 10,50'si geçmiştir.
Belgelerdeki join örneği yorum için iyi kurallar verir. Tam tarama yapılan bir tabloda r_filtered yüzde 15'in altındaysa uygun bir index eklemeyi düşünmenin zamanıdır. rows ile r_rows sürekli birbirinden uzaksa ANALYZE TABLE ile istatistikleri tazelemek gerekebilir. Optimizer'ın bir koşulun seçiciliğini hiç tahmin edemediği durumlarda filtered 100 görünür; çok tablolu join'lerde ilgili sütunlar için sütun istatistikleri toplamak daha iyi bir plan seçilmesine yardım edebilir.
r_rows ve r_filtered değerlerinin NULL olması ise o tablonun hiç taranmadığı anlamına gelir. Belgelerdeki ikinci örnekte ilk tablonun r_filtered değeri 0,00 çıkar, yani koşulun o tabloya bağlı kısmı hiç sağlanmamıştır; bu yüzden ikinci tabloya hiç gidilmez.
ANALYZE FORMAT=JSON ile daha fazla ayrıntı
ANALYZE FORMAT=JSON, JSON planını yürütme verileriyle birlikte verir ve tablo biçiminde görünmeyen alanlar içerir. r_loops bir düğümün kaç kez çalıştığını, r_total_time_ms o düğümde alt düğümler dahil toplam kaç milisaniye harcandığını, r_buffer_size ise arabellek kullanan düğümlerin ne kadar arabellek kullandığını gösterir. UPDATE ve DELETE deyimlerinde en üstteki r_total_time_ms satırları değiştirme süresini içerir ama değişikliklerin commit edilme süresini içermez.
InnoDB tabloları için r_engine_stats nesnesi de gelir. pages_accessed okunan buffer pool sayfalarını, pages_read_count diskten okunması gereken sayfaları, pages_read_time_ms okuma süresini, old_rows_read ise transaction'a görünmeyen eski satır sürümlerinden kaç tane okunduğunu söyler. Yalnızca sıfırdan farklı üyeler yazılır; veri buffer pool içinde sıcaksa pages_read_count hiç görünmez. Bu alanlar bir sorgunun yavaşlığının diskten mi yoksa plandan mı geldiğini ayırt etmek için değerlidir; buffer pool boyutu için InnoDB buffer pool ve performans ayarları yazısına bakın.
Çalışan bir sorgunun planı: SHOW EXPLAIN ve SHOW ANALYZE
Bir sorgu dakikalardır çalışıyorsa onu durdurmadan planını görebilirsiniz. Önce SHOW PROCESSLIST ile bağlantı numarasını bulun, ardından SHOW EXPLAIN FOR ile o bağlantının planını isteyin. EXPLAIN FOR CONNECTION aynı işi yapan, MySQL uyumluluğu için eklenmiş takma addır. Belgelerdeki örnek:
SHOW EXPLAIN FOR 1;
+------+-------------+-------+-------+---------------+------+---------+------+---------+-------------+
| id   | select_type | table | type  | possible_keys | key  | key_len | ref  | rows    | Extra       |
+------+-------------+-------+-------+---------------+------+---------+------+---------+-------------+
|    1 | SIMPLE      | tbl   | index | NULL          | a    | 5       | NULL | 1000107 | Using index |
+------+-------------+-------+-------+---------------+------+---------+------+---------+-------------+
1 row in set, 1 warning (0.00 sec)
Çıktıya her zaman bir uyarı eşlik eder; SHOW WARNINGS bu uyarıda hedef bağlantının çalıştırdığı sorgu metnini gösterir. Hedef bağlantı o anda açıklanabilir bir komut çalıştırmıyorsa ya da planı henüz hazır değilse ERROR 1932 (HY000): Target is not running an EXPLAINable command hatası alırsınız. Belgelere göre SHOW EXPLAIN çalışan sorguyu incelediği için çıktısı bazen normal EXPLAIN çıktısından gerçeğe daha yakındır. Komut SHOW PROCESSLIST ile aynı yetkileri ister. MariaDB 10.9'dan itibaren SHOW ANALYZE FORMAT=JSON FOR ile çalışan sorgunun o ana kadarki yürütme istatistiklerini de alabilirsiniz.
Yavaş sorgu günlüğüne plan yazdırmak
Planı elle almak yerine yavaş sorgu günlüğüne yazdırabilirsiniz. Bunun için log_slow_verbosity sistem değişkenine explain anahtar kelimesini eklersiniz. Belgelerdeki yapılandırma örneği:
[mysqld]
log-slow-verbosity=query_plan,explain
Bu durumda günlükteki her kaydın üstünde explain: ile başlayan satırlar görünür. MariaDB bu çıktıyı içeride ANALYZE ile ürettiği için günlükte r_rows ve r_filtered sütunları da yer alır. Bir kısıt var: plan yalnızca yavaş sorgu günlüğü bir dosyaya yazılıyorsa kaydedilir, tabloya yazılan günlükte görünmez. Günlüğü açma ve döndürme ayrıntıları error log ve slow query log yazısında anlatılıyor.
Planı yönlendirmek: optimizer hint'leri
Plan yanlış bir index seçiyorsa önce istatistikleri tazelemek ve sorguyu düzeltmek gerekir. Bunlar yetmezse belirli bir sorgu için optimizer'a ipucu verebilirsiniz. Eski tarz USE INDEX, FORCE INDEX, IGNORE INDEX ve STRAIGHT_JOIN MariaDB'de uzun süredir vardır. Yeni tarz hint'ler ise belgelere göre MariaDB 12.0 ve 12.1 ile geldi: /*+ ile başlayıp */ ile biten özel bir yorumdur ve SELECT, UPDATE veya DELETE anahtar kelimesinin hemen ardından yazılır.
-- i_a ve i_ab index'lerini yasakla, diğer index'ler serbest
SELECT /*+ NO_INDEX(t1 i_a, i_ab)*/ a, MAX(b) FROM t1 WHERE a > 1 AND a < 3 GROUP BY a;

-- Tabloları FROM sırasıyla birleştir (STRAIGHT_JOIN ile aynı)
SELECT /*+ JOIN_FIXED_ORDER() */ f1, f2
  FROM t2 JOIN t1 ON t1.id = t2.id ORDER BY f1, f2;

-- Sorguyu 2000 milisaniye ile sınırla
SELECT /*+ MAX_EXECUTION_TIME(2000) */ * FROM t1;INDEX, NO_INDEX, JOIN_INDEX, GROUP_INDEX ve ORDER_INDEX gibi index düzeyindeki hint'ler MariaDB 12.1'den, join sırası hint'leri, BKA/BNL ve MAX_EXECUTION_TIME ise 12.0'dan itibaren kullanılabilir. Geçersiz, çakışan veya tekrarlanan bir hint sorguyu bozmaz, yalnızca uyarı üretir. Kabul edilen hint'leri EXPLAIN EXTENDED sonrasında gelen uyarı mesajında, yeniden yazılmış sorgunun içinde görürsünüz. Tablonun takma adı varsa hint takma adı kullanmalıdır ve tablo adı veritabanı adıyla nitelendirilemez. Bir sorguda yalnızca tek bir hint dizisi yazılabilir. @@max_statement_time ayarlıysa MAX_EXECUTION_TIME yok sayılır ve uyarı verilir. 12.x ile gelen diğer değişiklikler için MariaDB 12.3 LTS yenilikleri yazısına bakabilirsiniz.
İstatistikleri tazelemek: ANALYZE TABLE
ANALYZE deyimi ile ANALYZE TABLE farklı şeylerdir. ANALYZE TABLE sorgu çalıştırmaz; tablonun anahtar dağılımını analiz edip saklar. Optimizer, sabit olmayan bir değer üzerinden join yaparken tabloların sırasını ve bir tablo için hangi index'in kullanılacağını bu dağılıma bakarak seçer. Komut tablo üzerinde SELECT ve INSERT yetkisi ister. Belgelere göre MariaDB 10.6.16'dan itibaren engelleyici değildir ve işlem bitince sonraki sorgular yeni istatistikleri kullanır. Varsayılan olarak binary log'a yazılır ve replikasyonla kopyalara gider; bunu istemiyorsanız NO_WRITE_TO_BINLOG (veya takma adı LOCAL) kullanırsınız.
ANALYZE TABLE large_text_table PERSISTENT FOR COLUMNS(long_description);Hangi aracı ne zaman kullanmalı?
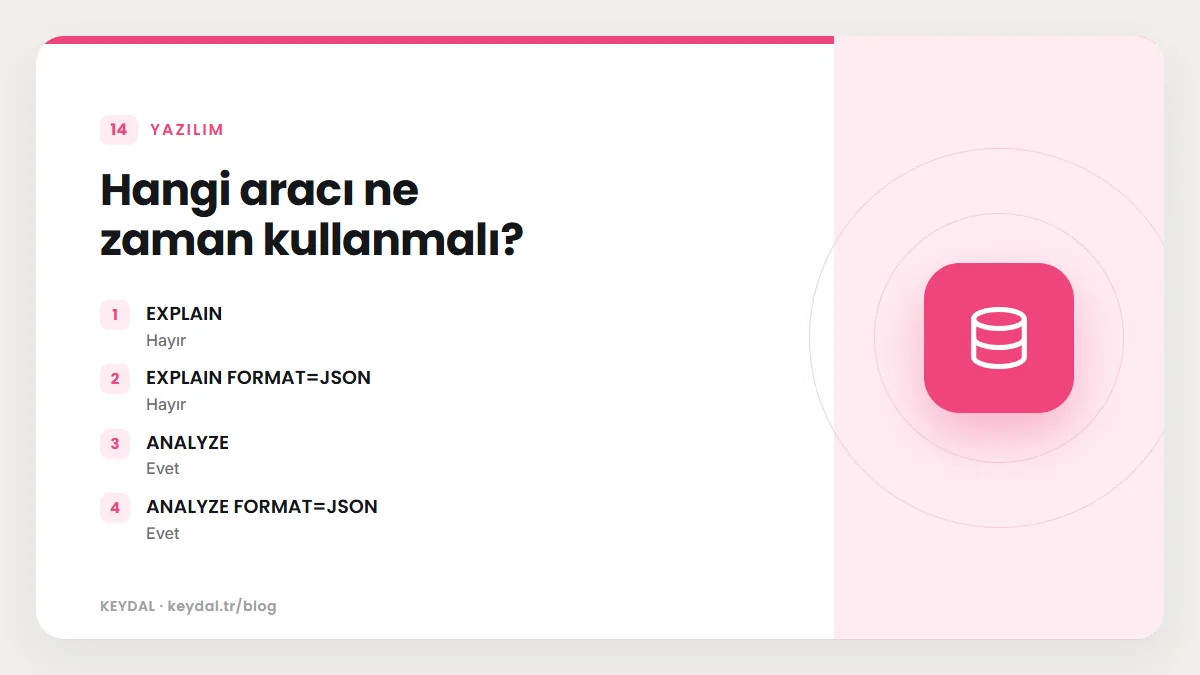
| Araç | Sorguyu çalıştırır mı? | Ne verir? | Ne zaman? |
|---|---|---|---|
| EXPLAIN | Hayır | Tahmini plan | Her yeni veya değişen sorguda ilk bakış |
| EXPLAIN FORMAT=JSON | Hayır | Maliyet ve koşul ayrıntılı plan | Koşulların nasıl yeniden yazıldığını görmek |
| ANALYZE | Evet | Plan, r_rows ve r_filtered | Tahminin gerçeğe ne kadar yakın olduğunu ölçmek |
| ANALYZE FORMAT=JSON | Evet | Süre, döngü sayısı, InnoDB sayfa istatistikleri | Yavaşlığın kaynağını bulmak |
| SHOW EXPLAIN FOR | Hayır (çalışanı izler) | Çalışan sorgunun planı | Uzun süren bir sorguyu durdurmadan incelemek |
| ANALYZE TABLE | Hayır | Güncel index istatistikleri | Tahminler sürekli şaşıyorsa |
Sık yapılan hatalar
- ANALYZE deyimini zararsız sanmak:
ANALYZE UPDATEveANALYZE DELETEveriyi gerçekten değiştirir. - rows değerini gerçek sayı gibi okumak:
rowsbir tahmindir. Karar vermeden önceANALYZEiler_rowsdeğerine bakın. - Küçük test tablosundaki plana güvenmek: Altı satırlık bir tabloda tam tarama ile index araması arasında fark görünmez ve optimizer küçük tablolarda farklı plan seçebilir. Planı gerçeğe yakın veri hacmiyle kontrol edin.
- Önce hint eklemek: Hint'ler istatistik ve sorgu sorunlarını gizler. Önce
ANALYZE TABLE, eksik index ve sorgu yapısını kontrol edin. - MySQL araçlarını JSON plana uygulamak: MariaDB'nin JSON plan biçimi MySQL'den farklıdır.
- Hint'i tablo adıyla yazmak: Tabloya takma ad verdiyseniz hint'te takma adı kullanmalısınız; aksi halde hint uygulanmaz ve yalnızca uyarı alırsınız.
- Yavaş sorgu günlüğünü tabloya yazıp plan beklemek:
explainayrıntısı yalnızca dosyaya yazılan günlükte görünür.
Sık Sorulan Sorular
EXPLAIN sorguyu çalıştırır mı?
Hayır. EXPLAIN yalnızca planı tahmin eder. Ancak tablo meta verisine eriştiği için metadata kilidi alabilir ve bazı durumlarda veriye de bakabilir. Sorguyu gerçekten çalıştıran ve ölçüm ekleyen deyim ANALYZE deyimidir.
MariaDB'de EXPLAIN ANALYZE yazabilir miyim?
Belgeler EXPLAIN ANALYZE sözdizimini güncelliğini yitirmiş olarak işaretler ve yerine ANALYZE deyimini gösterir. MariaDB'de doğrudan ANALYZE SELECT ... yazın.
r_filtered düşükse ne yapmalıyım?
Tam tarama yapılan bir tabloda r_filtered yüzde 15'in altındaysa belgeler koşuldaki sütunlara uygun bir index eklemeyi önerir. Yüzde 30 civarındaki bir seçicilik ise genellikle yeni index eklemeyi haklı çıkaracak kadar seçici değildir.
Optimizer hint'leri hangi sürümde kullanılabilir?
Yeni tarz hint'ler MariaDB 12.0 ve 12.1 ile geldi, bu yüzden 12.3 LTS'te kullanılabilir. Daha eski sürümlerde USE INDEX, FORCE INDEX, IGNORE INDEX ve STRAIGHT_JOIN gibi eski tarz değiştiriciler vardır.
SHOW EXPLAIN neden 1932 hatası veriyor?
Hedef bağlantı o anda EXPLAIN ile açıklanabilen bir komut çalıştırmıyordur ya da komut tabloları açıp kilitleri alma aşamasındadır ve plan henüz oluşmamıştır. Bağlantı numarasını SHOW PROCESSLIST ile tekrar kontrol edip komutu sorgu çalışırken yeniden deneyin.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: MariaDB öğrenme rehberi · SQL sorgu optimizasyonu · MariaDB index oluşturma · MariaDB JOIN ve alt sorgular · MariaDB slow query log · InnoDB buffer pool ayarları