MariaDB'de metinleri birleştirmek için CONCAT() ve CONCAT_WS(), parça almak için SUBSTRING(), LEFT(), RIGHT() ve SUBSTRING_INDEX(), aramak için LOCATE(), değiştirmek için REPLACE(), desen eşleştirmek için de LIKE ile REGEXP ailesini kullanırsınız. En çok hata yapılan iki nokta NULL davranışı ve büyük/küçük harf duyarlılığıdır: CONCAT() tek bir NULL argümanda tüm sonucu NULL yapar, LIKE ve REGEXP ise duyarlılığı sütunun collation değerinden alır.
Bu yazıda MariaDB 12.3 LTS dönemine ait resmî "MariaDB String Functions Guide" rehberine ve tek tek fonksiyon sayfalarına dayanarak en sık kullanılan metin fonksiyonlarını örnekleriyle, kenar durumlarıyla ve sık yapılan hatalarla anlatıyoruz. Örneklerin çıktıları belgelerde gösterilenlerdir. Karakter seti ve collation seçimi bu fonksiyonların sonucunu doğrudan etkilediği için MariaDB karakter seti ve collation yazısını da okumanızı öneririz.
Birleştirme: CONCAT ve CONCAT_WS
CONCAT(str1, str2, ...) argümanlarını uç uca ekler. Argümanların hepsi ikili olmayan metinse sonuç da öyledir; içlerinde ikili bir metin varsa sonuç ikili metin olur. Sayısal bir argüman ikili metin karşılığına çevrilir; bunu istemiyorsanız belgedeki gibi açık bir CAST kullanabilirsiniz: CONCAT(CAST(int_col AS CHAR), char_col). Asıl tuzak NULL davranışıdır:
SELECT CONCAT('Ma', 'ria', 'DB');
+---------------------------+
| CONCAT('Ma', 'ria', 'DB') |
+---------------------------+
| MariaDB                   |
+---------------------------+

SELECT CONCAT('Ma', 'ria', NULL, 'DB');
+---------------------------------+
| CONCAT('Ma', 'ria', NULL, 'DB') |
+---------------------------------+
| NULL                            |
+---------------------------------+
Tek bir NULL diğer tüm argümanlardaki bilgiyi gizler. Bir müşterinin ikinci adı boş olduğunda tam adının tamamen kaybolması bu yüzden yaygın bir hatadır. Belge iki çözüm önerir: NULL'ları boş metne çevirmek için IFNULL() kullanmak ya da NULL güvenli olan CONCAT_WS() fonksiyonunu boş ayraçla çağırmak. Oracle modunda ise CONCAT NULL'ları zaten yok sayar.
CONCAT_WS(separator, str1, str2, ...) ilk argümanı ayraç olarak alır ve diğerlerinin arasına koyar. Ayraç NULL ise sonuç NULL olur, diğer tüm NULL değerler ise atlanır:
SELECT CONCAT_WS('-','Floor',NULL,'Room');
+------------------------------------+
| CONCAT_WS('-','Floor',NULL,'Room') |
+------------------------------------+
| Floor-Room                         |
+------------------------------------+
Rehber CONCAT_WS('|', col1, col2, col3) ile dikey çizgiyle ayrılmış alanlar üretmeyi, başka bir programa veri aktarırken kullanışlı bir yol olarak gösterir. Ayraçta boşluk istiyorsanız onu ayraç metnine dahil etmeyi unutmayın: CONCAT_WS(', ', ...). Birden çok satırı tek bir metinde birleştirmek ise satır düzeyinde değil grup düzeyinde bir iştir ve GROUP_CONCAT() ile yapılır; MariaDB GROUP BY ve toplama fonksiyonları yazısına bakın.
Uzunluk: LENGTH ve CHAR_LENGTH
Bu iki fonksiyon karıştırıldığında doğrulama kuralları sessizce yanlış çalışır. Varsayılan modda (Oracle modu ayarlı değilken) LENGTH() uzunluğu bayt olarak ölçer, CHAR_LENGTH() ise karakter olarak. Çok baytlı bir karakter LENGTH() için birden fazla sayılır. Belgedeki örnek tek karakterlik π için farkı gösterir:
SELECT CHAR_LENGTH('π'), LENGTH('π'), LENGTHB('π'), OCTET_LENGTH('π');
+-------------------+--------------+---------------+--------------------+
| CHAR_LENGTH('π')  | LENGTH('π')  | LENGTHB('π')  | OCTET_LENGTH('π')  |
+-------------------+--------------+---------------+--------------------+
|                 1 |            2 |             2 |                  2 |
+-------------------+--------------+---------------+--------------------+
Oracle modunda LENGTH, CHAR_LENGTH() ile eş anlamlı hâle gelir ve karakter sayar; bayt sayısı için orada LENGTHB() veya OCTET_LENGTH() kullanılır. Kullanıcı adının "en az üç karakter" olmasını denetlemek gibi işlerde her zaman CHAR_LENGTH() seçin. ASCII dışındaki karakterler içeren metinlerde LENGTH() beklediğinizden büyük bir sayı döndürür.
Parça alma: LEFT, RIGHT, SUBSTRING, SUBSTRING_INDEX
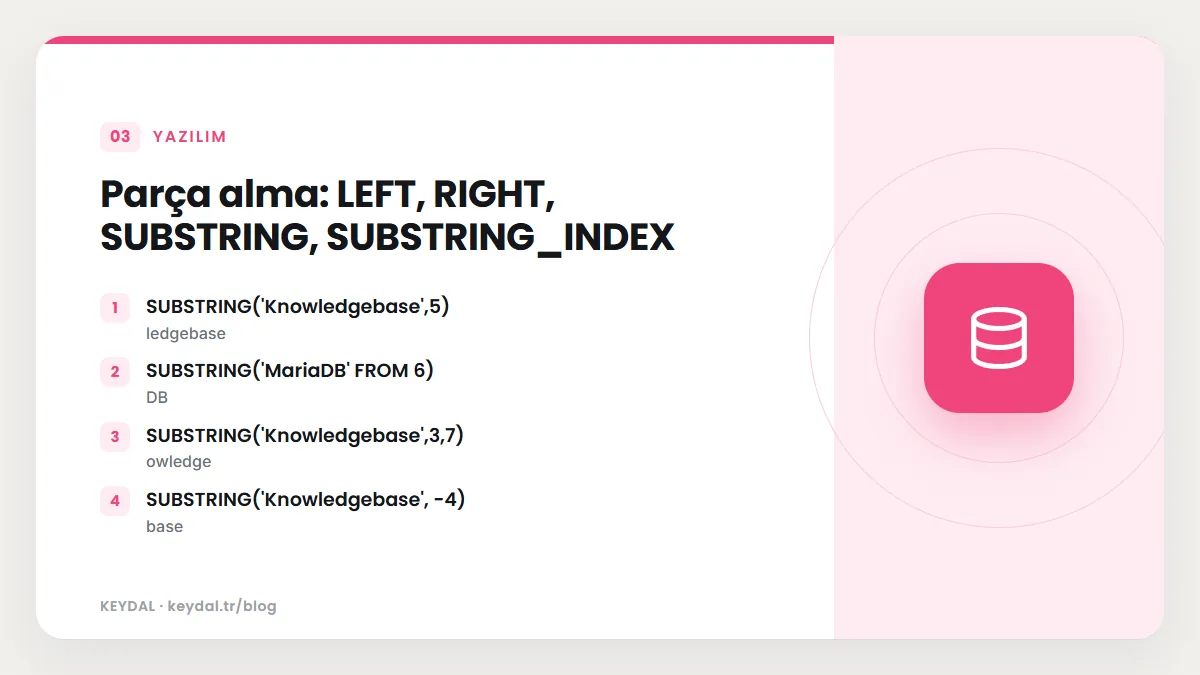
LEFT(str, n) soldan, RIGHT(str, n) sağdan n karakter alır. Rehber alan kodu ile numarayı ayırmak için LEFT(telephone, 3) ve RIGHT(telephone, 7) örneğini verir. Konum bazlı işler için SUBSTRING() kullanılır; SUBSTR() ve MID() aynı söz dizimine sahip eş anlamlılardır. Uzunluk verilmezse konumdan sonuna kadar olan kısım döner. Belgedeki örneklerin çıktıları şöyledir:
| İfade | Sonuç |
|---|---|
| SUBSTRING('Knowledgebase',5) | ledgebase |
| SUBSTRING('MariaDB' FROM 6) | DB |
| SUBSTRING('Knowledgebase',3,7) | owledge |
| SUBSTRING('Knowledgebase', -4) | base |
| SUBSTRING('Knowledgebase', 0) | (boş metin) |
| SUBSTRING('Knowledgebase', -8, 4) | edge |
Üç kuralı aklınızda tutun. İlk karakterin konumu 1'dir, 0 değil; pos 0 olursa sonuç boş metindir (Oracle modunda 0, 1 gibi ele alınır). Negatif konum sondan saymaya başlar ve her biçimde kullanılabilir. Herhangi bir argüman NULL ise sonuç NULL'dır. FROM ... FOR ... biçimi standart SQL sözdizimidir ve virgüllü biçimle aynı işi yapar.
SUBSTRING_INDEX(str, delim, count), ayraçla bölünmüş değerlerle çalışırken çok işe yarar. Pozitif count soldan sayılan o kadar ayraca kadar olan kısmı, negatif count sağdan sayarak sağ tarafı döndürür. Ayraç araması büyük/küçük harf duyarlıdır.
SELECT SUBSTRING_INDEX('www.mariadb.org', '.', 2);
+--------------------------------------------+
| SUBSTRING_INDEX('www.mariadb.org', '.', 2) |
+--------------------------------------------+
| www.mariadb                                |
+--------------------------------------------+

SELECT SUBSTRING_INDEX('www.mariadb.org', '.', -2);
+---------------------------------------------+
| SUBSTRING_INDEX('www.mariadb.org', '.', -2) |
+---------------------------------------------+
| mariadb.org                                 |
+---------------------------------------------+
Bir e-posta adresinin alan adını almak için aynı mantıkla SUBSTRING_INDEX(eposta, '@', -1) yazabilirsiniz. Sürüm notu: SUBSTRING sayfasının güncel sekmesine göre MariaDB 11.8'den itibaren optimize edici SUBSTR(indexli_sutun, 1, n) = sabit_metin biçimindeki koşullarda indexi kullanabilir; daha önce indexli sütun SUBSTR() içine alındığında index kullanılamıyordu. Index ayrıntıları için MariaDB index oluşturma yazısına bakın.
Arama ve değiştirme: LOCATE, REPLACE, INSERT
LOCATE(substr, str) aranan parçanın ilk geçtiği konumu, LOCATE(substr, str, pos) ise belirtilen konumdan itibaren ilk geçtiği konumu döndürür; bulunamazsa 0 döner. Argüman sırasına dikkat edin: önce aranan parça, sonra içinde aranan metin gelir. INSTR() iki argümanlı LOCATE() ile aynıdır, yalnızca argüman sırası terstir.
SELECT LOCATE('bar', 'foobarbar');
+----------------------------+
| LOCATE('bar', 'foobarbar') |
+----------------------------+
|                          4 |
+----------------------------+

SELECT LOCATE('bar', 'foobarbar', 5);
+-------------------------------+
| LOCATE('bar', 'foobarbar', 5) |
+-------------------------------+
|                             7 |
+-------------------------------+
REPLACE(str, from_str, to_str), metindeki tüm from_str geçişlerini to_str ile değiştirir. Belgedeki örnekte REPLACE('www.mariadb.org', 'w', 'Ww') sonucu WwWwWw.mariadb.org olur. Burada önemli bir asimetri vardır: belgeye göre LOCATE() büyük/küçük harf duyarsız arama yapar, REPLACE() ve SUBSTRING_INDEX() ise duyarlı eşleştirme yapar. Yani LOCATE ile bulduğunuz bir parçayı REPLACE harf farkı yüzünden değiştirmeyebilir.
Metnin yalnızca belirli bir konumundaki parçayı değiştirmek için INSERT(str, pos, len, newstr) kullanılır; rehber bunu LOCATE() ile birleştirerek bir unvanı değiştirmeyi gösterir. len 0 verilirse hiçbir şey silinmez, metin yalnızca araya eklenir. Bir uyarı: bu fonksiyon INSERT ifadesiyle aynı adı taşır ama bir metin fonksiyonudur, tabloya satır eklemez.
Biçimlendirme: TRIM, LPAD, RPAD, UPPER, FORMAT
TRIM() varsayılan olarak her iki uçtaki boşlukları siler; LEADING, TRAILING veya BOTH ile yönü, isteğe bağlı bir metinle de silinecek karakter dizisini belirtebilirsiniz. Belgedeki örneklerde TRIM(LEADING 'x' FROM 'xxxbarxxx') sonucu barxxx, TRIM(BOTH 'x' FROM 'xxxbarxxx') sonucu bar olur. Silinecek değer tek bir karakter değil bir dizidir: TRIM(TRAILING 'xyz' FROM 'barxxyz') yalnızca sondaki xyz'yi siler ve barx döndürür. LTRIM() ve RTRIM() yalnızca soldaki ya da sağdaki boşlukları siler.
LPAD(str, len, padstr) metni soldan doldurarak len karaktere tamamlar. Belgeye göre LPAD('hello',10,'.') sonucu .....hello olur. Metin len değerinden uzunsa kesilir: LPAD('hello',2,'.') sonucu he olur. Fatura numaralarını sabit genişliğe getirmek gibi işlerde kullanışlıdır, ama uzun değerlerin kesilebileceğini unutmayın. RPAD() aynı işi sağdan yapar. UPPER() ve LOWER() (eş anlamlıları UCASE() ve LCASE()) büyük ve küçük harfe çevirir. Rehberin gösterdiği FORMAT(col5, 2) ise bir sayıyı binlik ayraçlı ve iki ondalıklı biçime getirir. REPEAT() bir metni tekrar eder, REVERSE() ters çevirir.
Desen eşleştirme: LIKE
expr LIKE pat, eşleşme varsa 1, yoksa 0 döndürür; ifade veya desen NULL ise sonuç NULL'dır. İki joker karakter vardır: % sıfır dahil herhangi sayıda karakterle, _ tek bir karakterle eşleşir. _ bayt değil karakter eşler. Belgedeki gün adları tablosuyla örnekler:
CREATE TABLE t1 (d VARCHAR(16));
INSERT INTO t1 VALUES
  ("Monday"), ("Tuesday"), ("Wednesday"),
  ("Thursday"), ("Friday"), ("Saturday"), ("Sunday");

SELECT * FROM t1 WHERE d like "___day";
+---------+
| d       |
+---------+
| Monday  |
| Friday  |
| Sunday  |
+---------+LIKE, ifade ve desenin collation değeri büyük/küçük harf duyarsızsa duyarsız eşleşir; varsayılan collation'larda d LIKE "t%" hem Tuesday hem Thursday'i bulur. Duyarlı eşleşme için ikili bir collation (_bin ile bitenler) ya da BINARY dönüşümü kullanırsınız; belgedeki WHERE d like "t%" COLLATE utf8mb4_bin sorgusu boş küme döndürür. Joker karakterlerin kendisini aramak için önlerine ters bölü koyarsınız ya da ESCAPE ile başka bir kaçış karakteri seçersiniz:
SELECT '10% off' LIKE '10\%%', '100 off' LIKE '10\%%';
+------------------------+------------------------+
| '10% off' LIKE '10\%%' | '100 off' LIKE '10\%%' |
+------------------------+------------------------+
|                      1 |                      0 |
+------------------------+------------------------+

SELECT '10% off' LIKE '10=%%' ESCAPE '=';
+-----------------------------------+
| '10% off' LIKE '10=%%' ESCAPE '=' |
+-----------------------------------+
|                                 1 |
+-----------------------------------+
Performans açısından belgeye göre MariaDB, desen % veya _ ile başlamadığı sürece metin sütunlarında LIKE için index kullanabilir. LIKE '%kelime%' gibi başta joker olan aramalar tam tablo taramasına dönüşür; sonuçları alaka düzeyine göre sıralanan metin araması için MariaDB FULLTEXT arama yazısına bakın.
Düzenli ifadeler: REGEXP ve REGEXP_* fonksiyonları
expr REGEXP pat (eş anlamlısı RLIKE) metni bir düzenli ifadeyle karşılaştırır ve 1, 0 ya da NULL döndürür. MariaDB düzenli ifadeler için PCRE kütüphanesini kullanır. LIKE'tan farklı olarak desen metnin herhangi bir yerinde eşleşirse sonuç 1'dir; bütün metni eşleştirmek için deseni ^ ve $ ile sabitlemeniz gerekir. Belgedeki örnekte 'abc' REGEXP 'b' 1, 'abc' REGEXP '^b$' 0 döndürür. Ayrıca MariaDB metinlerde C kaçış sözdizimini kullandığı için desendeki her ters bölüyü iki kez yazmanız gerekir.
Büyük/küçük harf kuralı da önemlidir. REGEXP, ikili metinlerde, utf8mb4_bin gibi ikili collation'larda ve bazı duyarlı collation'larda duyarlıdır; aksi hâlde duyarsızdır. Belge, utf8mb4_uca1400_as_cs gibi UCA tabanlı _as_cs collation'ların duyarlı olmalarına rağmen yine de duyarsız eşleştiğini özellikle not eder. Duyarlı eşleşmeyi kesin olarak zorlamak için BINARY kullanın ya da deseni (?-i) ile başlatın: 'a' REGEXP 'A' 1 döndürürken 'a' REGEXP BINARY 'A' 0 döndürür.
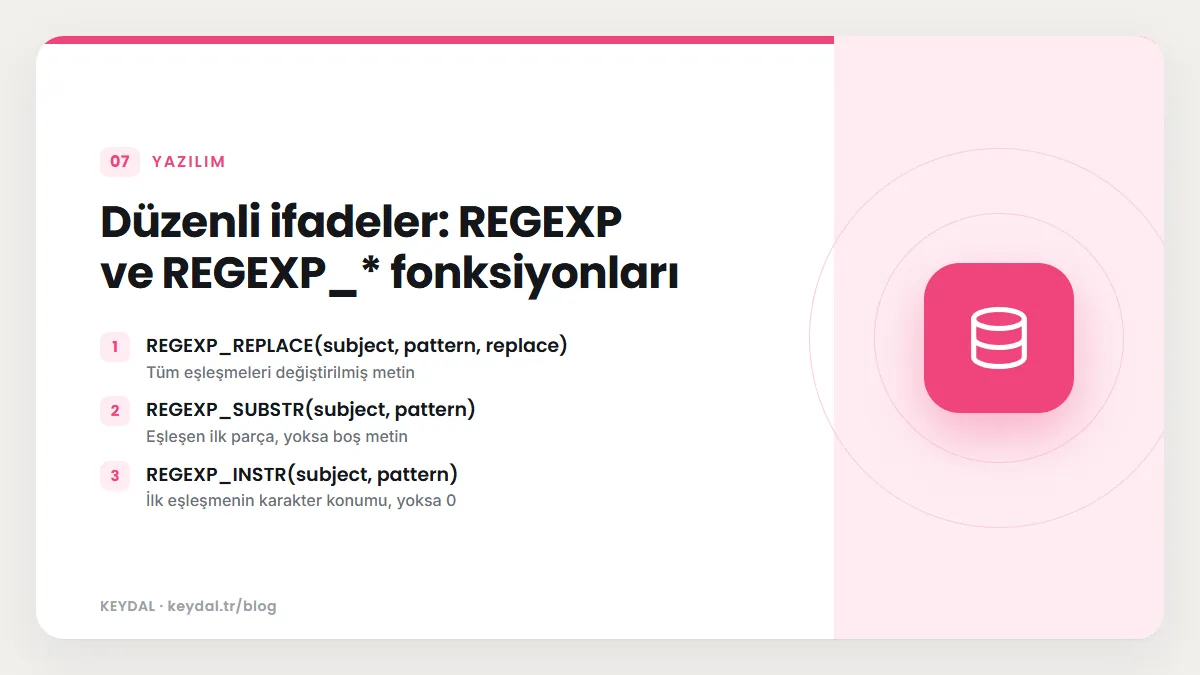
| Fonksiyon | Döndürdüğü | Belgedeki örnek ve sonucu |
|---|---|---|
| REGEXP_REPLACE(subject, pattern, replace) | Tüm eşleşmeleri değiştirilmiş metin | REGEXP_REPLACE('ab12cd','[0-9]','') sonucu abcd |
| REGEXP_SUBSTR(subject, pattern) | Eşleşen ilk parça, yoksa boş metin | REGEXP_SUBSTR('ab12cd','[0-9]+') sonucu 12 |
| REGEXP_INSTR(subject, pattern) | İlk eşleşmenin karakter konumu, yoksa 0 | REGEXP_INSTR('abc','b') sonucu 2 |
REGEXP_REPLACE değiştirme metninde \1 ile \9 arasında geri başvuruları destekler. Belgedeki örnek ad ve soyadın yerini değiştirir:
SELECT REGEXP_REPLACE('James Bond','^(.*) (.*)$','\\2, \\1') AS reorder_name;
-> Bond, James
REGEXP_INSTR konumları bayt değil karakter olarak sayar; belgede REGEXP_INSTR('BJÖRN','N') 5, aynı metin BINARY'ye çevrildiğinde 6 döner. Bu fonksiyonların hepsi etkin collation'ın duyarlılık kurallarına uyar ve (?i) ile (?-i) PCRE bayraklarıyla bu kural geçersiz kılınabilir. Çok satırlı metinlerde ^ ve $ varsayılan olarak yalnızca metnin başını ve sonunu eşler; satır bazlı eşleşme için deseni (?m) ile başlatabilir veya default_regex_flags değişkenini MULTILINE yapabilirsiniz.
Uygulamadan bir örnek: kullanıcıların farklı biçimlerde girdiği telefon numaralarını yalnızca rakamlardan oluşan biçime getirmek için rakam dışındaki her şeyi silebilirsiniz. Sorgu belgedeki [0-9] örneğinin tersine çevrilmiş hâlidir:
SELECT telefon,
  REGEXP_REPLACE(telefon, '[^0-9]', '') AS sadece_rakam
FROM musteriler;
Bu temizliği kalıcı yapmak için önce SELECT ile sonucu kontrol edin, ardından aynı ifadeyi bir UPDATE içinde kullanın. Kullanıcı girdisini SQL metnine eklerken SQL injection önleme yazısındaki kurallara uyun.
Sık yapılan hatalar
- CONCAT ile NULL birleştirmek: tek bir
NULLsonucuNULLyapar;CONCAT_WSveyaIFNULLkullanın. - Karakter yerine bayt saymak: doğrulamalarda
LENGTHdeğilCHAR_LENGTHkullanın. - SUBSTRING'de 0'dan başlamak: ilk konum 1'dir; 0 boş metin döndürür.
- LOCATE argümanlarını ters yazmak: doğru sıra
LOCATE(aranan, metin);INSTRise tersidir. - REPLACE'in harf duyarsız olduğunu sanmak:
REPLACEduyarlıdır,LOCATEduyarsızdır. - REGEXP'in bütün metni eşlediğini sanmak: desen herhangi bir yerde eşleşir; tam eşleşme için
^...$kullanın. - Ters bölüleri tek yazmak:
LIKEveREGEXPdesenlerinde ters bölüyü ikiye katlayın veyaESCAPEkullanın. - Duyarlı collation ile REGEXP'in duyarlı olacağını varsaymak: bazı
_as_cscollation'lar yine duyarsız eşleşir;BINARYveya(?-i)kullanın.
Sık Sorulan Sorular
Büyük/küçük harf duyarlı bir arama nasıl yaparım?
LIKE için karşılaştırmaya ikili bir collation verin (COLLATE utf8mb4_bin) veya bir tarafı BINARY'ye çevirin. REGEXP ailesinde BINARY ya da desen başında (?-i) kullanın. Rehberin önerdiği STRCMP() da tam eşleşmede 0 döndürür.
LIKE mi REGEXP mi kullanmalıyım?
Basit önek, sonek ve joker aramalarında LIKE yeterlidir ve desen jokerle başlamıyorsa index kullanabilir. Karakter sınıfları, tekrar sayıları veya geri başvurular gerekiyorsa REGEXP ve REGEXP_* fonksiyonlarına geçin.
IP adreslerini metin olarak sıralayınca neden yanlış çıkıyor?
Rehbere göre metin sıralaması sözlük sırasına göre yapılır, bu yüzden 10.0.11.1, 10.0.2.1'den önce gelir. Sayısal sıralama için ORDER BY INET_ATON(ip_address) kullanın; INET_NTOA() sayıyı tekrar adrese çevirir.
JSON içindeki metinleri de bu fonksiyonlarla mı işlemeliyim?
JSON belgeleri için özel fonksiyonlar vardır ve onları kullanmak daha güvenilirdir. Ayrıntılar MariaDB JSON fonksiyonları yazısında.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: MariaDB öğrenme rehberi · Karakter seti ve collation · FULLTEXT arama · SELECT, WHERE, ORDER BY · JSON fonksiyonları · Index oluşturma