MariaDB'de satırları ortak bir değere göre gruplayıp her grup için tek bir özet satırı üretmek için GROUP BY kullanırsınız; özet değerleri COUNT(), SUM(), AVG(), MIN(), MAX() ve GROUP_CONCAT() gibi toplama fonksiyonları hesaplar. Gruplamadan önce satırları WHERE, gruplamadan sonra grupları HAVING süzer; WITH ROLLUP ise ara toplam ve genel toplam satırları ekler.
Bu yazı resmî belgelerdeki GROUP BY, SELECT WITH ROLLUP, COUNT, SUM, AVG ve GROUP_CONCAT sayfalarına dayanır. Satır seçme temelleri SELECT, WHERE ve LIMIT, satırları gruplamadan her satırın yanında toplam veya sıra numarası hesaplamak ise window fonksiyonları yazısında anlatılıyor. Serinin tamamı için MariaDB öğrenme rehberine bakabilirsiniz.
Toplama fonksiyonları
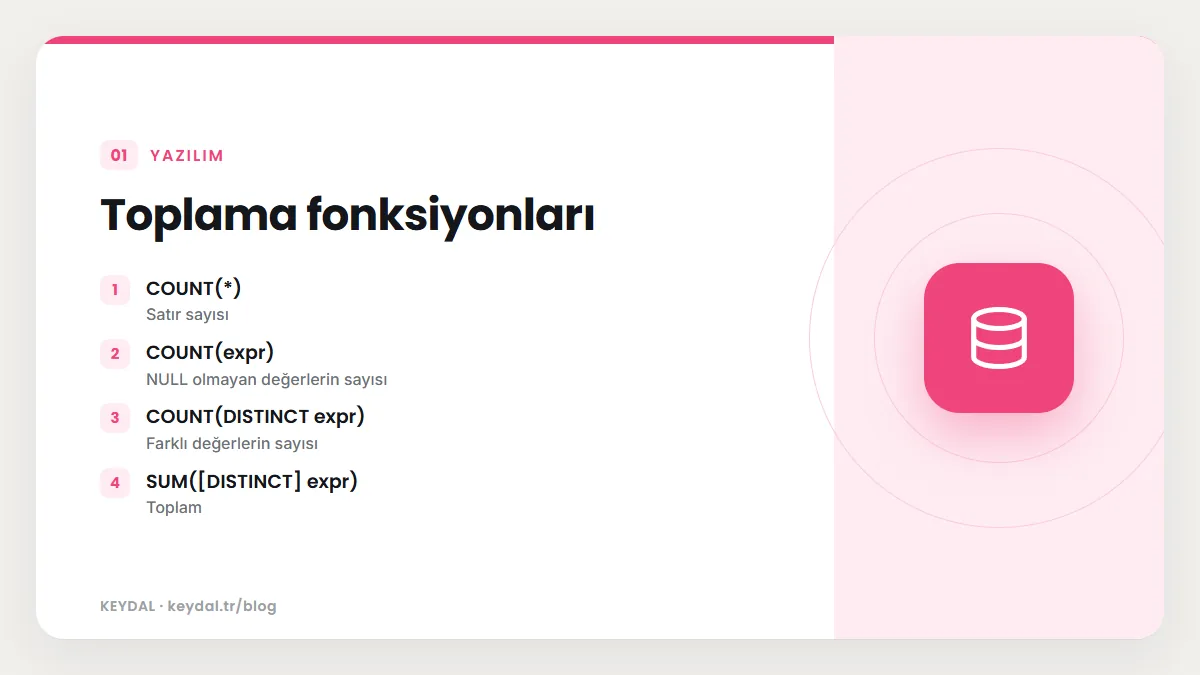
Toplama (aggregate) fonksiyonları bir satır kümesi üzerinde çalışıp tek bir değer döndürür. Belgede her birinin NULL ve boş küme davranışı ayrıca belirtilir ve bu ayrıntılar raporlardaki yanlış sayıların en sık kaynağıdır:
| Fonksiyon | Ne hesaplar | NULL ve boş küme davranışı |
|---|---|---|
| COUNT(*) | Satır sayısı | Eşleşen satır yoksa 0 |
| COUNT(expr) | NULL olmayan değerlerin sayısı | NULL değerleri saymaz, sonuç BIGINT |
| COUNT(DISTINCT expr) | Farklı değerlerin sayısı | NULL değerleri saymaz |
| SUM([DISTINCT] expr) | Toplam | Satır yoksa NULL |
| AVG([DISTINCT] expr) | Ortalama | NULL değerleri yok sayar, satır yoksa NULL |
| MIN(expr), MAX(expr) | En küçük ve en büyük | Satır yoksa NULL |
| GROUP_CONCAT(expr) | Değerleri tek dizede birleştirir | NULL değerleri atlar, hepsi NULL ise NULL |
Belgedeki öğrenci tablosu üzerinde COUNT(*) tüm satırları, COUNT(DISTINCT (name)) ise farklı öğrenci adlarını sayar:
CREATE TABLE student (name CHAR(10), test CHAR(10), score TINYINT);

INSERT INTO student VALUES
  ('Chun', 'SQL', 75), ('Chun', 'Tuning', 73),
  ('Esben', 'SQL', 43), ('Esben', 'Tuning', 31),
  ('Kaolin', 'SQL', 56), ('Kaolin', 'Tuning', 88),
  ('Tatiana', 'SQL', 87), ('Tatiana', 'Tuning', 83);

SELECT COUNT(*) FROM student;
+----------+
| COUNT(*) |
+----------+
|        8 |
+----------+

SELECT COUNT(DISTINCT (name)) FROM student;
+------------------------+
| COUNT(DISTINCT (name)) |
+------------------------+
|                      4 |
+------------------------+
DISTINCT anahtar sözcüğü SUM ve AVG ile de kullanılabilir. SUM sayfasındaki 10, 20, 20 ve 40 değerlerinde normal toplam 90, SUM(DISTINCT ...) ise tekrar eden 20'yi bir kez sayarak 70 verir; aynı tablodaki ortalama AVG(sales_value) için 22.5000 olarak gösterilir. MAX(DISTINCT ...) yazmak belgeye göre DISTINCT'siz hâliyle aynı sonucu verir.
CREATE TABLE sales (sales_value INT);
INSERT INTO sales VALUES(10),(20),(20),(40);

SELECT SUM(sales_value) FROM sales;
+------------------+
| SUM(sales_value) |
+------------------+
|               90 |
+------------------+

SELECT SUM(DISTINCT(sales_value)) FROM sales;
+----------------------------+
| SUM(DISTINCT(sales_value)) |
+----------------------------+
|                         70 |
+----------------------------+
GROUP BY yazmadan bir toplama fonksiyonu kullanırsanız, SELECT sayfasına göre tüm satırlar örtük olarak tek bir grup sayılır; belge bunu GROUP BY NULL yazılmış gibi düşünmenizi söyler. COUNT(*) ile COUNT(sutun) arasındaki fark da burada önemlidir: ilki satırları, ikincisi o sütunda NULL olmayan değerleri sayar. Örneğin telefon numarası boş bırakılmış müşteriler COUNT(telefon) sonucuna dahil edilmez.
GROUP BY nasıl çalışır?
GROUP BY, verdiğiniz ifade veya ifadeler için aynı değere sahip satırları bir araya toplar ve her grup için bir sonuç satırı üretir. Gruplama değerleri = operatörüyle karşılaştırılır; dizelerde bu, sondaki boşlukların yok sayılması ve collation'a göre büyük-küçük harf farkının önemsenmemesi anlamına gelebilir. Birden çok ifade virgülle verilir ve satırlar ancak hepsinde eşleşirlerse aynı gruba girer. Bir tamsayı yazarsanız seçim listesindeki o sıradaki sütuna göre gruplanır. Belgedeki oyun tablosu:
CREATE TABLE plays (name VARCHAR(16), plays INT, wins INT);
INSERT INTO plays VALUES
  ("John", 20, 5),
  ("Robert", 22, 8),
  ("Wanda", 32, 8),
  ("Susan", 17, 3);

SELECT wins, COUNT(*) FROM plays GROUP BY wins;
+------+----------+
| wins | COUNT(*) |
+------+----------+
|    3 |        1 |
|    5 |        1 |
|    8 |        2 |
+------+----------+
3 rows in set (0.00 sec)
Gruplama ifadesi hesaplanmış bir değer de olabilir ve AS ile verilen takma ada başvurabilir. Aşağıdaki sorgu kazanma oranına göre gruplayıp her oran için ortalama oyun sayısını verir:
SELECT (wins / plays) AS winavg, AVG(plays) FROM plays
  GROUP BY winavg;
+--------+------------+
| winavg | AVG(plays) |
+--------+------------+
| 0.1765 |    17.0000 |
| 0.2500 |    26.0000 |
| 0.3636 |    22.0000 |
+--------+------------+
3 rows in set (0.00 sec)
Belgeye göre GROUP BY varsa çıktı satırları varsayılan olarak gruplama ifadelerine göre sıralanır ve ifadelerden sonra ASC veya DESC yazabilirsiniz. Başka bir alana göre sıralamak için açık bir ORDER BY ekleyin; sıralamaya hiç ihtiyacınız yoksa ORDER BY NULL yazabilirsiniz. ORDER BY içinde toplama fonksiyonları kullanılabilir, çünkü sıralama gruplamadan sonra yapılır.
Uygulamalı örnek: kişi bazında satış raporu
SUM sayfasındaki ikinci örnek, yukarıdaki tek sütunlu tablodan farklı yapıda bir sales tablosu kullanır; denemek isterseniz önceki tabloyu silip bunu oluşturun. Her satıcının ocak ve şubat aylarındaki satış adetleri tutulur ve rapor, satıcı başına toplam adedi ister:
CREATE TABLE sales (name CHAR(10), month CHAR(10), units INT);

INSERT INTO sales VALUES
  ('Chun', 'Jan', 75), ('Chun', 'Feb', 73),
  ('Esben', 'Jan', 43), ('Esben', 'Feb', 31),
  ('Kaolin', 'Jan', 56), ('Kaolin', 'Feb', 88),
  ('Tatiana', 'Jan', 87), ('Tatiana', 'Feb', 83);

SELECT name, SUM(units) FROM sales GROUP BY name;
+---------+------------+
| name    | SUM(units) |
+---------+------------+
| Chun    |        148 |
| Esben   |         74 |
| Kaolin  |        144 |
| Tatiana |        170 |
+---------+------------+
Belge aynı tabloda çok sık yapılan bir hatayı da gösterir: GROUP BY yazmadan hem normal bir sütun hem toplama fonksiyonu seçmek. Bu durumda tüm satırlar tek grup sayılır, toplam bütün tablonun toplamıdır ve yanındaki ad gruptaki herhangi bir satırdan gelir. Sonuç, sanki yalnızca Chun 536 adet satmış gibi yanıltıcı bir satırdır:
SELECT name,SUM(units) FROM sales
;+------+------------+
| name | SUM(units) |
+------+------------+
| Chun |        536 |
+------+------------+
Bu sonuç sözdizimi açısından geçerli olduğu için hata mesajı almazsınız; raporu okuyan kişi de çoğu zaman sorunu fark etmez. Aynı raporu ay bazında da görmek isterseniz gruplamaya ikinci bir sütun ekleyip GROUP BY name, month yazarsınız; her satıcı için iki satır oluşur. Satıcı toplamlarını ve genel toplamı aynı sonuçta görmek içinse aşağıda anlatılan WITH ROLLUP kullanılabilir.
Gruplanmayan sütunlar ve ONLY_FULL_GROUP_BY
Seçim listesine ne gruplama ifadesinde geçen ne de bir toplama fonksiyonu içinde kullanılan bir sütun yazarsanız, belgeye göre değerin gruptaki hangi satırdan alınacağı tanımsızdır. MariaDB'nin varsayılan sql_mode değeri ONLY_FULL_GROUP_BY içermez, bu yüzden böyle bir sorgu hata vermeden çalışır ve sonuç kendi verinizle tutarlı görünse bile güvenilir değildir. ONLY_FULL_GROUP_BY kipini açarsanız bu tür sorgular 1055 hatasıyla reddedilir. Raporlarınızda tutarlılık istiyorsanız her seçilen sütunu ya gruplamaya ekleyin ya da bir toplama fonksiyonuna sarın.
SET SESSION sql_mode = CONCAT(@@sql_mode, ',ONLY_FULL_GROUP_BY');WHERE ile HAVING arasındaki fark
WHERE, gruplamadan önce tek tek satırları süzer ve toplama fonksiyonu içeremez. HAVING ise gruplamadan sonra çalışır, her grubu bir mantıksal ifadeyle değerlendirir ve toplama fonksiyonlarını kullanabilir. Belgedeki örnek, ortalama oyun sayısı 20'nin üzerinde olan grupları bırakır:
SELECT (wins / plays) AS winavg, AVG(plays) FROM plays
  GROUP BY winavg HAVING AVG(plays) > 20;
+--------+------------+
| winavg | AVG(plays) |
+--------+------------+
| 0.2500 |    26.0000 |
| 0.3636 |    22.0000 |
+--------+------------+
2 rows in set (0.00 sec)
Pratik kural şudur: koşul tek bir satırın sütunlarıyla ifade edilebiliyorsa WHERE içine yazın; böylece gruplanacak satır sayısı baştan azalır. Koşul bir grubun toplamına, sayısına veya ortalamasına bağlıysa HAVING kullanın. Belge, HAVING içinde gruplanmamış sütunlara başvurmanın da tanımsız davranış olduğunu not eder.
Takma ad tuzağı
GROUP BY sayfası, takma adın bir tablo sütunuyla aynı adı taşıdığı durumu ayrıca açıklar. GROUP BY içinde bu ad takma adı değil tablo sütununu gösterir ve MariaDB 1052 kodlu bir uyarı verir. HAVING ise genellikle takma adı kullanır; ancak GROUP BY aynı adlı tablo sütununu kullanıyorsa o da tablo sütununa döner. ORDER BY her zaman takma adı tercih eder. Belgedeki örnekte sorgu renklere değil kategorilere göre gruplanır:
CREATE TABLE items (category VARCHAR(10), color VARCHAR(10));
INSERT INTO items VALUES ('shirt','red'), ('shirt','blue'), ('hat','red');

SELECT color AS category, COUNT(*) FROM items GROUP BY category;
+----------+----------+
| category | COUNT(*) |
+----------+----------+
| red      |        1 |
| red      |        2 |
+----------+----------+

SHOW WARNINGS;
+---------+------+--------------------------------------------+
| Level   | Code | Message                                    |
+---------+------+--------------------------------------------+
| Warning | 1052 | Column 'category' in GROUP BY is ambiguous |
+---------+------+--------------------------------------------+
Sonuçtaki iki grup aslında hat ve shirt kategorileridir; gösterilen renk değeri her gruptaki rastgele bir satırdan gelir. Takma adı çakışmayan bir adla, örneğin shade olarak verdiğinizde sorgu beklendiği gibi renklere göre gruplanır ve belge blue için 1, red için 2 sonucunu gösterir. En basit çözüm, takma adlara hiçbir zaman tablodaki bir sütunun adını vermemektir.
WITH ROLLUP ile ara toplamlar
WITH ROLLUP, sonuç kümesine üst düzey özet satırları ekler. Özetlenen sütun bu satırlarda NULL olarak görünür. Birden çok gruplama sütunu varsa her düzey için ayrı ara toplam satırları eklenir. Belgedeki kitap satışı tablosunda yıl bazında toplam ve en altta genel toplam:
CREATE TABLE booksales (
  country VARCHAR(35), genre ENUM('fiction','non-fiction'), year YEAR, sales INT);

INSERT INTO booksales VALUES
  ('Senegal','fiction',2014,12234), ('Senegal','fiction',2015,15647),
  ('Senegal','non-fiction',2014,64980), ('Senegal','non-fiction',2015,78901),
  ('Paraguay','fiction',2014,87970), ('Paraguay','fiction',2015,76940),
  ('Paraguay','non-fiction',2014,8760), ('Paraguay','non-fiction',2015,9030);

SELECT year, SUM(sales) FROM booksales GROUP BY year WITH ROLLUP;
+------+------------+
| year | SUM(sales) |
+------+------------+
| 2014 |     173944 |
| 2015 |     180518 |
| NULL |     354462 |
+------+------------+
Üç sütunla (country, year, genre) gruplandığında her tür değiştiğinde yıl için, her yıl değiştiğinde ülke için, en sonda da tüm tablo için birer özet satırı eklenir; belgede Paraguay 2014 için 96730, Paraguay toplamı için 182700 ve genel toplam için 354462 değerleri bu şekilde görünür. Aynı sorguya LIMIT 4 eklendiğinde sınırın özet satırları eklendikten sonra uygulandığı görülür, çünkü üçüncü satır zaten bir ara toplamdır:
SELECT country, year, genre, SUM(sales)
  FROM booksales GROUP BY country, year, genre WITH ROLLUP LIMIT 4;
+----------+------+-------------+------------+
| country  | year | genre       | SUM(sales) |
+----------+------+-------------+------------+
| Paraguay | 2014 | fiction     |      87970 |
| Paraguay | 2014 | non-fiction |       8760 |
| Paraguay | 2014 | NULL        |      96730 |
| Paraguay | 2015 | fiction     |      76940 |
+----------+------+-------------+------------+
Belgeye göre WITH ROLLUP bir ORDER BY ile birlikte kullanılamaz; sıralamayı gruplama sütunlarının yanına ASC veya DESC yazarak kısmen etkileyebilirsiniz, ama özet satırları her zaman sona eklenir. LIMIT ise özet satırları eklendikten sonra uygulanır. Bir dikkat noktası: gruplama sütununda gerçek NULL değerler varsa, bunları özet satırının NULL'ından ayırt etmek zorlaşır; bu tür sütunları rapordan önce temizlemek veya varsayılan bir değerle doldurmak işinizi kolaylaştırır.
GROUP_CONCAT ile değerleri birleştirmek
GROUP_CONCAT(), gruptaki NULL olmayan değerleri tek bir dizede birleştirir. Tam sözdizimi DISTINCT, kendi ORDER BY'ı, SEPARATOR ve LIMIT içerir. Varsayılan ayırıcı virgüldür; boş dize vererek ayırıcıyı kaldırabilirsiniz. Belgedeki örnek her kullanıcının bağlanabildiği hostları sıralı ve virgülle ayrılmış olarak listeler:
SELECT User, GROUP_CONCAT(Host ORDER BY Host SEPARATOR ', ')
   FROM mysql.user GROUP BY User ORDER BY User;
Burada iki ORDER BY farklı işler yapar: fonksiyonun içindeki birleştirilen hostları, dışarıdaki ise sonuç satırlarını sıralar. Dönen dizenin bayt cinsinden en fazla uzunluğunu group_concat_max_len sistem değişkeni belirler ve varsayılanı 1M'dir. Sonuç bu sınırı aşarsa kesilir ve Warning (Code 1260): Row 2 was cut by group_concat() biçiminde bir uyarı üretilir. Uzun listeler üretiyorsanız uyarıları kontrol edin ya da değişkeni oturum düzeyinde büyütün.
NULL davranışı da belgede örneklenir: birden çok ifade verildiğinde ifadelerden biri NULL olan satır listeye hiç girmez.
CREATE OR REPLACE TABLE t1 (a int, b char);

INSERT INTO t1 VALUES (1, 'a'), (2, NULL);

SELECT GROUP_CONCAT(a, b) FROM t1;
+--------------------+
| GROUP_CONCAT(a, b) |
+--------------------+
| 1a                 |
+--------------------+
İç içe toplama gerektiğinde
Toplama fonksiyonları doğrudan iç içe yazılamaz: her öğrencinin toplam puanlarının ortalamasını AVG(SUM(score)) ile almak ERROR 1111 (HY000): Invalid use of group function verir. Çözüm, iç toplamı bir türetilmiş tabloda hesaplayıp dış sorguda ortalamasını almaktır; örnek ve açıklama JOIN ve alt sorgular yazısında. Satırları tek bir özet satırına indirmeden her satırın yanında grup toplamını görmek istiyorsanız COUNT(), SUM() ve AVG() fonksiyonlarının OVER (PARTITION BY ...) ile pencere fonksiyonu olarak da kullanılabildiğini hatırlayın.
Sık yapılan hatalar
- Toplama fonksiyonunu WHERE içinde kullanmak.
WHERE COUNT(*) > 1geçersizdir; grup koşullarıHAVINGiçine yazılır. - Gruplanmamış sütunları seçmek. Varsayılan kipte hata vermez ama değer gruptaki rastgele bir satırdan gelir;
ONLY_FULL_GROUP_BYile sorunu erken yakalayın. - COUNT(sutun) ile satır saydığını sanmak.
NULLdeğerler sayılmaz; tüm satırlar içinCOUNT(*)kullanın. - Boş kümede SUM sonucunun 0 olmasını beklemek. Eşleşen satır yoksa
SUM()NULLdöndürür; gerekiyorsaCOALESCE(SUM(x), 0)yazın. - Takma ada tablo sütunuyla aynı adı vermek.
GROUP BYtablo sütununu kullanır ve 1052 uyarısı üretir. - WITH ROLLUP ile ORDER BY yazmak. İkisi birlikte kullanılamaz; sıralamayı gruplama sütunlarının yanına
DESCekleyerek verin. - GROUP_CONCAT sonucunun kesildiğini fark etmemek. 1260 uyarısını kontrol edin.
Sık Sorulan Sorular
GROUP BY sonuçları sıralı gelir mi?
Belgeye göre GROUP BY varsa satırlar varsayılan olarak gruplama ifadelerine göre sıralanır. Belirli bir sıra istiyorsanız yine de açık bir ORDER BY yazmanız, niyetinizi de belgeler.
DISTINCT mi, GROUP BY mi?
Yalnızca tekrarları atmak istiyorsanız DISTINCT yeterlidir. Her grup için sayı, toplam veya ortalama gibi bir özet gerekiyorsa GROUP BY ile bir toplama fonksiyonu kullanırsınız. Belgeye göre iki yapı da tüm NULL değerleri eşit sayar.
Büyük tablolarda GROUP BY yavaşsa ne yapmalıyım?
Önce WHERE ile gruplanacak satır sayısını azaltın, ardından sorgunun planını EXPLAIN ve ANALYZE ile inceleyin. Gruplama sütunlarına uygun indeks indeks oluşturma yazısında anlatılıyor.
Toplamları satır kaybetmeden nasıl gösteririm?
Pencere fonksiyonları her satırı korurken grup toplamını ayrı bir sütunda verir; COUNT sayfasında COUNT(score) OVER (PARTITION BY name) örneği bulunur. Ayrıntılar window fonksiyonları yazısında.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: MariaDB öğrenme rehberi · SELECT ve WHERE · JOIN ve alt sorgular · window fonksiyonları · CTE · SQL nedir