Sunucu loglarınızda “Googlebot” yazan binlerce istek görmek, sitenizin Google tarafından düzenli tarandığı anlamına gelebilir. Ama gelebilir, o kadar. Google'ın kendi belgesi açıkça uyarıyor: HTTP user-agent dizesi taklit edilebilir. İçerik kazıyan botlar, zafiyet tarayıcıları ve spam araçları, güvenlik duvarlarından geçmek için kendilerini sık sık Googlebot gibi tanıtır.
Bu yazıda bir isteğin gerçekten Google'dan gelip gelmediğini nasıl doğrulayacağınızı adım adım anlatıyoruz: ters DNS ve ileri DNS kontrolü, Google'ın yayımladığı IP aralığı JSON dosyaları, Google'ın üç tarayıcı kategorisi ve Google-Extended gibi özel belirteçler. Amaç iki yönlü: sahte botları ayıklamak ve aynı anda gerçek Googlebot'u yanlışlıkla engellememek.
Google tarayıcıları kendilerini üç şekilde tanıtır
Google'a göre tarayıcıları ve getiricileri (fetcher) bir isteği şu üç bilgiyle tanımlar: HTTP user-agent başlığı, isteğin geldiği kaynak IP adresi ve bu IP'nin ters DNS ile çözülen ana makine adı. Bunlardan yalnızca ilki isteği yapan tarafın kontrolündedir; bu yüzden tek başına güvenilir değildir. Doğrulama her zaman IP ve DNS tarafına dayanır.
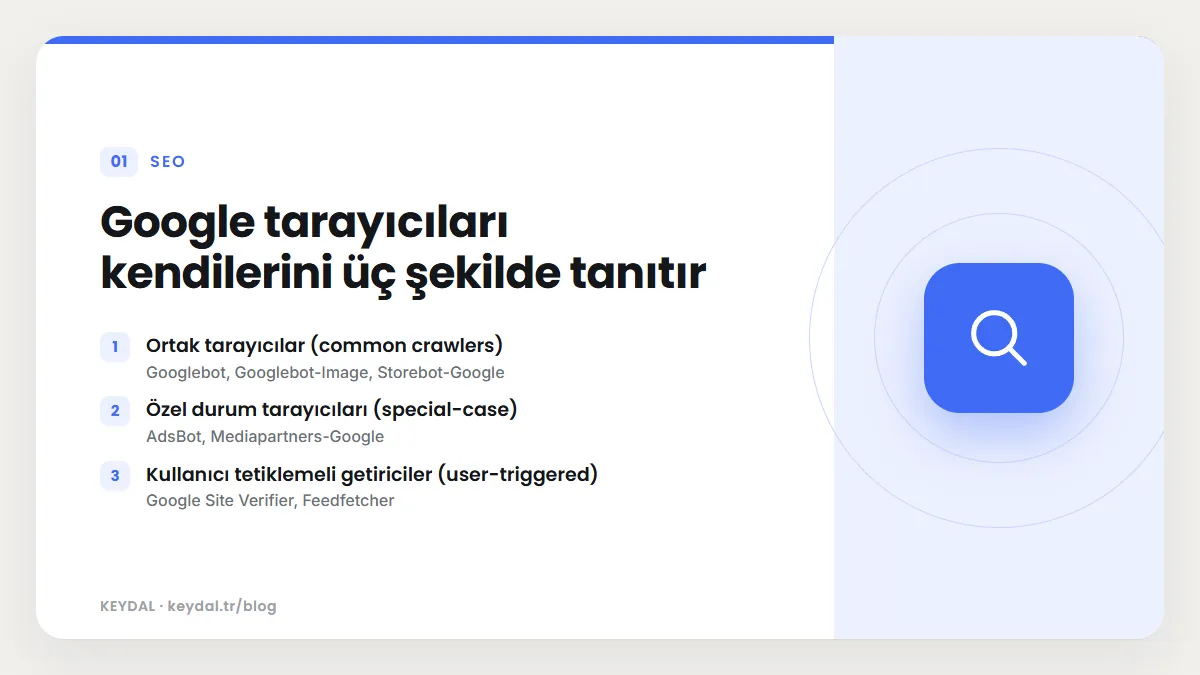
Google, tarayıcılarını ve getiricilerini üç kategoriye ayırır. Her kategorinin robots.txt davranışı, ters DNS maskesi ve IP listesi farklıdır:
| Kategori | Örnek | robots.txt | Ters DNS maskesi | IP listesi |
|---|---|---|---|---|
| Ortak tarayıcılar (common crawlers) | Googlebot, Googlebot-Image, Storebot-Google | Otomatik taramalarda her zaman uyar | crawl-***-***-***-***.googlebot.com veya geo-crawl-***-***-***-***.geo.googlebot.com | common-crawlers.json |
| Özel durum tarayıcıları (special-case) | AdsBot, Mediapartners-Google | Uyabilir veya uymayabilir | rate-limited-proxy-***-***-***-***.google.com | special-crawlers.json |
| Kullanıcı tetiklemeli getiriciler (user-triggered) | Google Site Verifier, Feedfetcher | Kullanıcı istediği için genellikle yok sayar | ***-***-***-***.gae.googleusercontent.com veya google-proxy-***-***-***-***.google.com | user-triggered-fetchers.json, user-triggered-fetchers-google.json, user-triggered-agents.json |
Yöntem 1: Ters DNS ve ileri DNS ile elle doğrulama
Google, tek tük kontroller için komut satırı yöntemini öneriyor ve çoğu kullanım için bunun yeterli olduğunu belirtiyor. Adımlar şunlar:
- Loglarınızdaki IP adresi için
hostkomutuyla ters DNS sorgusu yapın. - Dönen alan adının
googlebot.com,google.comveyagoogleusercontent.comile bittiğini kontrol edin. - Birinci adımda bulduğunuz alan adı için yine
hostkomutuyla ileri DNS sorgusu yapın. - Dönen IP adresinin, logdaki orijinal IP ile aynı olduğunu doğrulayın.
Google'ın belgesindeki örnek, Googlebot için şöyle görünür:
host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.

host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1
Coğrafi dağıtık tarama yapan bir Googlebot isteğinde ana makine adı geo.googlebot.com altında olur:
host 35.247.243.240
240.243.247.35.in-addr.arpa domain name pointer geo-crawl-35-247-243-240.geo.googlebot.com.

host geo-crawl-35-247-243-240.geo.googlebot.com
geo-crawl-35-247-243-240.geo.googlebot.com has address 35.247.243.240
AdsBot gibi özel durum tarayıcılarında ise ad rate-limited-proxy-...google.com biçimindedir:
host 66.249.90.77
77.90.249.66.in-addr.arpa domain name pointer rate-limited-proxy-66-249-90-77.google.com.

host rate-limited-proxy-66-249-90-77.google.com
rate-limited-proxy-66-249-90-77.google.com has address 66.249.90.77
Neden iki yönlü kontrol şart?
Ters DNS kaydını (PTR) IP bloğunun sahibi belirler. Kötü niyetli biri kendi IP'si için crawl-1-2-3-4.googlebot.com gibi görünen bir PTR kaydı yazabilir. Ancak googlebot.com alanının DNS'ini kontrol edemeyeceği için ileri sorgu onun IP'sine dönmez. Bu yüzden ikinci adımı atlamayın: ters sorgu tek başına kanıt değildir.
Windows'ta nslookup ile aynı kontrol
Windows komut isteminde host yoksa aynı iki sorguyu nslookup ile yapabilirsiniz. Çıktıda “Name:” satırındaki ana makine adına, ardından ileri sorguda “Address:” satırına bakın:
nslookup 66.249.66.1
nslookup crawl-66-249-66-1.googlebot.com
Küçük bir kabuk betiği
Aşağıdaki betik, yukarıdaki dört adımı tek bir IP için otomatikleştiren basit bir örnektir. Google'ın kabul ettiği alan adı sonlarını kontrol eder ve ileri sorgunun aynı IP'ye dönüp dönmediğine bakar:
#!/bin/sh
ip="$1"
ad=$(host "$ip" | awk '/pointer/ {print $NF}' | sed 's/\.$//')
case "$ad" in
  *.googlebot.com|*.google.com|*.googleusercontent.com) ;;
  *) echo "Google'a ait değil: $ip ($ad)"; exit 1 ;;
esac
if host "$ad" | grep -q "has address $ip"; then
  echo "Doğrulandı: $ip = $ad"
else
  echo "İleri DNS eşleşmedi, sahte olabilir: $ip ($ad)"
  exit 1
fi
Yöntem 2: IP aralığı JSON dosyalarıyla otomatik doğrulama
Çok sayıda isteği kontrol etmeniz gerekiyorsa her IP için DNS sorgusu yapmak yavaş kalır. Google bu durum için otomatik yöntemi öneriyor: gelen IP'yi, Google'ın yayımladığı IP aralığı listeleriyle karşılaştırmak. Listeler JSON formatındadır ve IP adresleri CIDR gösterimindedir:
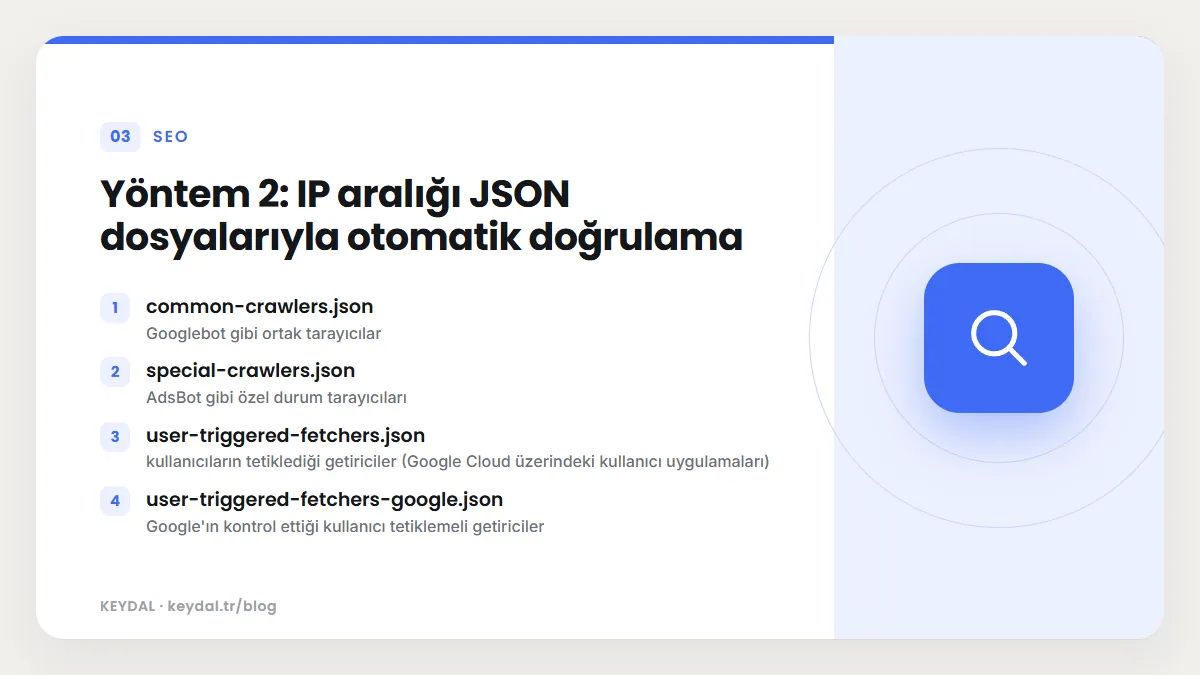
- common-crawlers.json: Googlebot gibi ortak tarayıcılar
- special-crawlers.json: AdsBot gibi özel durum tarayıcıları
- user-triggered-fetchers.json: kullanıcıların tetiklediği getiriciler (Google Cloud üzerindeki kullanıcı uygulamaları)
- user-triggered-fetchers-google.json: Google'ın kontrol ettiği kullanıcı tetiklemeli getiriciler
- user-triggered-agents.json: Google-Agent gibi kullanıcı adına çalışan ajanlar
Apps Script gibi diğer Google hizmetlerinden gelen istekler için Google, genel goog.json listesine bakmanızı öneriyor.
Aşağıdaki Python örneği, JSON dosyalarının iç yapısına bağlı kalmadan içindeki tüm CIDR bloklarını toplar ve verilen IP'nin hangi listede olduğunu söyler. Listeler değişebileceği için betiği her kullanımda güncel dosyayı indirecek şekilde yazdık:
import ipaddress, json, sys, urllib.request

KAYNAK = "https://developers.google.com/static/crawling/ipranges/"
LISTELER = ["common-crawlers.json", "special-crawlers.json",
            "user-triggered-fetchers.json", "user-triggered-fetchers-google.json",
            "user-triggered-agents.json"]

def bloklar(veri, sonuc):
    # JSON yapisindan bagimsiz: CIDR olarak okunabilen her metni topla
    if isinstance(veri, dict):
        for v in veri.values():
            bloklar(v, sonuc)
    elif isinstance(veri, list):
        for v in veri:
            bloklar(v, sonuc)
    elif isinstance(veri, str) and "/" in veri:
        try:
            sonuc.append(ipaddress.ip_network(veri, strict=False))
        except ValueError:
            pass
    return sonuc

ip = ipaddress.ip_address(sys.argv[1])
for ad in LISTELER:
    with urllib.request.urlopen(KAYNAK + ad) as yanit:
        aglar = bloklar(json.load(yanit), [])
    if any(ip in ag for ag in aglar if ag.version == ip.version):
        print(ip, "listede:", ad)
        break
else:
print(ip, "Google tarayıcı listelerinde yok")Ortak tarayıcılar: Googlebot ve kardeşleri
Ortak tarayıcılar Google'ın arama dizinlerini oluşturmak ve ürüne özel taramalar yapmak için kullanılır; otomatik taramada robots.txt kurallarına her zaman uyarlar. Loglarda en sık göreceğiniz belirteçler ve etkiledikleri ürünler:
| robots.txt belirteci | Ne işe yarar / neyi etkiler |
|---|---|
Googlebot | Google Arama (Discover ve tüm arama özellikleri dahil), Google Görseller, Video modu, Google Haberler. Smartphone ve Desktop olmak üzere iki ana user-agent dizesi vardır. |
Googlebot-Image | Google Görseller, Discover, Video modu ve görsel, logo, favicon gösterilen arama özellikleri. |
Googlebot-Video | Videoyla ilgili arama özellikleri ve videoya dayalı diğer ürünler. |
Googlebot-News | Google Haberler ürünü (news.google.com ve Google Haberler uygulaması). Ayrı bir HTTP user-agent dizesi yoktur; tarama Googlebot dizeleriyle yapılır. |
Storebot-Google | Google Alışveriş yüzeyleri. |
Google-InspectionTool | Zengin Sonuç Testi ve Search Console URL Denetimi gibi test araçları. Google Arama sonuçlarını etkilemez. |
GoogleOther, GoogleOther-Image, GoogleOther-Video | Belirli bir ürünü etkilemeyen genel amaçlı tarayıcı; örneğin dahili araştırma için tek seferlik taramalar. |
Google-CloudVertexBot | Site sahiplerinin Vertex AI Agents oluşturmak için istediği taramalar. Google Arama’yı etkilemez. |
User-agent dizelerindeki Chrome/W.X.Y.Z kısmı, Googlebot'un kullandığı Chromium sürümüyle birlikte zamanla değişir. Google, loglarda veya sunucu filtrelerinde arama yaparken sürüm numarasını sabit yazmamanızı, joker karakter kullanmanızı öneriyor.
Google-Extended: tarayıcı değil, kontrol belirteci
Google-Extended sık karıştırılan bir konu. Bu belirtecin ayrı bir HTTP user-agent dizesi yoktur; tarama mevcut Google user-agent dizeleriyle yapılır ve robots.txt belirteci yalnızca kontrol amacıyla kullanılır. Google'a göre site sahipleri bu belirteçle, Google'ın sitelerinden taradığı içeriğin gelecekteki Gemini modellerinin eğitiminde ve Gemini Apps ile Vertex AI'daki “grounding” (yanıtı arama dizinindeki içerikle destekleme) için kullanılıp kullanılmayacağını yönetebilir.
User-agent: Google-Extended
Disallow: /Özel durum tarayıcıları ve kullanıcı tetiklemeli getiriciler
Özel durum tarayıcıları, site ile Google ürünü arasında tarama konusunda bir anlaşma olan durumlarda kullanılır. Örneğin AdsBot-Google, AdsBot-Google-Mobile, Mediapartners-Google ve APIs-Google robots.txt'deki genel * grubunu yok sayar; bunları engellemek istiyorsanız adlarıyla ayrı bir grup yazmanız gerekir. Google-Safety ise kötüye kullanıma yönelik taramalar (örneğin Google mülklerinde paylaşılan bağlantılarda kötü amaçlı yazılım tespiti) yaptığı için robots.txt kurallarını hiç dikkate almaz.
Kullanıcı tetiklemeli getiriciler ise bir kullanıcının isteğiyle çalışır ve bu yüzden genellikle robots.txt'yi yok sayar. Belgede listelenenlerden bazıları: Google Site Verifier (Search Console doğrulama dosyalarını çeker), Feedfetcher (Google Haberler ve WebSub için RSS/Atom akışları), Google Read Aloud, Google Messages (sohbette paylaşılan bağlantıların önizlemesi), Chrome Web Store ve Gemini Notebook (eski adı Google-NotebookLM, Ağustos 2026'ya kadar destekleniyordu). Google-Agent ise Google altyapısında barındırılan ajanların kullanıcı isteğiyle web'de gezinmesi için kullanılır ve user-triggered-agents.json aralıklarından gelir.
Googlebot nereden tarar? Coğrafi tarama ve güvenlik duvarı
Google'ın tarayıcıları dünyanın farklı veri merkezlerine dağıtılmıştır; bu yüzden loglarınızda birden fazla IP görmeniz normaldir. Google ağırlıklı olarak ABD'deki IP adreslerinden çıkış yapar. Google bir sitenin ABD'den gelen istekleri engellediğini fark ederse başka ülkelerdeki IP'lerden taramayı deneyebilir. Ülkeye göre içerik değiştiren siteler için Google'ın tavsiyesi nettir: Googlebot belli bir ülkeden geliyormuş gibi görünüyorsa ona o ülkeden gelen herhangi bir kullanıcı gibi davranın. Bu konunun ayrıntıları hreflang ve çok dilli site rehberimizde.
Sahte bot tespit ettiğinizde ne yapmalı?
Aşağıdaki adımlar Google'ın belgesinden değil, yaygın sistem yönetimi pratiğinden gelir; kendi altyapınıza göre uyarlayın:
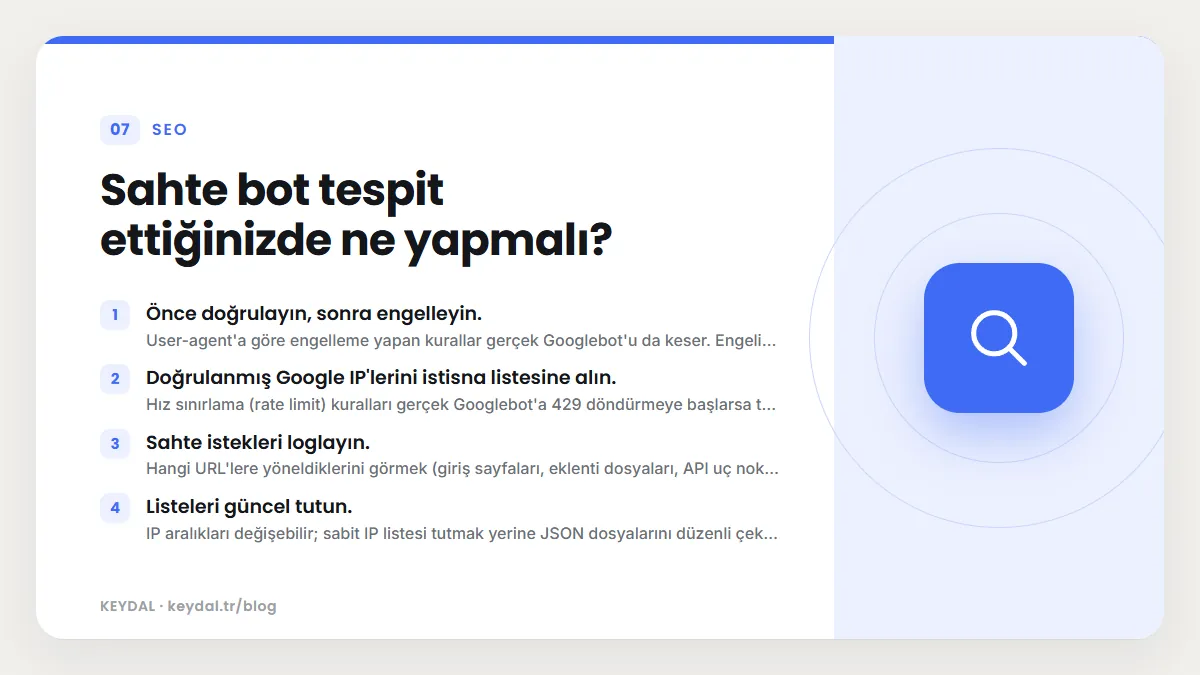
- Önce doğrulayın, sonra engelleyin. User-agent'a göre engelleme yapan kurallar gerçek Googlebot'u da keser. Engeli IP doğrulamasına dayandırın.
- Doğrulanmış Google IP'lerini istisna listesine alın. Hız sınırlama (rate limit) kuralları gerçek Googlebot'a 429 döndürmeye başlarsa tarama yavaşlar; bunun etkileri tarama bütçesi rehberimizde anlatılıyor.
- Sahte istekleri loglayın. Hangi URL'lere yöneldiklerini görmek (giriş sayfaları, eklenti dosyaları, API uç noktaları) güvenlik açısından değerlidir.
- Listeleri güncel tutun. IP aralıkları değişebilir; sabit IP listesi tutmak yerine JSON dosyalarını düzenli çekin.
Tarama tarafında Google'ın sitenizi nasıl gördüğünü izlemek için Search Console'daki “Crawl Stats” (Tarama İstatistikleri) raporuna bakabilirsiniz; rapor Googlebot türüne göre dağılım da gösterir. Not: Search Console arayüzündeki Türkçe etiketler, bu yazıda parantez içinde verdiğimiz karşılıklardan biraz farklı olabilir. Emin olmadığımız yerlerde İngilizce orijinal adı tırnak içinde kullandık.
Sık Sorulan Sorular
Googlebot'un IP adresleri sabit mi, listeyi bir kez kaydetsem yeter mi?
Hayır. Google tarayıcılarının dünyaya dağıtılmış çok sayıda makineden çalıştığını ve loglarda farklı IP'ler görebileceğinizi belirtiyor. IP listelerini sabit bir dosyada tutmak yerine yayımlanan JSON dosyalarından düzenli olarak güncelleyin ya da DNS tabanlı doğrulama yapın.
Robots.txt'de engellediğim hâlde bir Google aracı sayfamı çekiyor, bu sahte mi?
Olmayabilir. Kullanıcı tetiklemeli getiriciler (örneğin Google Site Verifier) kullanıcının isteğiyle çalıştığı için genellikle robots.txt'yi yok sayar. AdsBot gibi özel durum tarayıcıları da genel * grubunu dikkate almaz. Önce IP'yi ve ters DNS adını kontrol edin, sonra karar verin.
Google-Extended'i engellersem Google sıralamam düşer mi?
Google'ın belgesine göre hayır: Google-Extended, sitenin Google Arama'ya dahil edilmesini etkilemez ve sıralama sinyali olarak kullanılmaz.
Logdaki Googlebot isteklerinin bir kısmı googleusercontent.com adına çözülüyor, normal mi?
gae.googleusercontent.com adları, Google Cloud üzerinde çalışan uygulamaların kullanıcı adına yaptığı getirmelere aittir. Google'ın ortak tarayıcısı Googlebot ise googlebot.com altındaki adlara çözülür. Kendini Googlebot olarak tanıtan bir istek googlebot.com dışındaki bir ada çözülüyorsa dikkatle inceleyin.
İlgili içerikler: Tarama bütçesi · robots.txt rehberi · Site taşıma rehberi · Bingbot ve Yandex bot doğrulama · HTTP durum kodları · Teknik SEO kontrol listesi