SQLite'ta iki metnin eşit mi, hangisinin önce mi geldiğine sıralama kuralı (collating sequence, kısaca collation) karar verir. Yerleşik üç kural vardır: bayt bayt karşılaştıran BINARY (varsayılan), 26 ASCII harfte büyük-küçük farkını yok sayan NOCASE ve sondaki boşlukları dikkate almayan RTRIM. Kuralı sütun tanımında, indekste veya tek bir ifadede COLLATE ile seçersiniz.
Bu yazıda kuralın hangi sırayla belirlendiğini, UNIQUE, GROUP BY ve DISTINCT üzerindeki etkisini, indekslerin neden yalnızca eşleşen kuralla kullanıldığını ve Türkçe metinde NOCASE kuralının nerede yetersiz kaldığını göreceksiniz. Örneklerin büyük-küçük harfle ilgili sonuçları standart bir SQLite derlemesinden alınmıştır.
Üç yerleşik kural: BINARY, NOCASE ve RTRIM
Belgeye göre BINARY metinleri metin kodlamasından bağımsız olarak memcmp() ile, yani ham baytlarına göre karşılaştırır. NOCASE aynı işi yapar, ancak karşılaştırmadan önce ASCII'deki 26 büyük harfi küçüklerine çevirir. Belge açıkça yalnızca ASCII harflerin katlandığını, tam UTF katlamasının tablo boyutu nedeniyle yapılmadığını belirtir. RTRIM ise BINARY gibidir ama sondaki boşlukları yok sayar; baştaki boşluklar önemlidir.
Sıralama kuralları yalnızca iki metin karşılaştırılırken devreye girer. Sayılar her zaman sayısal olarak, BLOB değerler her zaman bayt bayt karşılaştırılır. Bir sütuna kural atanmamışsa o sütunun kuralı BINARY'dir; CREATE TABLE ... AS SELECT ile oluşturulan tabloların sütunları da her zaman BINARY olur.
CREATE TABLE t(
  id INTEGER PRIMARY KEY,
  a  TEXT,                  -- varsayılan: BINARY
  b  TEXT COLLATE NOCASE,
  c  TEXT COLLATE RTRIM
);
INSERT INTO t(a, b, c) VALUES ('abc', 'abc', 'abc');

SELECT a = 'ABC', b = 'ABC', c = 'abc   ' FROM t;
-- çıktı: 0|1|1

SELECT 'abc  ' = 'abc', 'abc  ' = 'abc' COLLATE RTRIM, '  abc' = 'abc' COLLATE RTRIM;
-- çıktı: 0|1|0
Bu örnekte b sütunu NOCASE tanımlandığı için b = 'ABC' doğru çıktı; a sütunu varsayılan BINARY kuralla yanlış verdi. c sütunu RTRIM olduğu için sondaki boşluklar önemsenmedi. Son satır da RTRIM'in yalnızca sağdaki boşluklarla ilgilendiğini gösteriyor.
Kuralı nereye yazacağınız, etkisinin ne kadar geniş olacağını belirler. Sütun tanımındaki COLLATE o sütunun varsayılanıdır ve o sütunla yapılan her karşılaştırmaya, sıralamaya, gruplamaya, benzersizlik denetimine ve o sütun üzerinde kural belirtilmeden kurulan indekslere yansır. İfade düzeyindeki COLLATE ise yalnızca yazıldığı karşılaştırmayı veya ORDER BY terimini etkiler ve sütun kuralını o an için geçersiz kılar. Genel bir kural olarak, verinin doğası gereği harf büyüklüğünün anlamsız olduğu alanlarda (e-posta, alan adı, ürün kodu) kuralı sütuna koymak, yalnızca belirli bir ekranda gereken davranışlar için ise ifade düzeyini kullanmak şemayı daha öngörülebilir tutar. RTRIM, sonu boşlukla doldurulmuş sabit genişlikli verilerle karşılaştırma yaparken işe yarar; yeni tasarımlarda ise boşlukları kayıt anında temizlemek daha açık bir yoldur.
ORDER BY ile sıralama: BINARY neden "Çorum" ile "Zonguldak" arasında şaşırtır?
BINARY kural UTF-8 baytlarına baktığı için önce tüm ASCII büyük harfler (A-Z), sonra ASCII küçük harfler (a-z), en sonda da çok baytlı karakterler gelir. Ç, İ, ı gibi harfler iki baytla kodlandığı ve ilk baytları ASCII aralığının üstünde olduğu için listenin sonuna düşer. NOCASE büyük-küçük ayrımını ASCII harflerde kaldırır, ama Türkçe harflerin konumunu değiştirmez.
CREATE TABLE sehir(ad TEXT);
INSERT INTO sehir VALUES ('izmir'), ('Ankara'), ('Çorum'), ('aydın'), ('Zonguldak'),
                         ('Iğdır'), ('ısparta'), ('İstanbul'), ('bursa');

SELECT group_concat(ad, ', ') FROM (SELECT ad FROM sehir ORDER BY ad);
-- çıktı: Ankara, Iğdır, Zonguldak, aydın, bursa, izmir, Çorum, İstanbul, ısparta

SELECT group_concat(ad, ', ') FROM (SELECT ad FROM sehir ORDER BY ad COLLATE NOCASE);
-- çıktı: Ankara, aydın, bursa, izmir, Iğdır, Zonguldak, Çorum, İstanbul, ısparta
BINARY sıralamada büyük harfle başlayan "Ankara", "Iğdır" ve "Zonguldak" küçük harfle başlayanlardan önce geldi. NOCASE ile "aydın", "bursa" ve "izmir" doğru yerlerine kaydı; "Iğdır" ise "izmir"in hemen arkasına geçti, çünkü NOCASE için I ile i aynı harftir. Türkçe alfabede ı harfi i harfinden önce gelir ve Ç harfi C ile D arasındadır; yerleşik kuralların hiçbiri bunu bilmez. Belge, ORDER BY teriminde açık COLLATE varsa onun, yoksa ifade bir sütunsa sütunun kuralının, bunlar da yoksa BINARY kuralının kullanılacağını belirtir.
NOCASE ve Türkçe harfler
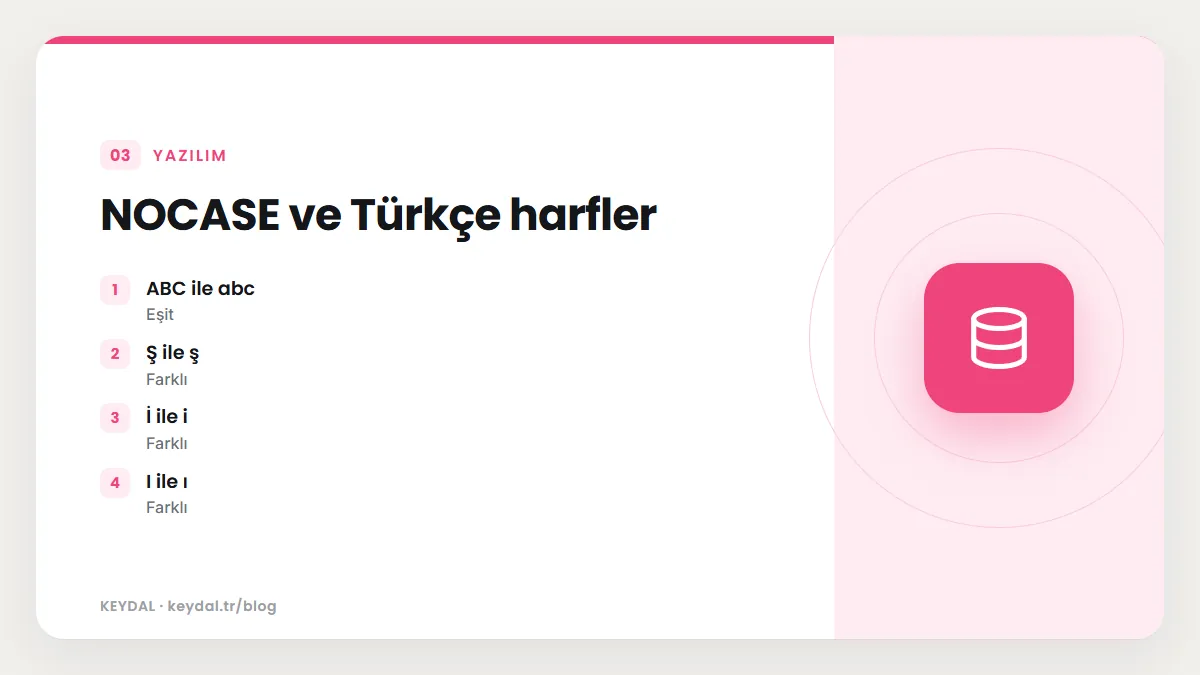
NOCASE yalnızca ASCII harfleri katladığı için Türkçede iki tür hata üretir: eşit sayılması gerekenleri ayırır ve farklı olanları birleştirir. SSS sayfasının 18. sorusu da bu konuyu ele alır ve Unicode duyarlı karşılaştırma için uygulamanın yerleşik NOCASE kuralını ve like(), upper(), lower() fonksiyonlarını kendi sürümleriyle değiştirebileceğini, kaynak kodda bu işi yapan bir ICU eklentisi bulunduğunu anlatır.
SELECT 'ABC' = 'abc' COLLATE NOCASE,
       'Ş' = 'ş' COLLATE NOCASE,
       'İ' = 'i' COLLATE NOCASE,
       'I' = 'ı' COLLATE NOCASE,
       'I' = 'i' COLLATE NOCASE;
-- çıktı: 1|0|0|0|1| Karşılaştırma | NOCASE sonucu | Türkçede beklenen |
|---|---|---|
| ABC ile abc | Eşit | Eşit |
| Ş ile ş | Farklı | Eşit |
| İ ile i | Farklı | Eşit |
| I ile ı | Farklı | Eşit |
| I ile i | Eşit | Farklı |
Bu sonuçların en çok can yaktığı yer benzersizlik kısıtlarıdır: NOCASE ile tanımlı bir kullanıcı adı sütunu "ŞULE" ile "şule" kayıtlarını iki ayrı kullanıcı olarak kabul eder. E-posta adresleri gibi pratikte ASCII olan alanlarda ise NOCASE sorunsuz ve kullanışlıdır.
Sütun kuralı UNIQUE, GROUP BY ve DISTINCT'i de etkiler
Bir sütuna atanan kural yalnızca WHERE karşılaştırmalarını değil, o sütun üzerindeki tüm metin karşılaştırmalarını belirler. UNIQUE kısıtı yinelenen değeri sütunun kuralına göre arar, bu yüzden NOCASE bir e-posta sütununa aynı adresi farklı harf büyüklüğüyle eklemek reddedilir.
CREATE TABLE uye(
  id     INTEGER PRIMARY KEY,
  eposta TEXT COLLATE NOCASE UNIQUE,
  takma  TEXT
);
INSERT INTO uye(eposta, takma) VALUES ('Ali@Ornek.com', 'ali');
INSERT INTO uye(eposta, takma) VALUES ('ali@ornek.com', 'ali2');
-- hata: UNIQUE constraint failed: uye.eposta

SELECT id FROM uye WHERE eposta = 'ALI@ORNEK.COM';
-- çıktı: 1
Gruplama ve tekilleştirme de aynı mantıkla çalışır. Belgedeki örnekte NOCASE bir sütun üzerinde GROUP BY "abc", "ABC" ve "Abc" değerlerini tek grupta toplar; ifadeyi (d || '') biçiminde bir hesaplamaya dönüştürmek ise sütun kuralını düşürür ve BINARY gruplamaya döner. İfadeye doğrudan COLLATE eklemek de mümkündür:
CREATE TABLE sehir(ad TEXT);
INSERT INTO sehir VALUES ('izmir'), ('IZMIR'), ('İzmir'), ('ızmır');

SELECT count(DISTINCT ad), count(DISTINCT ad COLLATE NOCASE) FROM sehir;
-- çıktı: 4|3

SELECT min(ad), count(*) FROM sehir GROUP BY ad COLLATE NOCASE;
-- çıktı:
-- IZMIR|2
-- İzmir|1
-- ızmır|1
Dört yazımdan "izmir" ve "IZMIR" NOCASE için aynıdır ve tek grupta birleşti. "İzmir" ve "ızmır" ise ASCII dışındaki harfleri nedeniyle ayrı gruplar olarak kaldı. Türkçe bir okur için dördü de aynı şehirdir; yerleşik kurallarla bu sonuca ulaşılamaz.
Hangi kural kullanılır? Öncelik sırası
Bir karşılaştırma işlecinde (=, <, >, <=, >=, !=, IS, IS NOT) iki işlenen farklı kurallara sahip olabilir. Belge şu sırayı tanımlar:
- İşlenenlerden birinde sonek
COLLATEişleci varsa o kural kullanılır; ikisinde de varsa soldakinin kuralı geçerlidir. İfadenin içinde herhangi bir yerdeCOLLATEgeçmesi yeterlidir; birden fazla varsa en soldaki kazanır. - Açık kural yoksa ve işlenenlerden biri sütunsa, o sütunun kuralı kullanılır; ikisi de sütunsa soldaki önceliklidir. Önüne tekli
+veyaCASTkonmuş bir sütun adı yine sütun sayılır. - Bunların hiçbiri yoksa BINARY kullanılır.
-- Kural 1: açık COLLATE işleci her şeyin önüne geçer
SELECT count(*) FROM uye WHERE eposta = 'ALI@ORNEK.COM' COLLATE BINARY;
-- çıktı: 0

-- Kural 2: sütun hangi taraftaysa onun kuralı kullanılır
SELECT count(*) FROM uye WHERE 'ALI@ORNEK.COM' = eposta;
-- çıktı: 1

-- takma sütunu BINARY olduğu için harf büyüklüğü önemlidir
SELECT count(*) FROM uye WHERE takma = 'ALI';
-- çıktı: 0

-- IN için COLLATE soldaki işlenene yazılır
SELECT count(*) FROM uye WHERE takma COLLATE NOCASE IN ('ALI', 'VELİ');
-- çıktı: 1
x BETWEEN y AND z iki ayrı karşılaştırma gibi değerlendirilir. x IN (SELECT y ...) ifadesi x = y gibi ele alınır. Değer listesi içeren x IN (y, z) biçiminde ise x'in kuralı geçerlidir; belge açık bir kural gerekiyorsa bunun soldaki işlenene yazılmasını önerir. Çok argümanlı max(), min() ve nullif() fonksiyonları da argümanlarını soldan sağa tarar ve kural tanımlayan ilk argümanın kuralını kullanır.
İndeksler ve sıralama kuralı
CREATE INDEX içinde her sütunun veya ifadenin ardından COLLATE yazabilirsiniz; yazmazsanız tablodaki sütun kuralı, o da yoksa BINARY kullanılır. Bir indeks yalnızca kendi kuralıyla yapılan karşılaştırmalarda ve sıralamalarda işe yarar. BINARY indeksli bir sütunu COLLATE NOCASE ile ararsanız indeks kullanılamaz.
CREATE TABLE kitap(id INTEGER PRIMARY KEY, baslik TEXT);
CREATE INDEX kitap_baslik ON kitap(baslik);

EXPLAIN QUERY PLAN SELECT id FROM kitap WHERE baslik = 'Kuyucaklı Yusuf';
-- plan: SEARCH kitap USING COVERING INDEX kitap_baslik (baslik=?)

EXPLAIN QUERY PLAN SELECT id FROM kitap WHERE baslik = 'Kuyucaklı Yusuf' COLLATE NOCASE;
-- plan: SCAN kitap

CREATE INDEX kitap_baslik_nc ON kitap(baslik COLLATE NOCASE);
EXPLAIN QUERY PLAN SELECT id FROM kitap WHERE baslik = 'Kuyucaklı Yusuf' COLLATE NOCASE;
-- plan: SEARCH kitap USING COVERING INDEX kitap_baslik_nc (baslik=?)

EXPLAIN QUERY PLAN SELECT id FROM kitap ORDER BY baslik COLLATE NOCASE;
-- plan: SCAN kitap USING COVERING INDEX kitap_baslik_nc
İlk sorgu BINARY indeksle doğrudan aradı. Aynı sorguya COLLATE NOCASE eklediğimizde plan tablo taramasına döndü. NOCASE kurallı ikinci bir indeks eklenince hem eşitlik araması hem de NOCASE sıralaması bu indeksten karşılandı; sıralama için ayrıca geçici bir B-ağacı gerekmedi. Aynı ilişki LIKE için de geçerlidir: varsayılan modda LIKE önek araması yalnızca NOCASE indeksle hızlanır. Ayrıntılar LIKE, GLOB ve REGEXP yazısında, indeks tasarımının geneli ise index oluşturma yazısında.
Tanımlı kuralları görmek ve ek kurallar
PRAGMA collation_list bağlantıda tanımlı sıralama kurallarını listeler. Standart kütüphanede yalnızca üç yerleşik kural görünür. Tanımlı olmayan bir kural adı kullanmak hata verir; uygulamalar ek kuralları C arayüzündeki sqlite3_create_collation() ile kaydeder.
PRAGMA collation_list;
-- çıktı:
-- 0|RTRIM
-- 1|NOCASE
-- 2|BINARY

SELECT 'x' = 'X' COLLATE TURKCE;
-- hata: no such collation sequence: TURKCE
sqlite3 komut satırı aracı bazı ek kurallarla gelir. Belgeye göre araçta, metnin içine gömülü işaretsiz tamsayıları değerlerine göre sıralayan UINT kuralı bulunur; kayan nokta belgesi de ondalık eklentisinin ondalık metinleri sayısal sırayla karşılaştıran decimal kuralını sağladığını anlatır. Bu kurallar kütüphanenin parçası değildir; uygulamanızda ayrıca yüklemediğiniz sürece kullanılamazlar.
CREATE TABLE dosya(ad TEXT);
INSERT INTO dosya VALUES ('rapor10.pdf'), ('rapor2.pdf'), ('rapor1.pdf');

SELECT group_concat(ad, ', ') FROM (SELECT ad FROM dosya ORDER BY ad);
-- çıktı: rapor1.pdf, rapor10.pdf, rapor2.pdf

SELECT group_concat(ad, ', ') FROM (SELECT ad FROM dosya ORDER BY ad COLLATE uint);
-- çıktı: rapor1.pdf, rapor2.pdf, rapor10.pdfUygulamalı örnek: Türkçe duyarlı arama sütunu
Standart derlemede Türkçe harf katlaması yapan bir kural olmadığına göre, eşitlik aramasını doğru yapmanın taşınabilir bir yolu, metnin katlanmış hâlini ayrı bir sütunda tutmaktır. Aşağıdaki örnekte hesaplanan bir sütun önce Türkçe büyük harfleri replace() ile küçük karşılıklarına çeviriyor, ardından kalan ASCII harfleri lower() ile küçültüyor. Sıra önemlidir: I ve İ dönüşümleri lower() çağrısından önce yapılmalıdır, aksi hâlde lower() I harfini i harfine çevirir.
CREATE TABLE musteri(
  id  INTEGER PRIMARY KEY,
  ad  TEXT,
  ad_arama TEXT GENERATED ALWAYS AS (
    lower(replace(replace(replace(replace(replace(replace(replace(
      ad, 'I', 'ı'), 'İ', 'i'), 'Ç', 'ç'), 'Ğ', 'ğ'), 'Ö', 'ö'), 'Ş', 'ş'), 'Ü', 'ü'))
  ) VIRTUAL
);
CREATE INDEX musteri_ad_arama ON musteri(ad_arama);
INSERT INTO musteri(ad) VALUES
  ('IŞIL ÖZTÜRK'), ('ışıl öztürk'), ('İlker Çelik'), ('ilker çelik'), ('Irmak Ünal');

SELECT ad, ad_arama FROM musteri;
-- çıktı:
-- IŞIL ÖZTÜRK|ışıl öztürk
-- ışıl öztürk|ışıl öztürk
-- İlker Çelik|ilker çelik
-- ilker çelik|ilker çelik
-- Irmak Ünal|ırmak ünal

SELECT id, ad FROM musteri WHERE ad_arama = 'ışıl öztürk';
-- çıktı:
-- 1|IŞIL ÖZTÜRK
-- 2|ışıl öztürk

SELECT id, ad FROM musteri WHERE ad = 'ışıl öztürk' COLLATE NOCASE;
-- çıktı: 2|ışıl öztürk
Arama sütunu üzerinde yapılan eşitlik sorgusu iki yazımı da buldu ve sütun indekslendiği için hızlıdır. Aynı sorgu NOCASE ile yalnızca birebir aynı yazılmış kaydı döndürdü. Hesaplanan sütunlar ve indekslenmeleri generated columns yazısında ayrıntılı anlatılıyor. Bu yöntemin sınırını da belirtelim: eşitlik ve arama sorunu çözülür, ama alfabetik sıralama hâlâ bayt değerlerine göre yapılır, yani ç, ğ, ı, ö, ş ve ü harfleri z harfinden sonra gelir. Gerçek Türkçe alfabe sırası için uygulamanın tanımladığı bir sıralama kuralı veya ICU gibi bir eklenti gerekir.
Sık yapılan hatalar
- NOCASE'i Unicode duyarlı sanmak: yalnızca 26 ASCII harf katlanır; Türkçede I ve i harflerini yanlışlıkla eşler.
- Sorgudaki COLLATE ile indeks kuralını uyumsuz bırakmak: indeks yalnızca kendi kuralıyla kullanılır.
- Sütun kuralını hesaplamayla kaybetmek:
sütun || ''gibi bir ifade artık sütun değildir ve BINARY kullanır; GROUP BY ve ORDER BY sonuçları değişebilir. - IN listesinde kuralı sağa yazmak: belge, açık kuralın soldaki işlenene yazılmasını önerir.
- Komut satırına özgü kuralları şemaya koymak: şema başka ortamda açılamaz hâle gelir.
- Sondaki boşlukları beklemeden saklamak: RTRIM kullanmıyorsanız "abc" ile "abc " farklıdır; veriyi kayıt sırasında
trim()ile temizlemek daha öngörülebilir bir yoldur.
Sık Sorulan Sorular
SQLite'ta büyük-küçük harf duyarsız benzersiz sütun nasıl tanımlanır?
Sütunu TEXT COLLATE NOCASE UNIQUE olarak tanımlayın. Benzersizlik NOCASE kuralına göre denetlenir. Değerler ASCII dışı harfler içeriyorsa bu kısıt Türkçe büyük-küçük farklarını yakalamaz; o durumda normalize edilmiş bir sütun üzerinde UNIQUE kısıtı kurun. Kısıtların genel kullanımı için CREATE TABLE ve kısıtlamalar yazısına bakın.
Mevcut bir sütunun sıralama kuralını değiştirebilir miyim?
ALTER TABLE bir sütunun kuralını değiştiren bir biçim sunmaz. Sütun kuralını değiştirmek için tabloyu yeni tanımla oluşturup veriyi taşımanız gerekir; bu işlemin güvenli adımları ALTER TABLE yazısında anlatılıyor. Çoğu durumda yeni bir indeks ve sorgu düzeyinde COLLATE yeterlidir.
COLLATE NOCASE ile LIKE arasında fark var mı?
İkisi de ASCII harflerde büyük-küçük farkını yok sayar, ama = ile NOCASE tam eşitlik arar, LIKE ise joker karakterlerle desen eşleştirir. Türkçe harflerdeki sınırlar ikisinde de aynıdır.
Türkçe alfabe sırasıyla sıralama yapmak mümkün mü?
Yerleşik kurallarla mümkün değildir. Uygulamanın kendi karşılaştırma fonksiyonunu bir sıralama kuralı olarak kaydetmesi veya ICU eklentisi gibi Unicode farkındalığı olan bir çözüm kullanması gerekir. Bu tür kuralları kullanan şemalar, kuralın kayıtlı olmadığı ortamlarda açılırken sorun çıkarabilir.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: SQLite öğrenme rehberi · LIKE, GLOB ve REGEXP · Metin fonksiyonları · Index oluşturma · Hesaplanan sütunlar · Veri tipleri ve affinity