SQLite'ta ANALYZE komutu tablolardaki ve indekslerdeki veri dağılımı hakkında istatistik toplar, bunları sqlite_stat1 adlı iç tabloya yazar ve sorgu planlayıcı bir sorgunun hangi indeksle, hangi birleştirme sırasıyla çalıştırılacağına karar verirken bu bilgiyi kullanır. Belgelerin bugünkü önerisi ANALYZE komutunu elle çalıştırmak yerine bağlantı kapanırken PRAGMA optimize çağırmaktır; bu komut yalnızca gerektiğinde ve süre sınırıyla analiz yapar.
Bu yazıda planlayıcının bir indeksi hangi koşullarda kullanabildiğini, istatistik yokken neyi varsaydığını, sqlite_stat1 satırlarının nasıl okunduğunu ve istatistiklerin bir planı nasıl değiştirdiğini çalıştırılmış örneklerle gösteriyoruz. Sonra planları sabitlemek isteyenler için belgelerdeki yöntemi ve son çare olarak sunulan elle yönlendirme tekniklerini (unary +, CROSS JOIN, INDEXED BY) ele alıyoruz. Planın kendisini okumayı bilmiyorsanız önce EXPLAIN QUERY PLAN yazısına göz atın.
Sorgu planlayıcı neye karar verir?
Tek bir SQL ifadesi için onlarca, bazen binlerce farklı çalıştırma yolu vardır. Planlayıcının işi, disk okumasını ve işlemci yükünü en aza indireceğini tahmin ettiği yolu seçmektir. Bunun için birkaç soruya cevap arar: her tablo için hangi indeks kullanılacak, birleştirmelerde hangi tablo dış döngüde olacak, sıralama bir indeksle mi yoksa geçici bir yapıyla mı yapılacak. Belgelere göre FROM içindeki her tablo, OR optimizasyonu dışında en fazla bir indeks kullanabilir; birden fazla aday indeks varsa planlayıcı her seçeneğin toplam iş yükünü tahmin eder ve en ucuzunu seçer.
Planlayıcı önce JOIN koşullarını WHERE yan tümcesine taşır ve WHERE ifadesini AND ile ayrılmış terimlere böler. Bir terimin indeksle karşılanabilmesi için genellikle sutun = ifade, sutun > ifade, sutun IN (...), sutun IS NULL, sutun LIKE kalip gibi biçimlerden birinde olması gerekir. Çok sütunlu bir indekste ise kural katıdır: indeksin en soldaki sütunları eşitlik, IN veya IS ile kısıtlanmalı, sütunlar arasında boşluk olmamalı ve aralık koşulu yalnızca kullanılan en sağdaki sütunda bulunabilir. Örneğin (a, b, c, d) indeksi için a=5 AND b IN (1,2) AND c > 12 AND d='x' koşulunda yalnızca ilk üç sütun aramaya katılır; c hiç kısıtlanmasaydı yalnızca a ve b kullanılırdı.
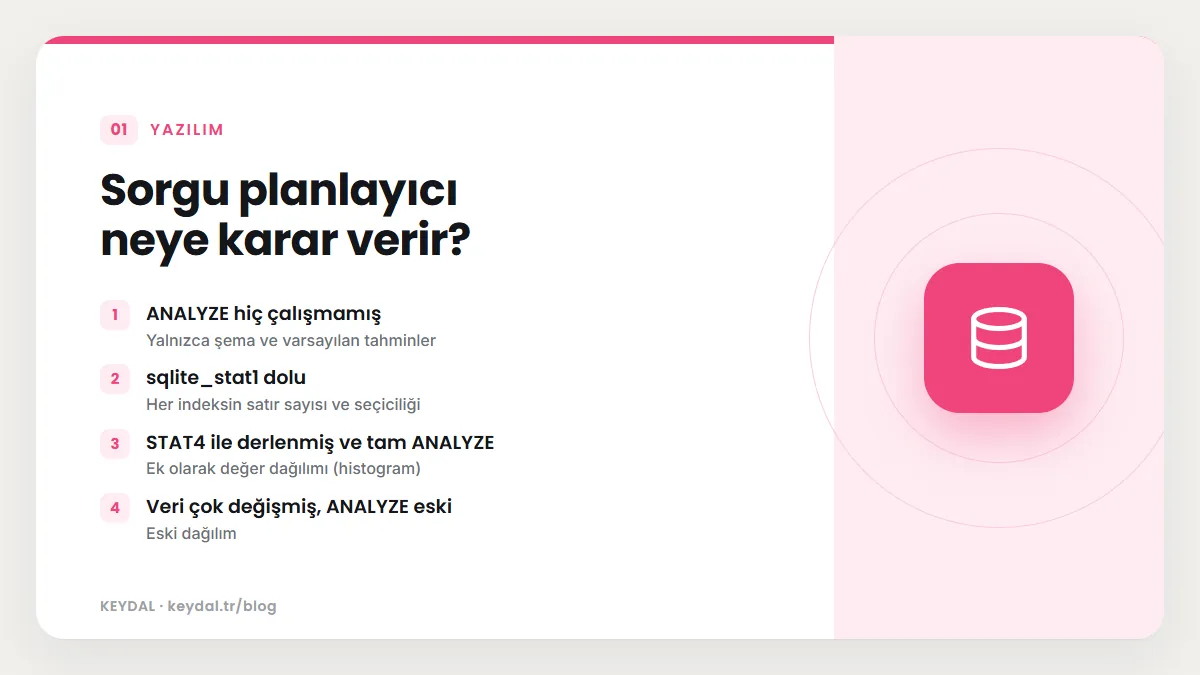
| Durum | Planlayıcının bildiği | Sonuç |
|---|---|---|
| ANALYZE hiç çalışmamış | Yalnızca şema ve varsayılan tahminler | Makul ama veriye kör seçimler |
| sqlite_stat1 dolu | Her indeksin satır sayısı ve seçiciliği | Daha isabetli indeks ve sıra seçimi |
| STAT4 ile derlenmiş ve tam ANALYZE | Ek olarak değer dağılımı (histogram) | Aralık sorgularında daha iyi tahmin |
| Veri çok değişmiş, ANALYZE eski | Eski dağılım | Bazı planlar artık uygun olmayabilir |
İstatistik yokken ne varsayılır?
ANALYZE çalıştırılmamış bir veritabanında planlayıcı verinin şeklini tahmin etmek zorundadır. Belgeler bu tahminlere dair iki somut örnek verir. Birincisi, bir indeksin en soldaki sütununda her değer için ortalama on tekrar olduğu varsayılır. İkincisi, birleştirmelerde geçici (otomatik) indeks kurmanın maliyetini hesaplarken tablonun yaklaşık bir milyon satır içerdiği tahmin edilir. Gerçek veri bu varsayımlardan çok farklıysa, özellikle de yalnızca birkaç farklı değer alan sütunlar indeksin başındaysa, seçilen plan ideal olmayabilir.
Aşağıdaki tabloda rol sütunu yalnızca iki değer alıyor: kişilerin onda biri öğretmen, geri kalanı öğrenci. Boy sütununa göre filtrelenen bir sorgu düşünün. İndeksin ilk sütunu WHERE içinde geçmediği için, istatistik yokken SQLite bu indeksi arama için kullanamaz; yalnızca tablodan küçük olduğu için baştan sona tarar:
CREATE TABLE kisi(id INTEGER PRIMARY KEY, rol TEXT NOT NULL, boy INTEGER NOT NULL, sehir TEXT);
CREATE INDEX kisi_rol_boy ON kisi(rol, boy);
CREATE INDEX kisi_sehir ON kisi(sehir);

-- 10.000 satırlık deneme verisi: rol yalnızca iki değer alıyor
WITH RECURSIVE n(i) AS (SELECT 1 UNION ALL SELECT i + 1 FROM n WHERE i < 10000)
INSERT INTO kisi(rol, boy, sehir)
SELECT CASE WHEN i % 10 = 0 THEN 'ogretmen' ELSE 'ogrenci' END,
       150 + (i % 50),
       CASE i % 4 WHEN 0 THEN 'Ankara' WHEN 1 THEN 'İzmir' WHEN 2 THEN 'Bursa' ELSE 'Konya' END
  FROM n;

EXPLAIN QUERY PLAN SELECT id FROM kisi WHERE boy >= 195;
-- çıktı:
-- QUERY PLAN
-- `--SCAN kisi USING COVERING INDEX kisi_rol_boy
ANALYZE planı nasıl değiştirir: skip-scan örneği
Şimdi önce PRAGMA optimize komutunun hata ayıklama kipini çalıştıralım. -1 maskesi hiçbir şey yapmadan, yapılacak işlemleri birer satır olarak listeler. Ardından istatistikleri toplayıp aynı sorguya yeniden bakalım:
PRAGMA optimize(-1);
-- çıktı: ANALYZE "main"."kisi"

ANALYZE;
SELECT tbl, idx, stat FROM sqlite_stat1 ORDER BY idx;
-- çıktı:
-- kisi|kisi_rol_boy|10000 5000 200
-- kisi|kisi_sehir|10000 2500

EXPLAIN QUERY PLAN SELECT id FROM kisi WHERE boy >= 195;
-- çıktı:
-- QUERY PLAN
-- `--SEARCH kisi USING COVERING INDEX kisi_rol_boy (ANY(rol) AND boy>?)
İstatistik toplandıktan sonra plan SEARCH hâline geldi ve parantez içinde ANY(rol) göründü. Bu, belgelerin skip-scan dediği yöntemdir: SQLite indeksin ilk sütunundaki her farklı değer için ayrı bir arama yapar, yani sorguyu kavramsal olarak "her rol için boy >= 195 olanları bul" biçiminde çalıştırır. Belgeler, ilk sütunda değer başına yaklaşık 18 veya daha fazla tekrar olduğunda bu yöntemin tam taramadan hızlı hâle geldiğini, varsayılan tahmin 10 olduğu için de analiz edilmemiş bir veritabanında skip-scan'in hiç kullanılmadığını belirtir. Bizim verimizde değer başına 5.000 satır olduğunu istatistikler söyleyince planlayıcı yöntemi seçebildi.
sqlite_stat1 satırlarını okumak
sqlite_stat1 tablosunun üç sütunu vardır: tbl tablo adını, idx indeks adını, stat ise boşlukla ayrılmış tamsayılardan oluşan bir metni tutar. Dosya biçimi belgesine göre ilk sayı indeksteki yaklaşık satır sayısıdır. İkinci sayı, indeksin ilk sütununda aynı değeri paylaşan ortalama satır sayısı; üçüncü sayı ilk iki sütunda aynı değeri paylaşanların ortalamasıdır ve böyle devam eder. K sütunlu bir indeks için K+1 sayı bulunur; indeks benzersizse son sayı 1 olur.
Yukarıdaki çıktıyı bu kurala göre okuyalım. 10000 5000 200: indekste 10.000 satır var, her rol değeri ortalama 5.000 satırla eşleşiyor (çok düşük seçicilik), her (rol, boy) ikilisi ise ortalama 200 satırla. 10000 2500: her şehir ortalama 2.500 satırı karşılıyor. Sayıların sonunda unordered, noskipscan veya sz=NNN gibi ek belirteçler de bulunabilir; örneğin noskipscan o indeksin skip-scan ile kullanılmasını engeller. idx sütunu NULL olan bir satır varsa, stat o tablonun yaklaşık satır sayısını tek bir tamsayı olarak tutar.
SQLite SQLITE_ENABLE_STAT4 seçeneğiyle derlenmişse ANALYZE ayrıca sqlite_stat4 tablosuna sütun değerlerinin dağılımını (histogram) yazar. Bu veri, örneğin iki farklı aralık koşulu arasında hangisinin daha seçici olduğunu tahmin etmeye yarar; ancak belgelere göre yalnızca koşulun sağ tarafı sabit veya parametre olduğunda işe yarar. Eski sqlite_stat2 ve sqlite_stat3 tabloları güncel sürümlerde yok sayılır.
ANALYZE komutunun biçimleri
Komut argümansız verildiğinde ana veritabanı ve ekli bütün veritabanları analiz edilir. Bir şema adı, tablo adı veya indeks adı vererek kapsamı daraltabilirsiniz:
ANALYZE;                 -- ana veritabanı ve bütün ekli veritabanları
ANALYZE main;            -- yalnızca bir şema
ANALYZE kisi;            -- bir tablo ve onun indeksleri
ANALYZE kisi_sehir;      -- yalnızca bir indeks
ANALYZE sqlite_schema;   -- istatistik tablolarını belleğe yeniden yükler
Üç noktaya dikkat edin. Birincisi, istatistikler veri değiştikçe kendiliğinden güncellenmez; tablolar çok büyüdüğünde veya şema değiştiğinde yeniden analiz gerekir. İkincisi, planlayıcı istatistikleri şema okunurken belleğe alır; istatistik tablosunu elle değiştirirseniz SQLite bunu hemen fark etmez, ANALYZE sqlite_schema ile yeniden yüklemeyi zorlarsınız. Üçüncüsü, belgeler istatistik tablolarının SELECT ile okunabildiğini, DELETE, INSERT ve UPDATE ile değiştirilebildiğini, ancak geçersiz içeriğin kötü planlara yol açabileceğini ve normalde ANALYZE dışında bir yolla değiştirilmemesi gerektiğini vurgular.
Önerilen yol: PRAGMA optimize
Belgeler ANALYZE'ın hiçbir zaman zorunlu olmadığını, ama karmaşık sorgular çalıştıran uygulamalarda planlayıcının daha iyi seçim yapmasına yardım ettiğini söyler ve iki kullanım deseni önerir. Kısa ömürlü bağlantılar kullanan uygulamalar her bağlantıyı kapatmadan hemen önce bir kez PRAGMA optimize; çalıştırmalıdır. Uzun ömürlü bağlantılar bağlantı açılırken PRAGMA optimize=0x10002;, sonra belirli aralıklarla, örneğin günde bir kez, PRAGMA optimize; çalıştırmalıdır. Her uygulama, özellikle CREATE INDEX gibi şema değişikliklerinden sonra da bu komutu çağırmalıdır.
PRAGMA optimize çoğu zaman hiçbir şey yapmaz ve çok hızlıdır. Bağlantı, ömrü boyunca planlayıcının hangi tablolarda istatistiğe ihtiyaç duyduğunu kaydeder; komut bu kayıtlara bakarak yalnızca yararlı görünen tablolarda ANALYZE çalıştırır. Belgelerdeki güncel kurallara göre bir tablonun analiz edilmesi için sıradan bir tablo olması, adının sqlite_ ile başlamaması ve indekslerinden biri için istatistik bulunmaması ya da satır sayısının son analizden bu yana on kat artmış veya azalmış olması gerekir. 3.46.0 sürüm notlarına göre bu sürümden itibaren komut, büyük veritabanlarında da çabuk bitmesi için kendi geçici analiz sınırını otomatik olarak koyar.
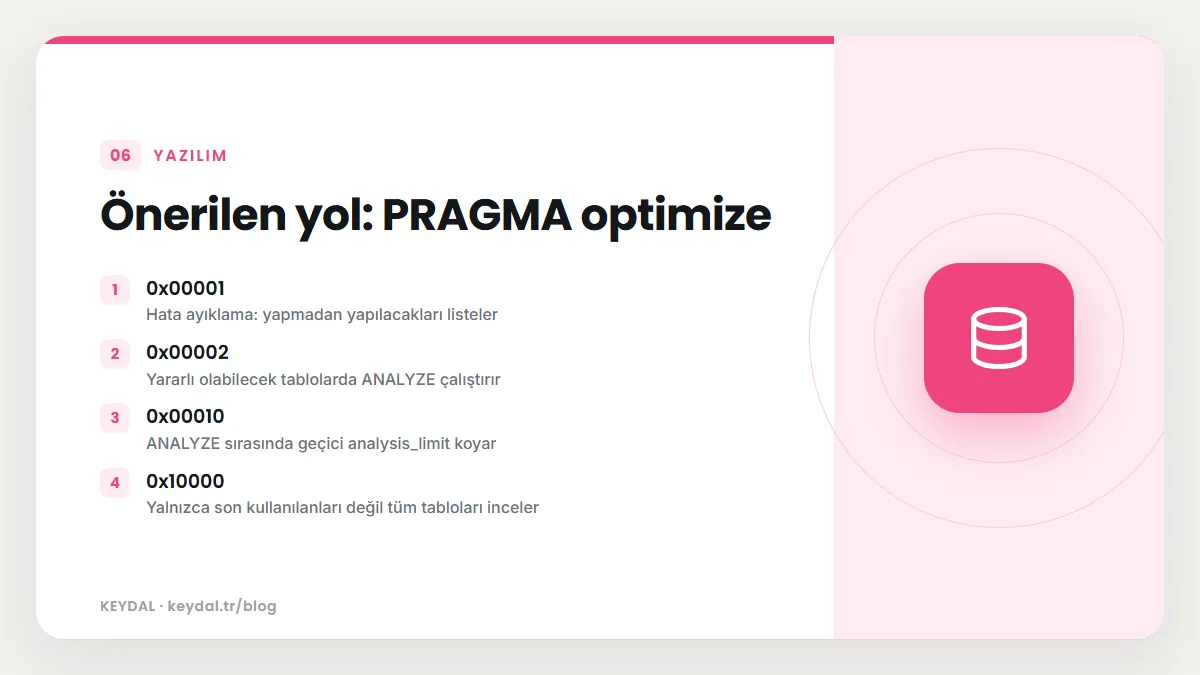
| Maske biti | Anlamı | Varsayılan |
|---|---|---|
| 0x00001 | Hata ayıklama: yapmadan yapılacakları listeler | Kapalı |
| 0x00002 | Yararlı olabilecek tablolarda ANALYZE çalıştırır | Açık |
| 0x00010 | ANALYZE sırasında geçici analysis_limit koyar | Açık |
| 0x10000 | Yalnızca son kullanılanları değil tüm tabloları inceler | Kapalı |
Varsayılan maske 0xfffe değeridir. Yeni açılmış bir bağlantının henüz sorgu geçmişi olmadığı için açılışta 0x10000 bitinin eklenmesi önerilir; 0x10002 değeri bu yüzden "bütün tabloları incele ve gerekiyorsa analiz et" anlamına gelir. Belgeler kuralların ileride değişebileceğini ve yeni maske değerlerinin eklenebileceğini de not eder.
Büyük veritabanında yaklaşık ANALYZE: analysis_limit
Varsayılan olarak ANALYZE her indeksi baştan sona tarar ve bu büyük dosyalarda yavaş olabilir. 3.32.0 sürümünden beri PRAGMA analysis_limit ile her indekste incelenecek satır sayısına yaklaşık bir üst sınır koyabilirsiniz. Belgeler 100 ile 1000 arasındaki değerleri önerir; 0 sınırı kaldırır ve geriye uyumluluk için varsayılandır.
PRAGMA analysis_limit;
-- çıktı: 0
PRAGMA analysis_limit = 400;
-- çıktı: 400
ANALYZE;
Sınırlı analizin sonuçları tam taramadakiyle birebir aynı olmaz ama belgelere göre çoğu durumda yeterince yakındır; yaklaşık bir ANALYZE, hiç ANALYZE yapmamaktan iyidir. Bir sınırlama: sqlite_stat4 içeriği yalnızca tam taramayla hesaplanabildiği için sınır sıfırdan farklıyken bu tablo üretilmez. PRAGMA optimize kullanıyorsanız sınırı ayrıca ayarlamanıza gerek yoktur.
Planları sabitlemek: istatistikleri dondurmak
Bazı ekipler, uygulama yayına çıktıktan sonra her kurulumda geliştirme sırasında test edilen planların seçilmesini ister; böylece sahadan gelen performans şikâyetleri laboratuvarda yeniden üretilebilir. Belgeler bunun için şu yolu tarif eder: uygulamada ne tam ANALYZE ne de PRAGMA optimize çalıştırın; canlı veriye benzer bir test veritabanında bir kez ANALYZE yapın ve sonucu aşağıdaki sorguyla bir SQL betiğine dönüştürün:
.mode list
SELECT
  'ANALYZE sqlite_schema;' ||
  'DELETE FROM sqlite_stat1;' ||
  'INSERT INTO sqlite_stat1(tbl,idx,stat)VALUES' ||
  (SELECT group_concat(format('(%Q,%Q,%Q)',tbl,idx,stat),',')
    FROM sqlite_stat1) ||
  ';ANALYZE sqlite_schema;';
-- çıktı: ANALYZE sqlite_schema;DELETE FROM sqlite_stat1;INSERT INTO sqlite_stat1(tbl,idx,stat)VALUES('kisi','kisi_sehir','10000 2500'),('kisi','kisi_rol_boy','10000 5000 200');ANALYZE sqlite_schema;
Bu çıktıyı uygulamanızda bir sabit olarak saklayıp yeni veritabanı oluşturulurken veya uygulama açılırken çalıştırırsanız sqlite_stat1 her kurulumda aynı içeriğe sahip olur. Gerekirse betiğin başına BEGIN;, sonuna COMMIT; eklenebilir. Belgeler ayrıca, varsayılan olarak kapalı olan ve derleme seçeneği veya C arayüzüyle açılan bir sorgu planlayıcı kararlılık garantisinden (QPSG) söz eder: açık olduğunda şema önemli ölçüde değişmedikçe, ANALYZE yeniden çalıştırılmadıkça ve aynı SQLite sürümü kullanıldıkça aynı ifade için hep aynı plan seçilir. SQLite sürümünü değiştirmenin planları değiştirebileceğini unutmayın.
Son çare: planı elle yönlendirmek
Belgeler planlayıcının kötü plan seçtiği durumların nadir olduğunu, sorunların çoğunun eksik indekslerden kaynaklandığını ve aşağıdaki tekniklerin yalnızca başka çare kalmadığında kullanılması gerektiğini açıkça söyler; 2024 tarihli bir notta, planlayıcının artık bu hilelere neredeyse hiç ihtiyaç bırakmadığı ve kötü bir plan görürseniz bunu SQLite forumuna bildirmeniz istenir. Yine de mevcut kodda karşılaşabileceğiniz için nasıl çalıştıklarını bilmek gerekir:
CREATE TABLE kisi(id INTEGER PRIMARY KEY, rol TEXT NOT NULL, boy INTEGER NOT NULL, sehir TEXT);
CREATE INDEX kisi_rol_boy ON kisi(rol, boy);
CREATE INDEX kisi_sehir ON kisi(sehir);

EXPLAIN QUERY PLAN SELECT id FROM kisi WHERE rol = 'ogretmen' AND sehir = 'Bursa';
-- çıktı:
-- QUERY PLAN
-- `--SEARCH kisi USING INDEX kisi_sehir (sehir=?)

EXPLAIN QUERY PLAN SELECT id FROM kisi WHERE rol = 'ogretmen' AND +sehir = 'Bursa';
-- çıktı:
-- QUERY PLAN
-- `--SEARCH kisi USING INDEX kisi_rol_boy (rol=?)

EXPLAIN QUERY PLAN SELECT * FROM kisi NOT INDEXED WHERE sehir = 'Bursa';
-- çıktı:
-- QUERY PLAN
-- `--SCAN kisi

DROP INDEX kisi_sehir;
SELECT * FROM kisi INDEXED BY kisi_sehir WHERE sehir = 'Bursa';
-- hata: no such index: kisi_sehir
Unary + işleci bir değer üzerinde hiçbir şey yapmaz ama önüne konduğu terimin indeks kısıtı olarak kullanılmasını engeller; burada planlayıcıyı şehir indeksinden uzaklaştırıp rol indeksine yöneltti. Belgeler önemli bir tuzağı da hatırlatır: + ifadenin tip eğilimini (affinity) de kaldırır, bu yüzden TEXT eğilimli bir sütunu sayıyla karşılaştırırken sonucu değiştirebilir. Tip eğilimi için veri tipleri yazısına bakın.
INDEXED BY bir ipucu değil, zorunluluktur: belirtilen indeks yoksa veya sorgu için kullanılamıyorsa ifade hazırlanırken hata verir. Belgeler bu ifadenin performans ayarı için değil, bir şema değişikliği kritik bir sorgunun planını bozduğunda testlerde hata alabilmek için tasarlandığını söyler. NOT INDEXED ise PRIMARY KEY ve UNIQUE kısıtlarının örtük indeksleri dahil hiçbir indeksin kullanılmamasını ister; rowid ile erişim yine mümkündür. Birleştirme sırasını sabitlemek için ise CROSS JOIN kullanılır: SQLite bu işlecin iki tarafının yerini hiçbir zaman değiştirmez, soldaki tablo her zaman dış döngüde kalır. Normal JOIN, INNER JOIN veya virgülle yazılan birleştirmelerde ise planlayıcı sırayı serbestçe değiştirebilir. Belgeler ayrıca WHERE terimlerinin doğru olma olasılığı hakkında ipucu veren likely(), unlikely() ve likelihood() fonksiyonlarından da aynı son çare listesinde söz eder.
Otomatik (sorgu süreli) indeksler
Kullanılabilir hiçbir indeks yoksa SQLite yalnızca o ifadenin süresi boyunca yaşayan geçici bir indeks kurabilir. Belgeler bunu bir karma birleştirmenin (hash join) B-ağacıyla yapılan karşılığı olarak tarif eder. Kurma maliyeti tam taramadan yüksek olduğu için, ancak arama sayısının bu maliyeti karşılayacağı tahmin edildiğinde seçilir:
CREATE TABLE t1(a, b);
CREATE TABLE t2(c, d);

EXPLAIN QUERY PLAN SELECT * FROM t1, t2 WHERE a = c;
-- çıktı:
-- QUERY PLAN
-- |--SCAN t1
-- |--BLOOM FILTER ON t2 (c=?)
-- `--SEARCH t2 USING AUTOMATIC COVERING INDEX (c=?)

EXPLAIN QUERY PLAN SELECT * FROM t2 CROSS JOIN t1 WHERE a = c;
-- çıktı:
-- QUERY PLAN
-- |--SCAN t2
-- |--BLOOM FILTER ON t1 (a=?)
-- `--SEARCH t1 USING AUTOMATIC COVERING INDEX (a=?)

PRAGMA automatic_index = OFF;
EXPLAIN QUERY PLAN SELECT * FROM t1, t2 WHERE a = c;
-- çıktı:
-- QUERY PLAN
-- |--SCAN t1
-- `--SCAN t2
İkinci sorguda CROSS JOIN sırayı tersine çevirdiği için geçici indeks bu kez t1 üzerinde kuruldu. PRAGMA automatic_index bu özelliği bağlantı için kapatır; o zaman iki tablonun iç içe tam taraması kalır. Belgeler, otomatik indeks kullanan her ifadenin hata günlüğüne bir uyarı yazdığını ve geliştiricilerin bu uyarıları kalıcı indeks ihtiyacını belirlemek için kullanması gerektiğini belirtir. Bunları sqlite_autoindex_ ile başlayan adlara sahip iç indekslerle karıştırmayın: onlar PRIMARY KEY ve UNIQUE kısıtlarını uygulamak için kalıcı olarak oluşturulur.
Düşük kaliteli indekslerden kaçının
Planlayıcı kontrol listesinde belgeler düşük kaliteli indeksi, en soldaki sütununda aynı değeri paylaşan 10-20 satırdan fazlası olan indeks olarak tanımlar ve özellikle boolean ya da az sayıda değer alan "enum" benzeri sütunları indeksin başına koymamayı önerir. Böyle bir indeks zorunluysa ANALYZE çalıştırmak şarttır; çünkü planlayıcı indeksin kalitesiz olduğunu ancak sqlite_stat1 içeriğinden öğrenebilir. Yeni bir veritabanında henüz yeterli veri yoksa, tipik bir veritabanından alınmış istatistikleri yukarıdaki yöntemle önceden yüklemek de belgelerin önerdiği seçeneklerden biridir. İndeks tasarımının kendisi için indeks oluşturma ve kısmi indeks yazılarına bakın.
Sık yapılan hatalar
- Boş veya küçük veritabanında ANALYZE: İstatistikler ancak veri temsil edici olduğunda anlamlıdır; birkaç satırlık bir test tablosundan alınan sayılar canlıda yanıltabilir.
- İstatistiklerin kendiliğinden güncellendiğini sanmak: Toplu yükleme veya büyük silme sonrası
PRAGMA optimizeçalıştırın. - INDEXED BY'ı ipucu gibi kullanmak: İndeks silinir veya yeniden adlandırılırsa sorgu çalışmaz.
- Unary + ile tip eğilimini bozmak: TEXT sütunla sayı karşılaştırmasında sonuç sessizce değişebilir.
- sqlite_stat1'i elle düzeltip ANALYZE sqlite_schema çalıştırmamak: Değişiklik yeniden yüklenene kadar planlara yansımaz.
Sık Sorulan Sorular
ANALYZE çalıştırmak zorunlu mu?
Hayır. Belgeler açıkça zorunlu olmadığını söyler; basit sorgularda fark görmeyebilirsiniz. Birçok olası planı olan karmaşık sorgularda ise belirgin iyileşme sağlayabilir.
ANALYZE bir sorguyu yavaşlatabilir mi?
Belgelere göre ANALYZE sonrasında seçilen planlar neredeyse her durumda daha iyidir, ancak bunun her zaman böyle olacağının kanıtı yoktur ve daha yavaş plan üreten yapay durumlar kurulabilir. Planları sabitlemek istiyorsanız istatistik dondurma yöntemini kullanın.
PRAGMA optimize ne sıklıkla çalıştırılmalı?
Kısa ömürlü bağlantılarda her kapanıştan önce bir kez; uzun ömürlü bağlantılarda açılışta 0x10002 maskesiyle, sonra günde bir gibi aralıklarla. Şema değişikliklerinden sonra da çalıştırın.
Hangi sürümden itibaren bu öneriler geçerli?
PRAGMA optimize 3.18.0 sürümünde geldi ve 3.46.0 sürümünde önemli ölçüde geliştirildi; belgelerdeki öneriler bu geliştirmelere dayanır. Daha eski bir kütüphane kullanıyorsanız o sürümün belgesine bakın.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: SQLite öğrenme rehberi · SQLite EXPLAIN QUERY PLAN · SQLite indeks oluşturma · SQLite PRAGMA komutları · SQLite performans ayarları · SQL sorgu optimizasyonu