Ruby'de eşzamanlı iş yürütmenin iki temel aracı vardır. Thread, işletim sisteminin zamanladığı bir iş parçacığıdır: Thread.new { ... } ile başlar, join ile beklenir, value ile sonucu alınır. Fiber ise hafif, işbirlikçi bir yapıdır: kendiliğinden çalışmaz, resume ile başlatılır ve Fiber.yield ile denetimi geri verir. Thread'ler arasında ortak veriyi korumak için Thread::Mutex, veri aktarmak için Thread::Queue kullanılır.
Bu yazıda Thread, Fiber, Mutex ve Queue belgelerindeki temel API'yi, Ruby 4.0.9 ile çalıştırdığımız örneklerle anlatıyoruz. Gerçek çok çekirdekli paralellik için gelen Ractor yapısını Ruby Ractor rehberi yazısında ayrıca ele aldık. Dilin geneli için Ruby öğrenme rehberi sayfasına bakabilirsiniz.
Thread ile GVL notu
Ractor belgeleri bu konuda açıktır: CRuby'de genel kilit (GVL) Ractor başına tutulur ve aynı Ractor içindeki thread'ler bu kilidi paylaştığı için Ruby kodunu birbirleriyle paralel çalıştıramaz. Thread belgesi de beklemeye neden olan işlemleri (okuma, yazma gibi) tanımlarken CRuby'de bunların GVL olmadan yürütülen işlemler olduğunu belirtir. Pratikte bu, thread'lerin özellikle G/Ç beklerken diğer işlerin ilerlemesine izin verdiği anlamına gelir. CPU yoğun Ruby kodunu çekirdeklere yaymak için Ractor tasarlanmıştır.
Thread.new, join ve value
Thread.new blok ister; blok verilmezse ThreadError fırlatılır. Verdiğiniz argümanlar blok parametresi olur. value thread bitene kadar bekler ve bloğun son değerini döndürür. Ana program bittiğinde join edilmemiş thread'ler öldürülür, bu yüzden sonucunu beklediğiniz her thread'i join ya da value ile beklemelisiniz:
t = Thread.new { 2 + 3 }
t.value # => 5

isler = [1, 2, 3].map { |n| Thread.new(n) { |x| x * 10 } }
isler.map(&:value) # => [10, 20, 30]
join bir süre sınırı da alır. Süre dolarsa nil, thread biterse thread nesnesinin kendisi döner. status ise durumu metin olarak verir:
t = Thread.new { sleep 0.5 }
t.join(0.1) # => nil (henüz bitmedi)

t2 = Thread.new { sleep }
sleep 0.1
t2.status  # => "sleep"
t2.kill
t2.join
t2.status  # => false
t2.alive?  # => false
Thread içindeki hatalar
Thread içinde yakalanmayan bir hata o thread'i sonlandırır ve varsayılan olarak diğer thread'lere yayılmaz. Hata saklanır ve başka bir thread join ya da value çağırdığında orada yeniden fırlatılır. report_on_exception açıkken (varsayılan) hata ayrıca standart hata akışına yazılır; aşağıda bunu kapattık:
Thread.report_on_exception = false
t = Thread.new { raise "iş parçacığında hata" }
begin
  t.value
rescue => e
  puts "#{e.class}: #{e.message}"
end
# çıktı: RuntimeError: iş parçacığında hata
Thread.abort_on_exception = true ayarı ise yakalanmayan hatanın ana thread'de hemen yeniden fırlatılmasını sağlar. Ruby 4.0 NEWS dosyasına göre Thread#raise artık Kernel#raise gibi cause: argümanı da alıyor. Hata yönetiminin geneli için Ruby begin, rescue, ensure yazısına bakın.
Mutex#synchronize ile ortak veriyi korumak
Birden fazla thread aynı değişkeni değiştiriyorsa bu işlemleri bir kilitle sıraya sokmanız gerekir. Thread::Mutex#synchronize kilidi alır, bloğu çalıştırır ve blok bittiğinde (hata olsa bile) kilidi bırakır. Mutex adı Thread::Mutex ile aynı sınıfı gösterir:
sayac = 0
kilit = Thread::Mutex.new
isler = 4.times.map do
  Thread.new do
    1000.times { kilit.synchronize { sayac += 1 } }
  end
end
isler.each(&:join)
sayac                       # => 4000
Mutex.equal?(Thread::Mutex) # => true
Aynı thread içinde kilidi ikinci kez almaya çalışmak hata verir; lock ve unlock metotlarını elle kullanıyorsanız buna dikkat edin. Beklemeden denemek için try_lock vardır:
m = Thread::Mutex.new
m.lock
begin
  m.lock
rescue ThreadError => e
  puts "#{e.class}: #{e.message}"
end
# çıktı: ThreadError: deadlock; recursive locking
m.unlock
Thread::Queue ile üretici ve tüketici
Thread::Queue, birden çok üretici ve tüketicinin güvenle kullanabileceği bir ilk giren ilk çıkar (FIFO) kuyruğudur; gerekli kilitlemeyi kendisi yapar. push (takma adları << ve enq) ekler, pop (takma adları shift ve deq) alır. Kuyruk boşsa pop veri gelene kadar bekler. close çağrıldıktan sonra kuyruk boşaldığında pop beklemek yerine nil döndürür; bu da tüketici döngüsünü bitirmenin temiz bir yoludur:
kuyruk = Thread::Queue.new
uretici = Thread.new do
  3.times { |i| kuyruk << "iş #{i}" }
  kuyruk.close
end
tuketici = Thread.new do
  while (is = kuyruk.pop)
    puts "işlendi: #{is}"
  end
end
[uretici, tuketici].each(&:join)
# çıktı: işlendi: iş 0
# çıktı: işlendi: iş 1
# çıktı: işlendi: iş 2
Kapalı bir kuyruğa ekleme yapmak ClosedQueueError verir; bu sınıf StopIteration sınıfından türediği için loop bloklarını da sonlandırabilir. pop(true) beklemeden dener ve kuyruk boşsa ThreadError fırlatır; timeout: verirseniz süre dolduğunda nil döner:
q = Thread::Queue.new
begin
  q.pop(true)
rescue ThreadError => e
  puts "#{e.class}: #{e.message}"
end
# çıktı: ThreadError: queue empty
q.pop(timeout: 0.1) # => nil
Boyutu sınırlı bir kuyruğa ihtiyacınız varsa Thread::SizedQueue sınıfına bakabilirsiniz.
Fiber: duraklatılıp sürdürülebilen kod blokları
Fiber belgesi, fiber'ları thread'e benzeyen ama hiçbir zaman araya girilerek kesilmeyen, zamanlamanın sanal makine yerine programcı tarafından yapıldığı yapılar olarak tanımlar. Her fiber kendi yığınına sahiptir, bu yüzden iç içe metot çağrılarının derininden bile duraklatılabilir. Oluşturulan fiber kendiliğinden çalışmaz; resume çağrısıyla başlar, Fiber.yield ile çağırana döner ve bir sonraki resume ile kaldığı yerden devam eder:
f = Fiber.new do
  puts "fiber başladı"
  Fiber.yield 1
  puts "fiber devam ediyor"
  2
end
f.resume  # çıktı: fiber başladı
          # => 1
f.resume  # çıktı: fiber devam ediyor
          # => 2
f.alive?  # => false

begin
  f.resume
rescue FiberError => e
  puts "#{e.class}: #{e.message}"
end
# çıktı: FiberError: attempt to resume a terminated fiber
resume ile değer göndermek
İlk resume çağrısına verilen argümanlar blok parametresi olur. Sonraki resume argümanları ise fiber içinde bekleyen Fiber.yield ifadesinin değeri olur:
f = Fiber.new do |ilk|
  ikinci = Fiber.yield ilk + 2
  ikinci * 2
end
f.resume(10) # => 12
f.resume(50) # => 100
Fiber ile sonsuz üreteç
Fiber'lar değerleri istendikçe üreten yapılar için doğaldır. Ruby'deki dış Enumerator da benzer bir fikre dayanır; ayrıntılar Ruby Enumerator ve lazy yazısında:
uretec = Fiber.new do
  a, b = 0, 1
  loop do
    Fiber.yield a
    a, b = b, a + b
  end
end
6.times.map { uretec.resume } # => [0, 1, 1, 2, 3, 5]
Fiber deposu
Fiber[:anahtar] fiber'a özel bir depo sunar. Yeni bir fiber, belgeye göre varsayılan olarak oluşturulduğu fiber'ın deposunun bir kopyasını devralır; içeride yapılan değişiklik dışarıyı etkilemez:
Fiber[:istek_no] = 1
Fiber.new do
  p Fiber[:istek_no]   # çıktı: 1
  Fiber[:istek_no] = 2
end.resume
Fiber[:istek_no] # => 1
Fiber scheduler: engellemeyen G/Ç için arayüz
Fiber scheduler arayüzü, sleep, G/Ç beklemesi, süreç bekleme gibi engelleyen işlemleri yakalayıp bir olay döngüsüne yönlendirmek için tasarlanmıştır. Ruby bu arayüzü tanımlar ama hazır bir scheduler sınıfı sunmaz; belgeye göre tipik bir uygulama Async gibi bir gem'in sarmalayıcısıdır. Bir scheduler, Fiber.set_scheduler(benim_scheduler) ile geçerli thread için ayarlanır ve io_wait, kernel_sleep, block, unblock, fiber gibi kancaları uygular.
Bir fiber, Fiber.new ile varsayılan olan blocking: false ayarıyla ya da Fiber.schedule ile oluşturulursa engellemeyen sayılır. Ancak thread'de scheduler ayarlı değilse engelleyen ve engellemeyen fiber'lar aynı davranır. Varsayılan durumda Fiber.scheduler değeri nil döner. Belgeye göre Mutex, ConditionVariable, Queue, SizedQueue ve Thread#join engellemeyen bağlamda kullanılabilir ve fiber'a özeldir.
Fiber.scheduler                              # => nil
Fiber.new { Fiber.current.blocking? }.resume # => false
Ruby 4.0 NEWS dosyası scheduler tarafında da yenilikler listeliyor: bir fiber'ı verilen hatayla kesmek için Fiber::Scheduler#fiber_interrupt, sinyal istisnaları kapalıyken işlemeye devam etmek için Fiber::Scheduler#yield eklendi, eşzamansız IO#close için io_close kancası geri geldi ve G/Ç yazma tamponu boşaltılırken io_write çağrılıyor. Bu kancalar daha çok scheduler yazan kütüphane geliştiricilerini ilgilendirir.
Thread mi Fiber mi?
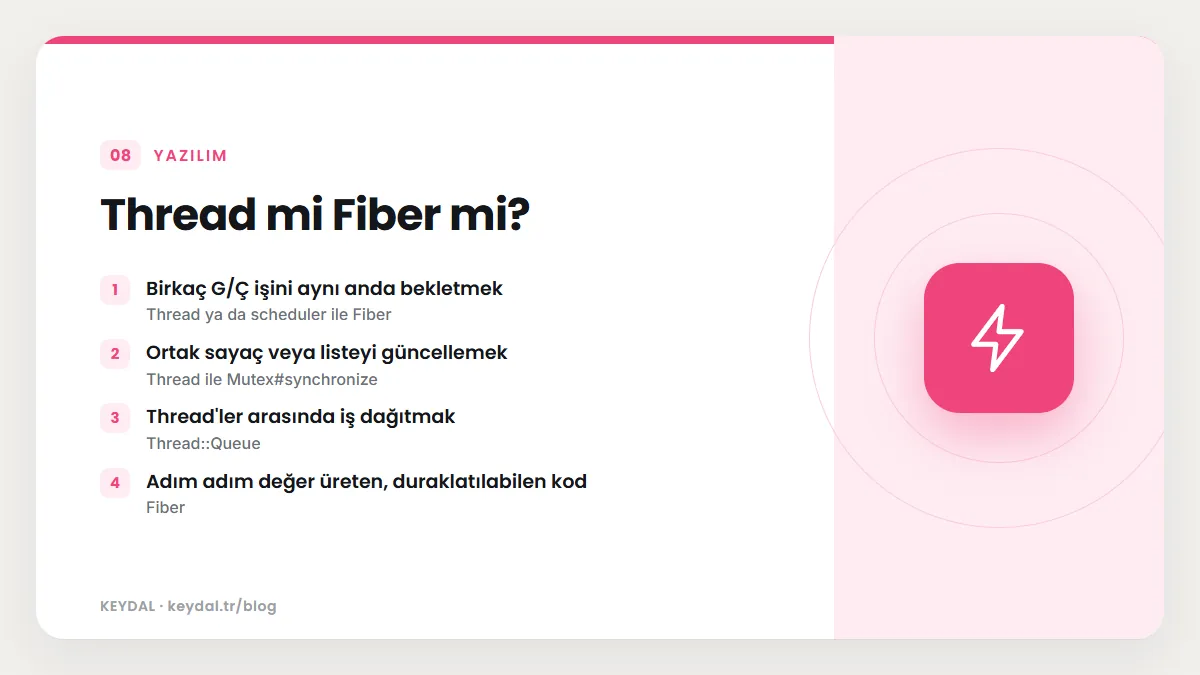
| Durum | Uygun araç |
|---|---|
| Birkaç G/Ç işini aynı anda bekletmek | Thread ya da scheduler ile Fiber |
| Ortak sayaç veya listeyi güncellemek | Thread ile Mutex#synchronize |
| Thread'ler arasında iş dağıtmak | Thread::Queue |
| Adım adım değer üreten, duraklatılabilen kod | Fiber |
| CPU yoğun Ruby kodunu çekirdeklere yaymak | Ractor (deneysel) |
Sık yapılan hatalar
- Thread'leri
joinetmeden programı bitirmek; beklenmeyen thread'ler öldürülür. - Ortak değişkeni kilitsiz değiştirmek. Thread'ler aynı nesnelere erişebildiği için yarış durumu oluşabilir.
- Kuyruğu kapatmayı unutup tüketiciyi sonsuza dek bekletmek.
- Bitmiş bir fiber'ı yeniden
resumeetmek;FiberErroralırsınız, öncealive?ile kontrol edin. - Thread içinde oluşan hatanın kaybolduğunu sanmak; hata
joinya davalueçağrısında yeniden fırlatılır.
Sık Sorulan Sorular
Ruby thread'leri gerçekten paralel çalışır mı?
CRuby'de aynı Ractor içindeki thread'ler GVL'yi paylaştığı için Ruby kodunu paralel çalıştıramaz. G/Ç beklerken diğer thread'ler ilerleyebilir. Ruby kodunu paralel çalıştırmak için Ractor kullanılır.
Mutex ile Thread::Mutex farklı mı?
Hayır. Denememizde Mutex.equal?(Thread::Mutex) ifadesi true döndü; aynı durum Queue ve Thread::Queue için de geçerli.
Fiber.yield ile blok içindeki yield aynı şey mi?
Hayır. Blok içindeki yield bir metoda verilen bloğu çağırır; Fiber.yield ise çalışan fiber'ı duraklatıp denetimi resume çağıran yere verir. Blok yield kullanımı için Ruby blok ve yield yazısına bakın.
Kendi fiber scheduler'ımı yazmalı mıyım?
Genelde hayır. Scheduler arayüzü olay döngüsü yazan kütüphaneler için tasarlanmıştır; uygulama kodunda hazır bir kütüphane kullanmak daha yaygındır.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: Ruby öğrenme rehberi · Ruby Ractor rehberi · Ruby blok ve yield · Ruby Enumerator · Ruby hata yönetimi · Node.js nedir?