Ruby'de düzenli ifadeler Regexp sınıfının nesneleridir ve genellikle /desen/ biçiminde yazılır. Bir metinde eşleşme aramak için üç temel araç vardır: =~ eşleşmenin başladığı karakter konumunu, match ayrıntılı bir MatchData nesnesini, match? ise yalnızca true veya false döndürür. Tüm eşleşmeleri toplamak için scan, bulup değiştirmek için sub ve gsub kullanılır.
Bu yazı düzenli ifadelerin Ruby'ye özgü tarafına odaklanır: literal biçimleri, adlandırılmış yakalama grupları, eşleşme sonrası dolan genel değişkenler, blokla değiştirme, satır ve metin çapaları arasındaki güvenlik açısından önemli fark, Türkçe karakterlerle \w sorunu ve Regexp.timeout. Düzenli ifadelerin genel söz dizimine yeniyseniz önce regex başlangıç rehberi yazısını okumanızı öneririz. Ruby'nin genel haritası için Ruby öğrenme rehberi sayfasına bakabilirsiniz.
Regexp oluşturmanın yolları
En yaygın yol eğik çizgili literaldir. Desenin içinde çok sayıda / varsa %r{...} biçimi kaçış karakteri yazma zahmetini ortadan kaldırır. Desen çalışma anında oluşacaksa Regexp.new veya literal içinde #{...} ile ara değer ekleme kullanılır. Dışarıdan gelen bir metni desene koyarken Regexp.escape ile özel karakterleri etkisizleştirmeyi unutmayın; aksi halde nokta gibi karakterler "herhangi bir karakter" anlamı kazanır.
alan = "example.com"
guvenli = /@#{Regexp.escape(alan)}\z/
p guvenli
p "ali@example.com".match?(guvenli)
p "ali@exampleXcom".match?(guvenli)
p "ali@exampleXcom".match?(/@#{alan}\z/)
p %r{^/blog/(\d+)$}.match("/blog/15")[1]
# çıktı: /@example\.com\z/
# çıktı: true
# çıktı: false
# çıktı: true
# çıktı: "15"
Dördüncü satırdaki true sonucu tipik bir hatayı gösteriyor: kaçışsız eklenen example.com içindeki nokta herhangi bir karakterle eşleştiği için exampleXcom da kabul edildi.
=~, match ve match? farkı
Belgelere göre =~ eşleşme varsa başlangıç konumunu (karakter cinsinden), yoksa nil döndürür. match eşleşme varsa bir MatchData döndürür; bu nesneden tüm eşleşmeye md[0], gruplara md[1], md[2] ile ulaşırsınız. Bu iki yöntem ayrıca $~, $1 gibi genel değişkenleri doldurur. match? ise yalnızca evet ya da hayır der ve hiçbir genel değişkeni değiştirmez; sadece kontrol yapacaksanız doğru seçim odur.
metin = "Sipariş no: TR-2026-0042"

p metin =~ /\d+/
p metin.match?(/TR-/)
md = metin.match(/TR-(\d{4})-(\d+)/)
p md
p md[0]
p md[1]
p md.pre_match
p metin =~ /XYZ/
# çıktı: 15
# çıktı: true
# çıktı: #<MatchData "TR-2026-0042" 1:"2026" 2:"0042">
# çıktı: "TR-2026-0042"
# çıktı: "2026"
# çıktı: "Sipariş no: "
# çıktı: nil
=~ sonucunun 15 olması, konumun bayt değil karakter cinsinden sayıldığını gösterir; ş UTF-8 içinde iki bayt kaplasa da tek karakter sayılır. Kodlamalarla ilgili ayrıntı Ruby encoding ve Türkçe karakter yazısında.
Eşleşme sonrası genel değişkenler
match veya =~ çalıştıktan sonra $~ son MatchData nesnesini, $& eşleşen metni, $1, $2 grupları verir. Bunlar kısa betiklerde pratiktir, ancak bir sonraki eşleşmede değiştikleri için uzun kodda MatchData nesnesini bir değişkende tutmak daha güvenlidir.
if "Kargo kodu: 12345" =~ /(\d+)/
  p $~
  p $1
end
"abc".match?(/b/)
p $1
# çıktı: #<MatchData "12345" 1:"12345">
# çıktı: "12345"
# çıktı: "12345"
Son satır match? çağrısının $1 değerine dokunmadığını gösteriyor: değer bir önceki eşleşmeden kaldı.
Adlandırılmış yakalama grupları
Grupları numara yerine isimle anmak için (?<isim>...) söz dizimi kullanılır. MatchData üzerinde md[:isim] ile okuyabilir, named_captures ile tüm grupları bir hash olarak alabilirsiniz. Belgelerin belirttiği özel bir kolaylık daha var: desen literal olarak yazılmışsa, içinde ara değer (#{}) yoksa ve =~ operatörünün solunda duruyorsa, grup adları doğrudan yerel değişken olarak oluşturulur.
if /(?<gun>\d{2})\.(?<ay>\d{2})\.(?<yil>\d{4})/ =~ "Teslim: 07.11.2026"
  puts "Gün #{gun}, ay #{ay}, yıl #{yil}"
end

md = "Teslim: 07.11.2026".match(/(?<gun>\d{2})\.(?<ay>\d{2})\.(?<yil>\d{4})/)
p md[:yil]
p md.named_captures
p md.named_captures(symbolize_names: true)
p md.captures
# çıktı: Gün 07, ay 11, yıl 2026
# çıktı: "2026"
# çıktı: {"gun" => "07", "ay" => "11", "yil" => "2026"}
# çıktı: {gun: "07", ay: "11", yil: "2026"}
# çıktı: ["07", "11", "2026"]MatchData nesnesi pattern matching ile de açılabilir; bunun örneği Ruby pattern matching yazısında.
scan ile tüm eşleşmeleri toplamak
String#scan desenin metindeki tüm eşleşmelerini bir dizi olarak döndürür. Desende grup yoksa her eleman eşleşen metindir; grup varsa her eleman, grupların değerlerinden oluşan bir dizidir. Blok verirseniz her sonuç bloğa gönderilir.
log = "GET /a 200, POST /b 500, GET /c 404"

p log.scan(/\d{3}/)
p log.scan(/(GET|POST) (\S+)/)
log.scan(/(GET|POST) \S+ (\d+)/) { |yontem, kod| puts "#{yontem}: #{kod}" }
# çıktı: ["200", "500", "404"]
# çıktı: [["GET", "/a"], ["POST", "/b"], ["GET", "/c"]]
# çıktı: GET: 200
# çıktı: POST: 500
# çıktı: GET: 404
sub ve gsub ile değiştirme
sub ilk eşleşmeyi, gsub tüm eşleşmeleri değiştirir ve yeni bir metin döndürür; ünlem işaretli sub! ve gsub! ise metni yerinde değiştirir. Yerine geçecek değeri üç şekilde verebilirsiniz: bir metin, bir hash ya da bir blok. Yerine koyma metninde \1 numaralı gruba, \k<isim> adlandırılmış gruba başvurur. Bu başvurular için tek tırnaklı metin kullanmak, ters eğik çizgileri iki kez yazma zorunluluğunu ortadan kaldırır.
tel = "Telefon: 0532 123 45 67"
p tel.gsub(/\d/, "*")

p "2026-11-07".sub(/(\d+)-(\d+)-(\d+)/, '\3.\2.\1')
p "2026-11-07".sub(/(?<y>\d+)-(?<a>\d+)-(?<g>\d+)/, '\k<g>/\k<a>/\k<y>')

p "kedi ve köpek".gsub(/kedi|köpek/, "kedi" => "cat", "köpek" => "dog")

p "fiyat: 100 TL, kargo: 30 TL".gsub(/\d+/) { |s| (s.to_i * 1.2).round.to_s }
p "ali@x.com, veli@y.com".gsub(/(\w+)@/) { "#{$1.capitalize}@" }
# çıktı: "Telefon: **** *** ** **"
# çıktı: "07.11.2026"
# çıktı: "07/11/2026"
# çıktı: "cat ve dog"
# çıktı: "fiyat: 120 TL, kargo: 36 TL"
# çıktı: "Ali@x.com, Veli@y.com"
Blok biçiminde eşleşen metin bloğa parametre olarak gelir ve bloğun döndürdüğü değer yerine konur; belgelere göre bloğun içinde $1 gibi değişkenler de o anki eşleşmeye göre doldurulur. Hesap yapmanız gereken değiştirmelerde blok en okunaklı seçenektir.
Çapalar: ^ ve $ ile \A ve \z farkı
Ruby'de bu fark özellikle önemlidir. Belgelere göre ^ ve $ her zaman satır başı ve sonuyla eşleşir; m değiştiricisi bunu etkilemez. Metnin tamamının başı ve sonu için \A ve \z kullanılır. Kullanıcı girdisini doğrularken ^...$ yazarsanız, çok satırlı bir girdinin yalnızca bir satırı uygun olduğunda bile doğrulama geçer.
girdi = "42\nrm -rf /"
p girdi.match?(/^\d+$/)
p girdi.match?(/\A\d+\z/)
# çıktı: true
# çıktı: falseTürkçe karakterler ve \w
Ruby belgeleri \w kısaltmasını açıkça [a-zA-Z0-9_] olarak tanımlar. Yani ç, ğ, ı, ö, ş, ü gibi harfler \w ile eşleşmez ve kelimeler parçalanır. Aynı şekilde \d yalnızca ASCII rakamlardır. Unicode harfleri kapsamak için \p{Word}, \p{Alpha} gibi Unicode özelliklerini ya da [[:alpha:]] gibi POSIX köşeli parantez ifadelerini kullanın; belgelere göre POSIX ifadeleri ASCII dışı karakterleri de kapsar.
s = "çiçek ağacı"
p s.scan(/\w+/)
p s.scan(/\p{Word}+/)
p s.scan(/[[:alpha:]]+/)
p "Şişli" =~ /\A[[:upper:]]/
# çıktı: ["i", "ek", "a", "ac"]
# çıktı: ["çiçek", "ağacı"]
# çıktı: ["çiçek", "ağacı"]
# çıktı: 0
Değiştiriciler: i, m ve x
Desenin sonuna eklenen harfler davranışı değiştirir. i büyük ve küçük harf ayrımını kaldırır. m Ruby'de diğer dillerdeki "dot-all" moduna karşılık gelir: noktanın satır sonu karakteriyle de eşleşmesini sağlar. x ise desen içindeki boşlukları yok sayar ve # ile açıklama yazmanıza izin verir; uzun desenleri okunur kılmak için idealdir.
p "RUBY" =~ /ruby/i
p "a\nb".match?(/a.b/)
p "a\nb".match?(/a.b/m)

tarih = /
  (\d{4})  # yıl
  -
  (\d{2})  # ay
/x
p "2026-11".match(tarih).captures
# çıktı: 0
# çıktı: false
# çıktı: true
# çıktı: ["2026", "11"]
Nicelik belirteçleri varsayılan olarak açgözlüdür (.* olabildiğince çok karakter alır). Belgelere göre sonuna ? eklenmiş *?, +? gibi tembel belirteçler en az sayıda tekrarla yetinir; tekrar eden ayraçlar arasında arama yaparken bu fark sonucu tamamen değiştirebilir:
html = "<b>kalın</b> ve <b>yine</b>"
p html[/<b>.*<\/b>/]
p html[/<b>.*?<\/b>/]
# çıktı: "<b>kalın</b> ve <b>yine</b>"
# çıktı: "<b>kalın</b>"
Regexp.timeout ve ReDoS
Bazı desenler belirli girdilerde çok uzun sürebilir; buna düzenli ifade hizmet engelleme saldırısı (ReDoS) denir. Ruby 3.2 NEWS dosyasına göre o sürümde önbellek tabanlı bir eşleştirme iyileştirmesi, Regexp.linear_time? ve Regexp.timeout= eklendi. Belgelere göre iyileştirme; geri başvuru, alt ifade çağrısı, iç içe lookaround veya atomik grup ve sayılı iç içe nicelik belirteci içermeyen desenlere uygulanır. Bu koşulları karşılamayan bir desen güvenilmeyen girdiyle çalışacaksa zaman aşımı koymak mantıklıdır.
p Regexp.timeout
p Regexp.linear_time?(/a*/)
p Regexp.linear_time?(/^(a|aa)+\1$/)

yavas = Regexp.new('^(a|aa)+\1$', timeout: 0.2)
p yavas.timeout
begin
  yavas.match?("a" * 60 + "b")
rescue Regexp::TimeoutError => e
  puts "#{e.class}: #{e.message}"
end
# çıktı: nil
# çıktı: true
# çıktı: false
# çıktı: 0.2
# çıktı: Regexp::TimeoutError: regexp match timeout
Zaman aşımı iki düzeyde ayarlanır: Regexp.timeout = 1.0 tüm desenler için varsayılanı belirler, Regexp.new(..., timeout: 0.2) ise tek bir desene özeldir. Belgelerdeki tabloya göre desenin kendi değeri nil ise sınıf düzeyindeki değer geçerli olur; ikisi de nil ise eşleşme hiç zaman aşımına uğramaz. Belgeler ayrıca linear_time? sonucunun true olmasının tek başına güvence olmadığını, çünkü iyileştirmenin bellek tüketebileceğini not eder.
Hangi yöntemi ne zaman kullanmalı?
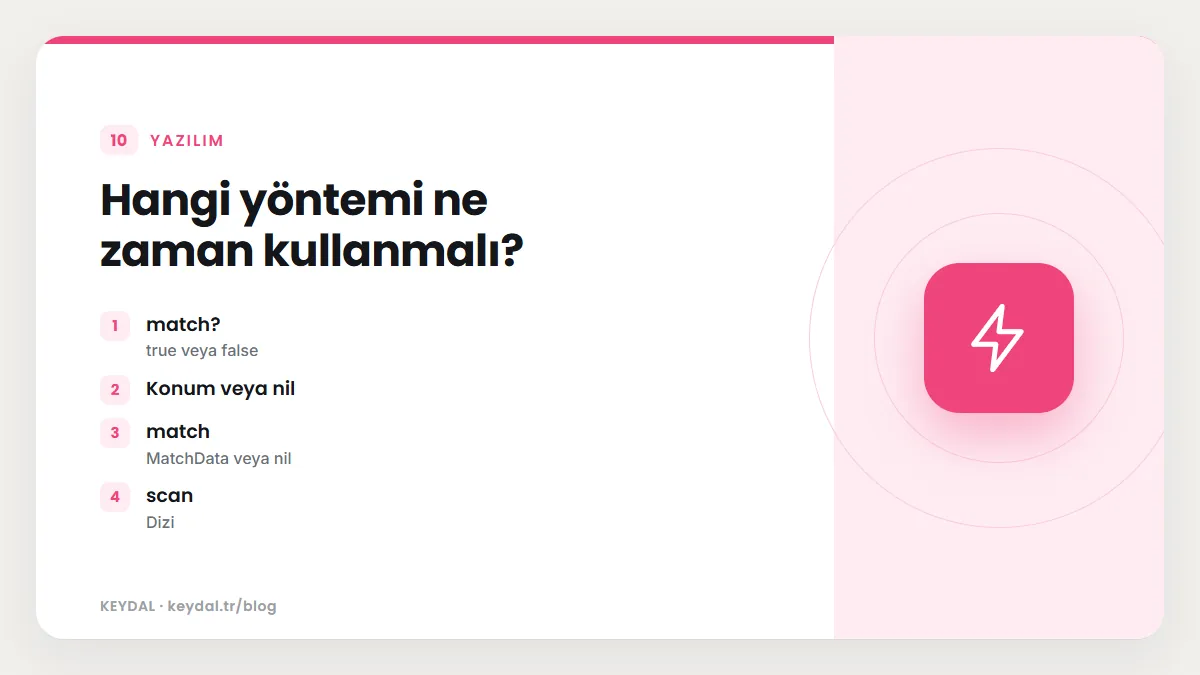
| Yöntem | Döndürdüğü | Genel değişken | Tipik kullanım |
|---|---|---|---|
| match? | true veya false | Değiştirmez | Yalnızca kontrol |
| =~ | Konum veya nil | Doldurur | Konum gerektiğinde, adlı gruplarla yerel değişken |
| match | MatchData veya nil | Doldurur | Grupları ve ayrıntıyı okumak |
| scan | Dizi | Doldurur | Tüm eşleşmeleri toplamak |
| sub / gsub | Yeni metin | Blok içinde doldurur | İlk veya tüm eşleşmeleri değiştirmek |
Belgelerdeki Regexp Methods listesine göre grep, index, partition, split, start_with?, slice gibi pek çok metot da metin yerine düzenli ifade kabul eder. Metin metotlarının tamamı için Ruby string metotları yazısına bakabilirsiniz.
Sık yapılan hatalar
- Doğrulamada ^ ve $ kullanmak: Çok satırlı girdide yalnızca bir satır uyarsa doğrulama geçer.
\Ave\zkullanın. - Türkçe metinde \w:
\wyalnızca ASCII harf, rakam ve alt çizgidir;\p{Word}veya[[:alpha:]]tercih edin. - Kaçışsız ara değer: Dışarıdan gelen metni
Regexp.escapeolmadan desene koymak, nokta ve yıldız gibi karakterlerin özel anlam kazanmasına yol açar. - Adlı grup değişkeni beklemek: Desen solda ve literal değilse
=~yerel değişken oluşturmaz. - Yalnızca kontrol için match kullanmak: Sonuç gerekmiyorsa
match?hem niyeti açık gösterir hem de genel değişkenleri bozmaz. - Ters eğik çizgi karmaşası:
gsubyerine koyma metninde çift tırnak kullanırsanız her ters eğik çizgiyi iki kez yazmanız gerekir; tek tırnak veya blok kullanın.
Sık Sorulan Sorular
Ruby'de büyük küçük harfe duyarsız arama nasıl yapılır?
Desenin sonuna i ekleyin: /ruby/i. Desenin yalnızca bir kısmında geçerli olsun istiyorsanız belgelerdeki (?i:...) biçimini kullanabilirsiniz.
=~ neden bazen nil, bazen sayı döndürüyor?
=~ eşleşme bulduğunda başlangıç konumunu, bulamadığında nil döndürür. Ruby'de nil yanlış, her sayı (0 dahil) doğru kabul edildiği için sonucu doğrudan if içinde kullanabilirsiniz.
Regexp.timeout varsayılan olarak açık mı?
Hayır. Belgelere göre sınıf düzeyindeki varsayılan değer nil ile başlar; yukarıdaki örnekte de Regexp.timeout çıktısı nil oldu. Zaman aşımı istiyorsanız kendiniz ayarlamanız gerekir.
Türkçe İ ve ı harflerinde büyük küçük harf dönüşümü nasıl yapılır?
Ruby metin tarafında upcase(:turkic) ve downcase(:turkic) seçeneklerini sunar. Karşılaştırmadan önce iki tarafı aynı kuralla dönüştürmek en öngörülebilir yoldur; ayrıntılar Ruby encoding ve Türkçe karakter yazısında.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: Ruby öğrenme rehberi · Regex başlangıç rehberi · Ruby string metotları · Ruby encoding · Ruby pattern matching · Ruby symbol ve string farkı