Redis'te Bloom filter, bir öğenin bir kümede olup olmadığını çok az ve sabit boyutlu bellekle yanıtlayan olasılıksal bir veri yapısıdır. BF.RESERVE ile hedef hata oranını ve beklenen kapasiteyi vererek filtreyi oluşturur, BF.ADD ile öğe ekler, BF.EXISTS ile sorgularsınız. Filtre "yok" dediğinde öğe kesinlikle yoktur; "var" dediğinde ise belirli bir olasılıkla yanılıyor olabilir. Silme de gerekiyorsa aynı işi yapan Cuckoo filter (CF.* komutları) kullanılır.
Bu yazı Bloom ve Cuckoo filter'ı ayrıntılı, aynı aileden Count-min sketch, Top-K ve t-digest yapılarını ise kısaca anlatır. Redis 8.0 sürüm notlarına göre olasılıksal yapılar artık Redis Open Source'un parçasıdır; eski sürümlerde bu komutlar için modüllü bir dağıtım gerekiyordu. Tekil öğe sayımı yapan HyperLogLog bu ailenin bir başka üyesidir ve ayrı bir yazıda anlatılır.
Olasılıksal veri yapısı ne demek?
Redis belgelerinin tanımıyla olasılıksal veri yapıları sayı, sıklık veya sıralama gibi istatistiklerin kesin değerini değil yaklaşığını verir. Karşılığında çok daha az bellek kullanır ve çok daha hızlı hesaplanır; belge ayrıca bazı durumlarda zaman, konum gibi hassas verileri gizleme avantajı sağladığını da belirtir. Örneğin bir Bloom filter öğelerin kendisini değil, karma (hash) temsillerini saklar. Bu yüzden hem küçük kalır hem de içindeki öğeleri geri okuyamazsınız; filtre yalnızca "bu öğe daha önce eklendi mi?" sorusuna yanıt verir.
Bu ödünleşimin işe yaradığı durumlar, olumsuz yanıtın pahalı bir işlemi engellediği durumlardır. Belgenin örnekleriyle: bir kullanıcı adının alınıp alınmadığını, bir kredi kartının çalıntı bildirilip bildirilmediğini veya bir kullanıcının bir reklamı daha önce görüp görmediğini sorduğunuzda "kesinlikle yok" yanıtı veritabanına gitmeden işi bitirir. "Muhtemelen var" yanıtında ise asıl kaynağa bakar ya da isteği reddedersiniz. Sonucun kesin olması gereken işlerde, örneğin bir kullanıcının gerçek sıralamasını göstermek gibi, bu yapılar yerine kesin veri tipleri kullanılmalıdır; tip seçimi için veri tipi seçimi yazısına bakın.
Bloom filter nasıl çalışır?
Bloom filter bir bit dizisidir. Bir öğe eklendiğinde birkaç karma fonksiyonu öğeden bit konumları üretir ve bu bitler 1 yapılır. Sorgularken aynı konumlara bakılır: herhangi biri 0 ise öğe hiç eklenmemiştir. Hepsi 1 ise öğe eklenmiş olabilir, ama bu bitleri başka öğeler de 1 yapmış olabilir; yanlış pozitif buradan gelir. Belgenin ifadesiyle filtre bir öğenin yokluğunu garanti eder, varlığı hakkında ise yalnızca tahmin verir. Az sayıda öğe varken bile yanlış pozitif olasılığı sıfır değildir.
Belgede sayılan kullanım senaryoları fikir vermesi için iyidir:
- Dolandırıcılık tespiti: Kullanıcı başına bir filtre tutup "bu kullanıcı daha önce bu konumdan ödeme yaptı mı?" sorusunu her işlemde hızla yanıtlamak.
- Reklam yerleşimi: Kullanıcının satın aldığı ürünleri filtrede tutmak; öneri motoru yeni bir ürünü filtreye sorar, yoksa gösterir ve ekler, varsa başka ürüne geçer.
- Kullanıcı adı kontrolü: Kayıtlı tüm kullanıcı adlarını filtreye eklemek; yeni ad filtrede yoksa kullanıcı oluşturulur, varsa uygulama ana veritabanına bakar veya adı reddeder. Belge bu sorgunun süresinin ölçek büyüdükçe sabit kaldığını vurgular.
BF.RESERVE, BF.ADD ve BF.EXISTS
Belgedeki örnek, bir milyon farklı bisiklet modeli üreten bir firmanın yeni modellere yinelenen ad vermekten kaçınmasıdır. Bir milyon öğelik ve yüzde 0,1 hata oranlı bir filtre oluşturulur, önce tek, sonra birden çok model adı eklenip sorgulanır:
> BF.RESERVE bikes:models 0.001 1000000
OK
> BF.ADD bikes:models "Smoky Mountain Striker"
(integer) 1
> BF.EXISTS bikes:models "Smoky Mountain Striker"
(integer) 1
> BF.MADD bikes:models "Rocky Mountain Racer" "Cloudy City Cruiser" "Windy City Wippet"
1) (integer) 1
2) (integer) 1
3) (integer) 1
> BF.MEXISTS bikes:models "Rocky Mountain Racer" "Cloudy City Cruiser" "Windy City Wippet"
1) (integer) 1
2) (integer) 1
3) (integer) 1
BF.RESERVE argümanlarının sırasına dikkat edin: önce anahtar, sonra hata oranı, sonra kapasite gelir. Hata oranı 0 ile 1 arasında bir ondalık sayıdır; yüzde 0,1 (binde bir) için 0.001 yazılır. BF.MADD ve BF.MEXISTS çok öğeli sürümlerdir ve her öğe için ayrı bir sonuç döndürür.
BF.ADD dönüş değeri iki anlam taşır: 1, öğenin başarıyla eklendiğini; 0 ise öğenin filtreye daha önce eklenmiş olma olasılığını gösterir. RESP3 bağlantılarında bu değerler true ve false olarak gelir. Komut sayfasındaki küçük örnek aynı öğeyi iki kez ekler:
> BF.ADD bf item1
(integer) 1
> BF.ADD bf item1
(integer) 0
Burada önemli bir ayrıntı var: anahtar yoksa BF.ADD varsayılan hata oranı, kapasite ve genişleme değerleriyle yeni bir filtreyi kendiliğinden oluşturur. Bu kolaylık, boyutlandırmayı atlamanıza yol açabilir. Kapasitesini bildiğiniz filtreleri BF.RESERVE ile önceden oluşturun. Var olan bir anahtar üzerinde BF.RESERVE çağırırsanız komut sayfasının gösterdiği hatayı alırsınız:
> BF.RESERVE bf 0.01 1000
OK
> BF.RESERVE bf 0.01 1000
(error) ERR item exists
Bloom filter boyutlandırma
Belgeye göre boyutlandırma işinin büyük kısmını Redis yapar; sizin vermeniz gereken iki temel değer hata oranı ve kapasitedir. Kapasite, filtreye toplamda eklemeyi beklediğiniz öğe sayısıdır. Fazla büyük seçerseniz bellek boşa gider. Küçük seçerseniz filtre dolar ve üstüne yeni bir alt filtre yığılır. Yığılmış filtrelerde ekleme gecikmesi aynı kalır, ancak varlık kontrolü yavaşlar: sorgu önce en üstteki (en yeni) filtreye bakar, olumsuz yanıt alırsa bir alttakine geçer ve bu böyle devam eder.
Filtre dolduğunda ekleme başarısız olmaz; bunun yerine hata oranı yükselmeye başlar. Hata oranını başlangıçtaki değere yakın tutmak için filtre kendini ölçekler, yani kapasiteye ulaşınca yeni bir alt filtre oluşturur. Yeni alt filtrenin boyutu, bir öncekinin EXPANSION değeriyle çarpımıdır ve varsayılan genişleme 2'dir. Belge, öğe sayısı bilinmiyorsa alt filtre sayısını azaltmak için 2 veya daha büyük, biliniyorsa bellekten tasarruf için 1 kullanmayı önerir. Büyümeyeceğinden eminseniz NONSCALING bayrağı filtrenin bir karma fonksiyonu daha az kullanmasını sağlar; ancak bu durumda kapasiteye ulaşıldığında filtre hata döndürür.
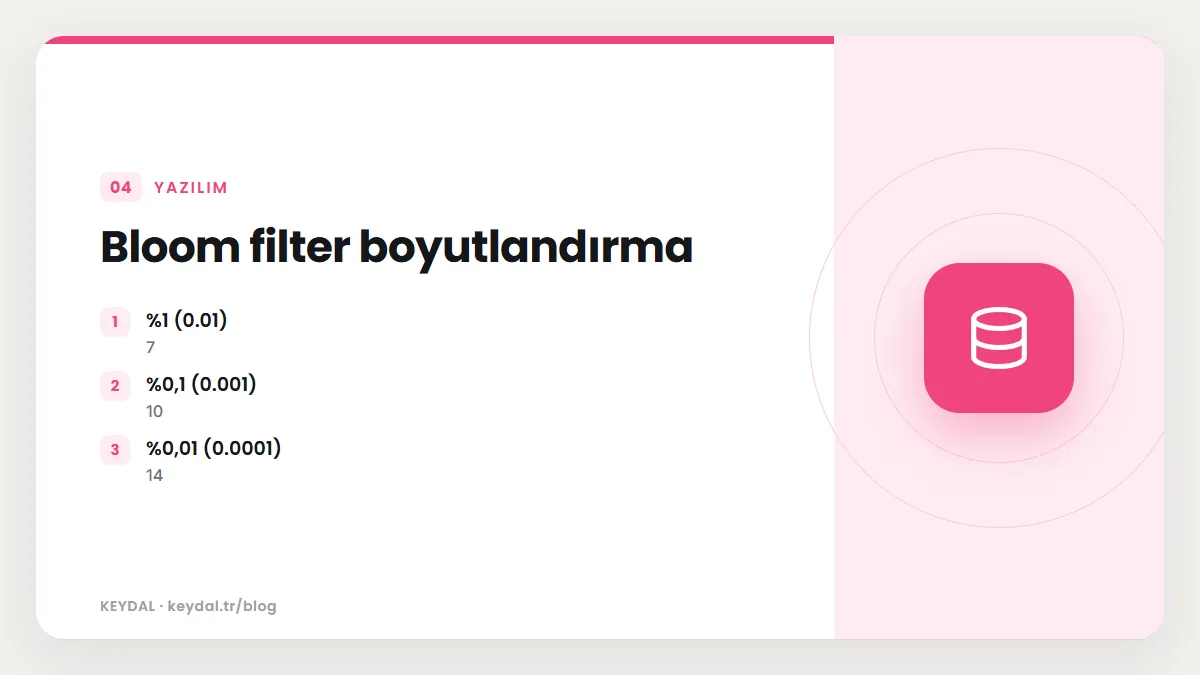
Bellek ihtiyacı yalnızca hata oranına bağlıdır. En uygun karma fonksiyonu sayısı ceil(-ln(error_rate) / ln(2)), öğe başına gereken bit sayısı -ln(error_rate) / ln(2)^2 formülüyle bulunur; filtrenin toplam bit sayısı bunun kapasiteyle çarpımıdır. Belgedeki hazır değerler:
| Hata oranı | Karma fonksiyonu | Öğe başına bit |
|---|---|---|
| %1 (0.01) | 7 | 9,585 |
| %0,1 (0.001) | 10 | 14,378 |
| %0,01 (0.0001) | 14 | 19,170 |
Küçük bir hesapla somutlaştıralım. Yukarıdaki örnekteki gibi bir milyon kapasiteli ve 0.001 hata oranlı bir filtre, öğe başına 14,378 bitle yaklaşık 14,4 milyon bit, yani 1,8 milyon bayt civarında yer tutar. Belge karşılaştırma olarak IP adresleri saklayan bir Redis set'inin öğe başına yaklaşık 40 bayt (320 bit) kullandığını, bunun yüzde 0,01 hata oranlı bir Bloom filter'ın 19,170 bitinden çok daha fazla olduğunu belirtir. Hata oranını on kat düşürmenin maliyeti öğe başına yaklaşık 4,8 bittir; bu yüzden çoğu zaman hata oranını, yanlış pozitifin size maliyetine göre seçmek mantıklıdır.
Cuckoo filter: silme gerektiğinde
Cuckoo filter da bir öğenin kümede olup olmadığını hızlı ve az bellekle yanıtlar, ama yapısı farklıdır. Bit dizisi yerine kovalardan (bucket) oluşan bir dizi kullanır ve değerlerin parmak izlerini iki karma fonksiyonunun belirlediği kovalardan birine yazar. Sorgu, öğenin olası kovalarında aynı parmak izini arar. Parmak izinin boyutu yanlış pozitif oranını doğrudan belirler. En önemli farkı silmeye izin vermesidir: Bloom filter'dan bir öğeyi çıkaramazsınız, Cuckoo filter'dan CF.DEL ile çıkarabilirsiniz.
> CF.RESERVE bikes:models 1000
OK
> CF.ADD bikes:models "Smoky Mountain Striker"
(integer) 1
> CF.EXISTS bikes:models "Smoky Mountain Striker"
(integer) 1
> CF.EXISTS bikes:models "Terrible Bike Name"
(integer) 0
> CF.DEL bikes:models "Smoky Mountain Striker"
(integer) 1
Belgenin Cuckoo örnekleri silmenin neden işe yaradığını gösterir: bir indirim kuponu kullanıldığında kodu filtreden çıkarmak veya bir kampanyaya kaydolan kullanıcıyı kampanya filtresinden silmek. CF.ADD da anahtar yoksa filtreyi kendisi oluşturabilir, ama belge kapasiteyi kendiniz belirlemek için CF.RESERVE kullanmanızı önerir.
Cuckoo filter boyutlandırma
CF.RESERVE kapasite, BUCKETSIZE, MAXITERATIONS ve EXPANSION alır. Kapasite bir sonraki ikinin kuvvetine yuvarlanır. Kova boyutu, her kovadaki giriş sayısıdır; büyütmek doluluk oranını artırır ama hata oranını da artırır ve performansı biraz düşürür. Belgedeki değerler şöyledir:
| Kova boyutu | Doluluk oranı | Yanlış pozitif oranı |
|---|---|---|
| 1 | %55 | yaklaşık %0,78 (ulaşılabilecek en düşük) |
| 3 | %80 | %2,34 |
| 4 | %95 | %3,12 |
Cuckoo filter'ın bilinmesi gereken birkaç tuzağı vardır. Aynı öğeyi tekrar tekrar eklemek her seferinde yeni bir giriş oluşturur ve filtreyi doldurur; Bloom filter'daki gibi "zaten var" diye atlanmaz. Filtre çalışma biçimi gereği kapasiteye ulaşmadan kendini dolu ilan edebilir, bu yüzden doluluk oranı pratikte yüzde yüze ulaşmaz. Dolduğunda yeni alt filtreler eklenir; belge bunun performansı düşürdüğünü ve toplam hatanın alt filtrelerin hatalarının toplamı olarak doğrusal büyüdüğünü belirtir. MAXITERATIONS, yeni parmak izine yer bulmak için yapılacak deneme sayısıdır; filtre doluyken yüksek bir değer eklemeleri yavaşlatır. Filtrenin en fazla kaç kez genişleyebileceğini cf-max-expansions yapılandırması belirler. İyi tarafı, öğe silerek sınırlar içinde kalabilmeniz ve filtreyi yeniden kurmak zorunda kalmamanızdır.
Bloom mu, Cuckoo mu?
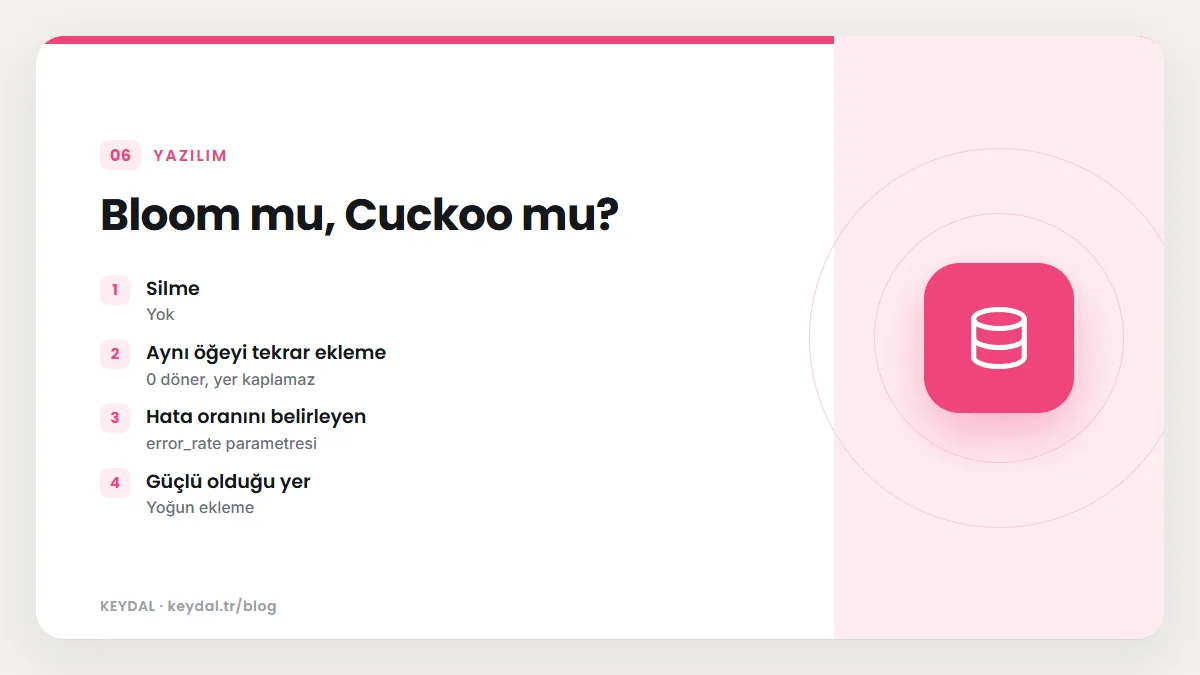
Belgenin kısa özeti şudur: Bloom filter ekleme tarafında genellikle daha iyi performans ve ölçeklenme gösterir, sık öğe ekliyorsanız uygun olabilir; Cuckoo filter ise kontrol işlemlerinde daha hızlıdır ve silmeye izin verir. Karmaşıklık açısından Bloom'da ekleme O(K), sorgu O(K) veya yığılmış filtrelerde O(K*n) iken Cuckoo'da ekleme, sorgu ve silme O(1)'dir.
| Özellik | Bloom filter | Cuckoo filter |
|---|---|---|
| Silme | Yok | CF.DEL ile var |
| Aynı öğeyi tekrar ekleme | 0 döner, yer kaplamaz | Yeni giriş oluşturur |
| Hata oranını belirleyen | error_rate parametresi | Kova boyutu ve parmak izi |
| Güçlü olduğu yer | Yoğun ekleme | Hızlı kontrol ve silme |
| Dolunca | Alt filtre ekler, hata oranı korunur | Alt filtre ekler, hata toplanır |
Aynı ailenin diğer üyeleri
Count-min sketch: sıklık tahmini
Count-min sketch bir veri akışındaki olayların sıklığını tahmin eder. Çakışmalar yüzünden bazı olayları fazla sayabilir, bu yüzden belge hata oranının belirlediği eşiğin altındaki sonuçların gürültü sayılıp yok sayılması gerektiğini vurgular. Eşik error * total_count formülüyle hesaplanır ve toplam sayım arttıkça büyür. Belgedeki örnek:
> CMS.INITBYPROB bikes:profit 0.001 0.002
OK
> CMS.INCRBY bikes:profit "Smokey Mountain Striker" 100
1) (integer) 100
> CMS.INCRBY bikes:profit "Rocky Mountain Racer" 200 "Cloudy City Cruiser" 150
1) (integer) 200
2) (integer) 150
> CMS.QUERY bikes:profit "Smokey Mountain Striker" "Rocky Mountain Racer" "Cloudy City Cruiser" "Terrible Bike Name"
1) (integer) 100
2) (integer) 200
3) (integer) 150
4) (integer) 0
> CMS.INFO bikes:profit
1) width
2) (integer) 2000
3) depth
4) (integer) 9
5) count
6) (integer) 450
Belgenin sayısal örneğine göre her biri yaklaşık 500 sayımlı, düzgün dağılmış 1000 öğede 0.001 hata oranıyla eşik 500 olur; bu da yapının düzgün dağılımlı akışlar için pek uygun olmadığını gösterir. Buna karşılık az sayıda "ağır" öğenin toplamın büyük kısmını oluşturduğu akışlarda eşik iki grubun arasına rahatça oturur.
Top-K: en sık görülen öğeler
Top-K, bir akıştaki en yüksek sayıma sahip K öğeyi tahmin eder; belge ağ anomalileri ve DDoS tespiti ile trend etiketleri örnek verir. TOPK.ADD, bir öğe eklendiğinde listeden düşen öğeyi döndürür, böylece listeye girip çıkanları anında görebilirsiniz:
> TOPK.RESERVE bikes:keywords 5 2000 7 0.925
OK
> TOPK.ADD bikes:keywords store seat handlebars handles pedals tires store seat
1) (nil)
2) (nil)
3) (nil)
4) (nil)
5) (nil)
6) "handlebars"
7) (nil)
8) (nil)
> TOPK.LIST bikes:keywords
1) "store"
2) "seat"
3) "pedals"
4) "tires"
5) "handles"
> TOPK.QUERY bikes:keywords store handlebars
1) (integer) 1
2) (integer) 0
Kesin sıralama ve "benim çevremdeki oyuncular" gibi komşuluk sorguları gerekiyorsa Top-K yerine sorted set kullanılır; leaderboard belgesi bu ayrımı açıkça yapar. Bunun için leaderboard yazısına bakın.
t-digest: yüzdelik tahmini
t-digest, tüm değerleri saklayıp sıralamadan yüzdelik dilim tahmin eder: "gecikmelerin yüzde 99'u kaç milisaniyenin altında?" gibi sorular için uygundur. Belgedeki örnekte on bir yarışçı yaşı eklenir ve 50 yaşından küçüklerin oranı sorulur:
> TDIGEST.CREATE racer_ages
OK
> TDIGEST.ADD racer_ages 45.88 44.2 58.03 19.76 39.84 69.28 50.97 25.41 19.27 85.71 42.63
OK
> TDIGEST.CDF racer_ages 50
1) "0.6363636363636364"
> TDIGEST.RANK racer_ages 50
1) (integer) 7
Diğer olasılıksal yapılardan farklı olarak TDIGEST.ADD anahtar yoksa yapıyı oluşturmaz; önce TDIGEST.CREATE çalıştırmanız gerekir. Sayısal ölçümlerin zamana göre saklanması gerekiyorsa Redis Time Series daha uygun olabilir.
Sık yapılan hatalar
- Filtrenin "var" yanıtını kesin kabul etmek: Olumlu yanıt yalnızca olasılıktır; kesinlik gereken yerde ana veri kaynağına bakın.
- Boyutlandırmayı atlamak:
BF.ADDveCF.ADDvarsayılan değerlerle filtre oluşturur. Beklenen öğe sayısını biliyorsanızBF.RESERVEveyaCF.RESERVEile başlayın. - Argüman sırasını karıştırmak:
BF.RESERVEönce hata oranını, sonra kapasiteyi alır;CF.RESERVEise zorunlu argüman olarak yalnızca kapasiteyi alır, hata oranını kova boyutu belirler. - Bloom filter'dan silmeye çalışmak: Bloom filter silme desteklemez; silme gerekiyorsa Cuckoo filter seçin.
- Cuckoo filter'a aynı öğeyi tekrar eklemek: Her ekleme yeni bir giriş oluşturur ve filtreyi doldurur; eklemeden önce
CF.EXISTSile kontrol etmeyi düşünün. - Count-min sketch'in küçük sayımlarına güvenmek: Eşiğin altındaki değerler gürültüdür.
- İstemci önbelleğinden fayda beklemek: İstemci tarafı önbellek olasılıksal yapı komutlarını önbelleğe almaz, çünkü bu yapılar sık güncellenir.
Sık Sorulan Sorular
Bloom filter yanlış negatif verir mi?
Hayır. Belgeye göre filtre bir öğenin yokluğunu garanti eder; "yok" yanıtı her zaman doğrudur. Yanılma yalnızca "var" yanıtında, seçtiğiniz hata oranına yakın bir olasılıkla olur. Filtre kapasitesini aştıkça ve ölçeklenmesi kapalıysa bu oran yükselir.
Bir filtreye kaç öğe ekleyebilirim?
Ölçeklenen bir Bloom filter'a ekleme dolduğu için başarısız olmaz, yeni alt filtreler eklenir ve sorgular yavaşlar. NONSCALING ile oluşturulmuş bir filtre ise kapasiteye ulaşınca hata döndürür. Cuckoo filter kapasiteye ulaşmadan dolu ilan edilebilir ve en fazla cf-max-expansions kez genişler.
Set yerine neden Bloom filter kullanayım?
Bellek nedeniyle. Belgedeki karşılaştırmaya göre IP adresleri tutan bir set öğe başına yaklaşık 40 bayt kullanırken yüzde 0,01 hata oranlı bir Bloom filter öğe başına yaklaşık 2,4 bayt kullanır. Öğeleri geri okumanız, kesin üyelik bilgisi veya kümeler arası işlem gerekiyorsa set komutları doğru seçimdir.
Bu komutlar hangi Redis sürümünde var?
Redis 8.0 ve sonrasında olasılıksal yapılar Redis Open Source'un içinde gelir. Daha eski sürümlerde BF.*, CF.*, CMS.*, TOPK.* ve TDIGEST.* komutları ancak ilgili modül yüklüyse kullanılabilir.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: Redis öğrenme rehberi · HyperLogLog ile tekil sayım · Set komutları · Redis veri tipi seçimi · Redis leaderboard · Redis Search