Python'da aynı anda birden fazla iş yürütmek için üç standart araç vardır: threading tek süreç içinde, aynı belleği paylaşan iş parçacıkları açar; multiprocessing her biri kendi yorumlayıcısına sahip ayrı süreçler başlatır; concurrent.futures ise ikisinin üzerine ThreadPoolExecutor ve ProcessPoolExecutor adlı ortak, üst düzey bir havuz arayüzü kurar. Kısa kural şudur: bekleme ağırlıklı (G/Ç) işler için iş parçacıkları, işlemci ağırlıklı hesaplamalar için süreçler kullanılır; bunun nedeni CPython'daki global yorumlayıcı kilidi (GIL)'dir.
Bu yazıda GIL'in ne anlama geldiğini, iş parçacığı başlatmayı, kilit, kuyruk ve olay nesneleriyle güvenli iletişimi, havuzları, if __name__ == '__main__' korumasının neden şart olduğunu, süreç başlatma yöntemlerini ve Python 3.13 ile başlayan serbest iş parçacıklı (free-threaded) yapıyı ele alıyoruz. Örnekler Windows üzerinde Python 3.15.2 ile çalıştırıldı; süre değerleri yaklaşıktır. Serinin bütünü için Python öğrenme rehberi sayfasına bakabilirsiniz.
GIL nedir ve neden önemlidir?
threading belgesindeki CPython uygulama notuna göre, global yorumlayıcı kilidi nedeniyle aynı anda yalnızca bir iş parçacığı Python kodu çalıştırabilir (bazı performans odaklı kütüphaneler bu sınırı aşabilir). Belge, çok çekirdekli makinelerin hesaplama gücünden daha iyi yararlanmak istiyorsanız multiprocessing ya da concurrent.futures.ProcessPoolExecutor önerir; aynı anda birden çok G/Ç ağırlıklı görev çalıştırmak için ise iş parçacığı modelinin hâlâ uygun olduğunu söyler.
Bunun pratik anlamı şudur: bir iş parçacığı ağdan yanıt beklerken, diskten okurken ya da time.sleep() içindeyken diğer iş parçacıkları çalışabilir; bu yüzden indirme, API çağrısı, dosya kopyalama gibi işlerde iş parçacıkları belirgin fayda sağlar. Ama saf Python ile yazılmış bir hesaplamayı dört iş parçacığına bölmek, varsayılan yapıda hesaplamayı paralel hale getirmez. multiprocessing ise belgedeki ifadeyle iş parçacıkları yerine alt süreçler kullanarak GIL'i "yan yoldan aşar" ve makinedeki birden çok işlemciden tam olarak yararlanmayı sağlar.
| Araç | Çalışma birimi | Bellek | Uygun iş | Not |
|---|---|---|---|---|
| threading | İş parçacığı | Paylaşılır | G/Ç ağırlıklı | Paylaşılan veri kilitle korunmalı |
| multiprocessing | Süreç | Ayrı | İşlemci ağırlıklı | Argümanlar pickle ile aktarılır |
| ThreadPoolExecutor | İş parçacığı havuzu | Paylaşılır | G/Ç ağırlıklı | Future ile sonuç toplama |
| ProcessPoolExecutor | Süreç havuzu | Ayrı | İşlemci ağırlıklı | Windows'ta en fazla 61 işçi |
| asyncio | Görev (tek iş parçacığı) | Paylaşılır | Çok sayıda G/Ç | Kütüphanelerin asenkron olması gerekir |
Son satırdaki asyncio farklı bir modeldir: iş parçacığı açmadan, tek iş parçacığında görevler arasında geçiş yapar. Ayrıntılar Python asyncio, async ve await yazısında.
threading ile iş parçacığı başlatmak
Bir iş parçacığı threading.Thread(target=fonksiyon, args=(...), kwargs={...}) ile oluşturulur, start() ile başlatılır ve join() ile bitmesi beklenir. args bir tuple olmalıdır; tek argümanda sondaki virgülü unutmayın: args=(adres,). Aşağıdaki örnekte üç adet 0.5 saniyelik "indirme" aynı anda yürüdüğü için toplam süre yaklaşık 0.5 saniye oluyor. Python 3.14'ten beri Thread.start(), işletim sistemi düzeyindeki iş parçacığı adını da Thread.name değerine ayarlıyor; bu, sistem araçlarında hata ayıklamayı kolaylaştırır.
import threading
import time

sonuclar = {}

def indir(adres, sure):
    time.sleep(sure)  # ağ isteği yerine bekleme
    sonuclar[adres] = f'{adres} indirildi'

t0 = time.perf_counter()
iplikler = [threading.Thread(target=indir, args=(a, 0.5), name=f'indirici-{i}')
            for i, a in enumerate(['site-a', 'site-b', 'site-c'])]
for t in iplikler:
    t.start()
for t in iplikler:
    t.join()
print(sorted(sonuclar.values()))
print(round(time.perf_counter() - t0, 1))
print([t.name for t in iplikler])

# çıktı: ['site-a indirildi', 'site-b indirildi', 'site-c indirildi']
# çıktı: 0.5
# çıktı: ['indirici-0', 'indirici-1', 'indirici-2']
Sonuçları bir sözlükte toplayıp sonra sıraladık, çünkü iş parçacıklarının bitiş sırası garanti değildir. Ekrana doğrudan yazdıran iş parçacıklarının çıktıları her çalıştırmada farklı sırada görünebilir. Bu, eşzamanlı programlamanın temel gerçeğidir: zamanlamaya dayanan varsayımlar yapmayın.
Daemon iş parçacıkları ve düzgün durdurma
Bir iş parçacığı daemon olarak işaretlenirse, geriye yalnızca daemon iş parçacıkları kaldığında program çıkar. Belge bunların kapanışta aniden durdurulduğunu ve açık dosya gibi kaynaklarının düzgün serbest bırakılmayabileceğini uyarır; düzgün durmasını istediğiniz iş parçacıklarını daemon yapmayıp threading.Event gibi bir sinyal mekanizması kullanmanızı önerir. Aşağıdaki örnekte iş parçacığı, olay ayarlanana kadar periyodik olarak çalışıyor ve dur.set() çağrısıyla kendi döngüsünden çıkıyor.
import threading
import time

dur = threading.Event()

def nabiz():
    adim = 0
    while not dur.is_set():
        adim += 1
        dur.wait(0.1)
    print('durdu, adım sayısı > 0:', adim > 0)

t = threading.Thread(target=nabiz)
t.start()
time.sleep(0.35)
dur.set()
t.join()

# çıktı: durdu, adım sayısı > 0: True
Paylaşılan veri: Lock ile yarış koşulunu önlemek
İş parçacıkları aynı belleği paylaştığı için birden fazlası aynı değişkeni değiştirdiğinde yarış koşulu (race condition) oluşabilir. sayac += 1 gibi tek satırlık görünen bir işlem bile okuma, toplama ve yazma adımlarından oluşur; iki iş parçacığı bu adımları iç içe geçirirse güncellemelerden biri kaybolabilir. Paylaşılan durumu bir threading.Lock ile koruyun; with kilit: bloğu kilidi alır ve blok bittiğinde, istisna oluşsa bile, serbest bırakır.
import threading

sayac = 0
kilit = threading.Lock()

def artir(n):
    global sayac
    for _ in range(n):
        with kilit:
            sayac += 1

iplikler = [threading.Thread(target=artir, args=(100_000,)) for _ in range(4)]
for t in iplikler:
    t.start()
for t in iplikler:
    t.join()
print(sayac)

# çıktı: 400000
Serbest iş parçacıklı yapıya ilişkin belge de aynı öneriyi yapar: dict, list ve set gibi yerleşik tipler iç kilitlerle korunsa da, mümkün olduğunda bunlara güvenmek yerine threading.Lock veya diğer eşzamanlama araçlarını kullanmanız önerilir. Kilidi gereğinden uzun tutmak ya da iki kilidi farklı iş parçacıklarında ters sırayla almak kilitlenmeye (deadlock) yol açar; kilitli bölümü olabildiğince kısa tutun.
İş parçacıkları arasında iletişim: queue.Queue
Veri paylaşmanın en güvenli yolu çoğu zaman paylaşmamaktır: işleri bir kuyruğa koyup işçi iş parçacıklarının oradan almasını sağlarsınız. threading belgesi de queue modülünü, çalışan iş parçacıkları arasında veri alışverişi için güvenli arayüz olarak gösterir. task_done() ve join() ikilisi, kuyruğa konan her işin tamamlandığını beklemenizi sağlar; işçiyi durdurmak için kuyruğa özel bir işaret (burada None) koyarsınız.
import queue
import threading

kuyruk = queue.Queue()

def isci():
    while True:
        oge = kuyruk.get()
        if oge is None:
            break
        print('işlendi:', oge)
        kuyruk.task_done()

t = threading.Thread(target=isci)
t.start()
for oge in ['rapor.pdf', 'fatura.pdf']:
    kuyruk.put(oge)
kuyruk.join()
kuyruk.put(None)
t.join()
print('hepsi bitti')

# çıktı: işlendi: rapor.pdf
# çıktı: işlendi: fatura.pdf
# çıktı: hepsi bitti
concurrent.futures: ThreadPoolExecutor
İş parçacıklarını tek tek yönetmek yerine çoğu durumda bir havuz kullanmak daha pratiktir. ThreadPoolExecutor, belirli sayıda işçi iş parçacığı açar ve işleri onlara dağıtır. map() sonuçları girdi sırasıyla döndürür; submit() ise her iş için bir Future nesnesi verir ve as_completed() bu nesneleri bittikleri sırayla üretir. with bloğundan çıkılırken havuz, işlerin bitmesini bekleyerek kapatılır.
import time
from concurrent.futures import ThreadPoolExecutor, as_completed

def yavas_kare(x):
    time.sleep(0.2)
    return x * x

with ThreadPoolExecutor(max_workers=4) as havuz:
    print(list(havuz.map(yavas_kare, [1, 2, 3, 4])))
    gelecekler = {havuz.submit(yavas_kare, x): x for x in [5, 6]}
    sonuc = {gelecekler[f]: f.result() for f in as_completed(gelecekler)}
    print(sorted(sonuc.items()))

# çıktı: [1, 4, 9, 16]
# çıktı: [(5, 25), (6, 36)]
max_workers verilmezse varsayılan değer Python 3.13'ten beri min(32, (os.process_cpu_count() or 1) + 4) olarak hesaplanır. Belge bu değerin G/Ç işleri için en az 5 işçi bıraktığını ve çok çekirdekli makinelerde örtük olarak aşırı kaynak kullanımını önlediğini açıklar. Havuzla ilgili belgelenmiş bir tuzak da vardır: havuzdaki bir iş, aynı havuza gönderilmiş başka bir işin sonucunu beklerse ve boşta işçi kalmamışsa kilitlenme oluşur. Örneğin tek işçili bir havuzda çalışan bir fonksiyon, aynı havuza yeni bir iş gönderip result() beklerse sonsuza kadar bekler.
multiprocessing ve ProcessPoolExecutor
İşlemci ağırlıklı işler için süreç havuzu kullanılır. API, iş parçacığı havuzuyla neredeyse aynıdır; fark, her işçinin ayrı bir Python süreci olmasıdır. Bu yüzden fonksiyon ve argümanlar süreçler arasında pickle ile aktarılır ve belgeye göre tüm argümanların pickle edilebilir olması gerekir. ProcessPoolExecutor için max_workers verilmezse varsayılan os.process_cpu_count() değeridir; Windows'ta bu sayı en fazla 61 olabilir.
from concurrent.futures import ProcessPoolExecutor

def asal_say(sinir):
    sayi = 0
    for n in range(2, sinir):
        if all(n % b for b in range(2, int(n ** 0.5) + 1)):
            sayi += 1
    return sayi

if __name__ == '__main__':
    with ProcessPoolExecutor() as havuz:
        print(list(havuz.map(asal_say, [10, 100, 1000, 10000])))

# çıktı: [4, 25, 168, 1229]
multiprocessing modülünün kendi Pool sınıfı da aynı işi görür; belgedeki temel örnek şöyledir:
from multiprocessing import Pool

def f(x):
    return x * x

if __name__ == '__main__':
    with Pool(3) as p:
        print(p.map(f, [1, 2, 3]))

# çıktı: [1, 4, 9]
multiprocessing belgesi, concurrent.futures.ProcessPoolExecutor arayüzünün işlerin gönderilmesini sonuçların beklenmesinden daha kolay ayırdığını belirtir. Yeni kodda genellikle concurrent.futures ile başlamak, gerektiğinde multiprocessing'in paylaşılan bellek, yönetici (Manager) ve süreç sonlandırma gibi ek özelliklerine geçmek pratik bir yoldur. Python 3.15'te ProcessPoolExecutor içindeki bir işçi süreç beklenmedik biçimde sonlandığında üretilen hata kaydı, artık ölen sürecin PID değerini ve çıkış kodunu da gösteriyor.
if __name__ == '__main__' koruması neden şart?
Windows ve macOS'ta varsayılan süreç başlatma yöntemi spawn'dır: alt süreç yepyeni bir Python yorumlayıcısı başlatır ve ana modülü içe aktarır. Ana modülün en üst düzeyinde süreç başlatan kod korumasız durursa, alt süreç modülü içe aktarırken aynı kodu yeniden çalıştırmaya kalkar. Belgenin "Safe importing of main module" bölümüne göre bu durum RuntimeError ile sonuçlanır. Aşağıdaki korumasız örnek Windows'ta tam olarak bu hatayı veriyor ve "merhaba" hiç yazılmıyor.
from multiprocessing import Process

def foo():
    print('merhaba')

p = Process(target=foo)
p.start()
p.join()

# Windows ve macOS'ta (spawn) çıktının son satırları:
# RuntimeError:
#         An attempt has been made to start a new process before the
#         current process has finished its bootstrapping phase.
#         ...
#             if __name__ == '__main__':
#                 freeze_support()
#                 ...
Çözüm, süreç başlatan kodu if __name__ == '__main__': bloğunun içine almaktır; yukarıdaki th5 ve th6 örnekleri bu yüzden çalışıyor. Bu ifadenin genel anlamı Python modül ve paket import yazısında anlatılıyor. Bir diğer klasik hata da lambda ya da iç içe tanımlanmış fonksiyon göndermektir; bunlar pickle edilemez:
from concurrent.futures import ProcessPoolExecutor

if __name__ == '__main__':
    with ProcessPoolExecutor(max_workers=2) as havuz:
        try:
            print(list(havuz.map(lambda x: x * 2, [1, 2])))
        except Exception as e:
            print(type(e).__name__ + ':', str(e).split(': ', 1)[1])

# çıktı: PicklingError: it's not found as __main__.<lambda>
Süreç başlatma yöntemleri: spawn, fork, forkserver
Belge üç başlatma yöntemi tanımlar. spawn yeni bir yorumlayıcı başlatır ve yalnızca gerekli kaynakları devralır; diğerlerine göre daha yavaştır, Windows ve macOS'ta varsayılandır. fork mevcut süreci os.fork() ile kopyalar; alt süreç ebeveynin bütün kaynaklarını devralır ve belgeye göre çok iş parçacıklı bir süreci güvenle fork etmek sorunludur. forkserver ise başta tek iş parçacıklı bir sunucu süreç başlatır ve yeni süreçleri ondan fork ettirir.
Burada önemli bir sürüm değişikliği var: Python 3.14 What's New belgesine göre macOS dışındaki Unix platformlarında varsayılan yöntem fork yerine forkserver oldu; fork artık hiçbir platformda varsayılan değil. Eski davranışa ihtiyaç duyan kodun bunu get_context('fork') ya da set_start_method() ile açıkça istemesi gerekiyor. Belgeye göre Python 3.15.1 ile, yazılabilir geçici dizin bulunmayan sistemlerde (örneğin salt okunur dosya sistemi) varsayılan yöntem spawn oluyor. Linux sunucuda geliştirip Windows'ta çalıştırdığınız ya da tersini yaptığınız kodda en güvenli yol, her platformda spawn varmış gibi yazmaktır: koruma bloğu kullanın ve argümanları pickle edilebilir tutun.
import multiprocessing
import sys
import sysconfig

print(sys._is_gil_enabled())
print(sysconfig.get_config_var('Py_GIL_DISABLED'))
print(multiprocessing.get_start_method())

# çıktı: True
# çıktı: 0
# çıktı: spawn
Serbest iş parçacıklı Python (GIL'siz yapı)
Python 3.13 ile CPython'un GIL'i devre dışı bırakılmış özel bir yapısı (free-threaded build) sunuldu; Python 3.14 What's New belgesine göre bu yapı artık resmî olarak destekleniyor (PEP 779). Bu yapıda iş parçacıkları mevcut çekirdeklerde gerçekten paralel çalışabilir. Belgenin vurguladığı gibi bu her yazılımı kendiliğinden hızlandırmaz, ama iş parçacıklarıyla tasarlanmış programlar çok çekirdekli donanımda daha hızlı çalışır. Python 3.15 ile resmî macOS paketleri serbest iş parçacıklı desteği varsayılan olarak kuruyor; Windows ve macOS yükleyicileri 3.13'ten beri bunu isteğe bağlı olarak sunuyor.
Çalışan yorumlayıcının hangi yapıda olduğunu anlamak için belge şu yolları verir: python -VV ve sys.version çıktısında "free-threading build" ifadesi görünür; sysconfig.get_config_var("Py_GIL_DISABLED") değeri 1 ise yapı serbest iş parçacıklıdır; sys._is_gil_enabled() ise GIL'in o anda gerçekten kapalı olup olmadığını söyler. Yukarıdaki th7 örneğini standart yapıda çalıştırdığımız için GIL açık ve değer 0 görünüyor. Serbest yapıda GIL, PYTHON_GIL ortam değişkeni ya da -X gil seçeneğiyle yeniden açılabilir; serbest iş parçacıklı çalışmayı desteklediği işaretlenmemiş bir C eklentisi içe aktarıldığında da bir uyarıyla otomatik olarak açılabilir.
Belge bilinen sınırlamaları da listeler: tek iş parçacıklı kodda ek bir yük vardır (pyperformance ölçümlerinde ortalama, platforma göre yaklaşık yüzde 1 ile yüzde 8 arası), bazı nesneler "ölümsüz" yapılır ve aynı iterator nesnesine birden çok iş parçacığından erişmek güvenli değildir. Son madde için Python 3.15, threading modülüne serialize_iterator, synchronized_iterator() ve concurrent_tee() araçlarını ekledi; kullanımları Python generator ve yield yazısında gösteriliyor.
Hangi aracı seçmeliyim?
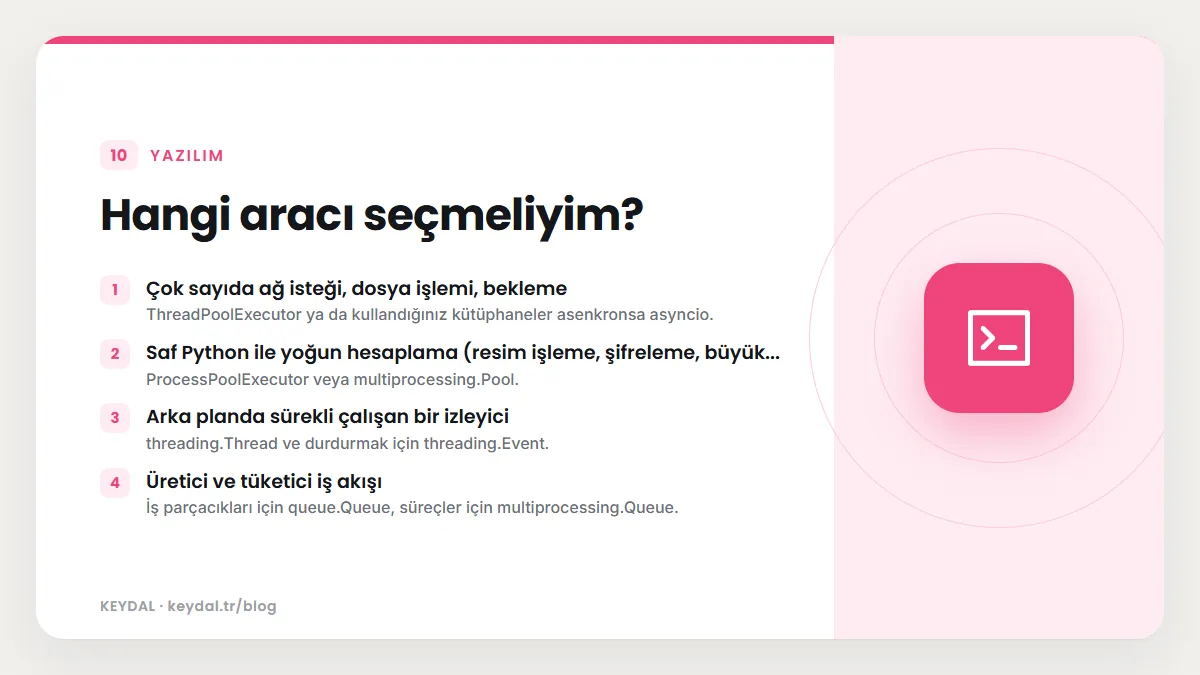
- Çok sayıda ağ isteği, dosya işlemi, bekleme:
ThreadPoolExecutorya da kullandığınız kütüphaneler asenkronsaasyncio. - Saf Python ile yoğun hesaplama (resim işleme, şifreleme, büyük döngüler):
ProcessPoolExecutorveyamultiprocessing.Pool. - Arka planda sürekli çalışan bir izleyici:
threading.Threadve durdurmak içinthreading.Event. - Üretici ve tüketici iş akışı: İş parçacıkları için
queue.Queue, süreçler içinmultiprocessing.Queue. - Aynı süreçte bağımsız yorumlayıcılar: Python 3.14 ile gelen
concurrent.futures.InterpreterPoolExecutorileri bir seçenektir; alt yorumlayıcı (subinterpreter) havuzu kullanır.
Sık yapılan hatalar
- İşlemci yoğun işi iş parçacıklarına bölmek: Varsayılan yapıda GIL nedeniyle paralel çalışmaz; süreç havuzu kullanın.
- Koruma bloğunu unutmak: spawn kullanan platformlarda
RuntimeErroralırsınız. - Lambda veya iç fonksiyon göndermek: Süreç havuzları pickle kullanır; fonksiyonu modülün en üst düzeyinde tanımlayın.
- Paylaşılan değişkeni kilitsiz güncellemek: Güncellemeler kaybolabilir;
Lockya daQueuekullanın. - join() çağırmamak: Ana program sonuçlar hazır olmadan devam eder; havuzlarda
withbloğu bunu sizin yerinize yapar. - args=(x) yazmak: Bu bir tuple değildir;
args=(x,)yazın. - fork'un hâlâ varsayılan olduğunu varsaymak: 3.14'ten beri Linux'ta varsayılan
forkserver; global değişkenlerin alt sürece kopyalanacağına güvenen kod bozulabilir.
Sık Sorulan Sorular
Python'da gerçek paralellik mümkün mü?
Evet. Süreçler (multiprocessing, ProcessPoolExecutor) her zaman paralel çalışabilir, çünkü her birinin kendi yorumlayıcısı ve GIL'i vardır. Serbest iş parçacıklı yapıda iş parçacıkları da paralel çalışabilir. Varsayılan yapıda iş parçacıkları G/Ç beklemelerini örtüştürür ama Python kodunu aynı anda yalnızca biri çalıştırır.
Kaç işçi kullanmalıyım?
Varsayılan değerler iyi bir başlangıçtır: süreç havuzu için işlemci sayısı, iş parçacığı havuzu için yukarıdaki formül. G/Ç ağırlıklı işlerde daha fazla iş parçacığı fayda sağlayabilir, ama karşı tarafın (API, veritabanı) sınırlarını da göz önünde tutun. Kendi iş yükünüzde ölçerek karar verin.
Hataları iş parçacığından nasıl alırım?
Düz Thread içinde oluşan istisna ana iş parçacığına kendiliğinden geçmez. concurrent.futures kullanırsanız, iş sırasında oluşan istisna future.result() çağrıldığında yeniden yükseltilir; bu, hataları yakalamayı çok kolaylaştırır. İstisnaları kaydetmek için Python logging modülü iş parçacığı adını da log satırına ekleyebilir.
Web uygulamalarında bunları kendim mi yönetmeliyim?
Çoğu zaman hayır. Uygulama sunucuları işçi süreçlerini ve iş parçacıklarını kendisi yönetir; örneğin Django uygulamasını Gunicorn ve Nginx ile yayına alma yazısında işçi süreçlerinin nasıl ayarlandığını görebilirsiniz. Kendi kodunuzda havuz açmak, genellikle arka plan işleri ve komut satırı betikleri için gerekir.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: Python öğrenme rehberi · asyncio, async ve await · Generator ve yield · Modül ve paket import · logging modülü · Python 3.15 yenilikleri