PostgreSQL'de sık kullanılan veri tipleri şunlardır: tam sayılar için integer (gerekiyorsa bigint), para ve kesinlik isteyen ondalıklar için numeric(p,s), yaklaşık bilimsel değerler için double precision, metin için text (uzunluk sınırı iş kuralıysa varchar(n)), doğru/yanlış için boolean, dağıtık benzersiz kimlik için uuid, sabit değer listeleri için enum ve ham baytlar için bytea. money tipi locale'e bağlı olduğu için yeni tasarımlarda numeric tercih edilmelidir.
Bu yazıda kılavuzun Data Types bölümündeki sayısal, karakter, boolean, UUID, enum, ikili veri ve para tipi sayfalarını; PostgreSQL 18 ile gelen uuidv7() fonksiyonu dahil, PostgreSQL 18.1 üzerinde çalıştırdığımız örneklerle anlatıyoruz. Tarih ve saat tipleri tarih, saat ve timezone, JSON JSONB kullanımı, diziler array tipi yazısında ayrıca ele alınıyor. Serinin geri kalanı PostgreSQL öğrenme rehberi sayfasında. Çıktılarda yer kazanmak için CREATE ve INSERT gibi komutların onay satırlarını yer yer çıkardık; sorgu sonuçları ve hata mesajları olduğu gibidir.
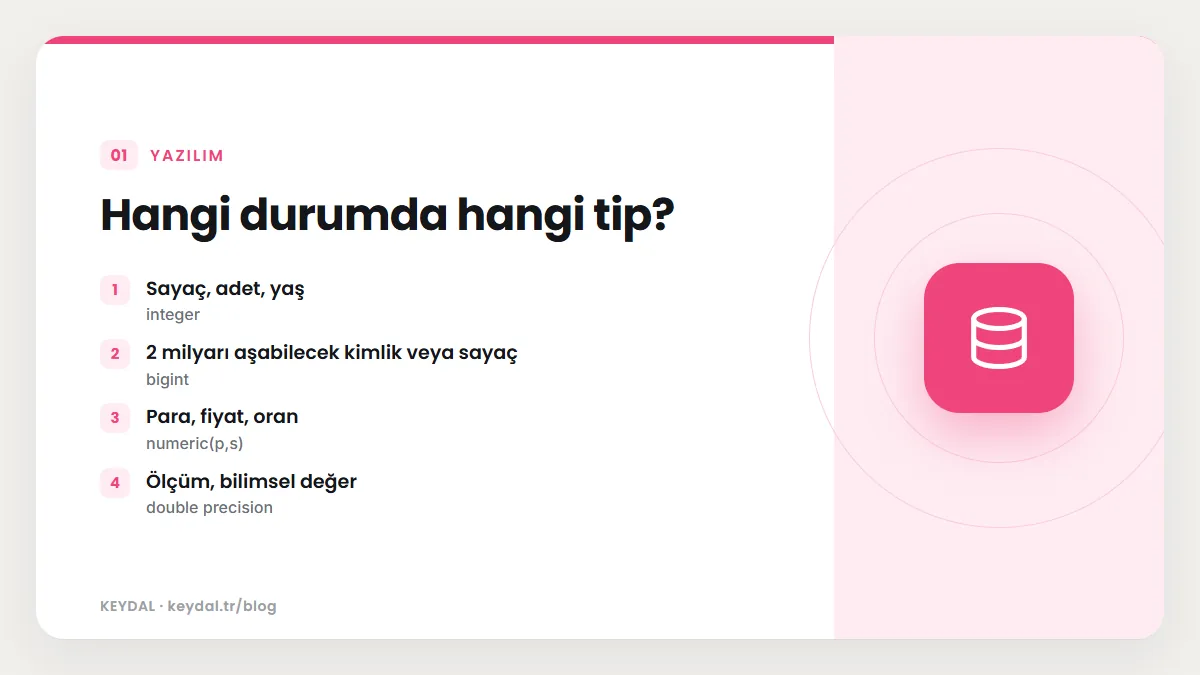
Hangi durumda hangi tip?
| İhtiyaç | Önerilen tip | Kaçınılacak | Neden |
|---|---|---|---|
| Sayaç, adet, yaş | integer | numeric | integer hız, boyut ve aralık dengesi en iyi seçenek |
| 2 milyarı aşabilecek kimlik veya sayaç | bigint | integer | integer en fazla 2147483647 tutar |
| Para, fiyat, oran | numeric(p,s) | real, double precision, money | Kesin ondalık hesap gerekir |
| Ölçüm, bilimsel değer | double precision | numeric (performans gerekiyorsa) | Yaklaşık ama hızlı |
| Serbest metin | text | char(n) | char(n) boşlukla doldurur ve genellikle en yavaşıdır |
| Uzunluk sınırı iş kuralı | varchar(n) veya text ile CHECK | char(n) | Sınır aşıldığında hata verilir |
| Evet/hayır | boolean | char(1), integer | Üç durum: true, false, NULL |
| Dağıtık sistemde kimlik | uuid (uuidv7) | text | uuid 16 bayttır ve biçimi doğrulanır |
| Az ve sabit değer listesi | enum veya CHECK | serbest text | Geçersiz değer reddedilir |
| Dosya, şifreli veri, ham bayt | bytea | text | Metin tipi sıfır baytı ve geçersiz kodlamayı kabul etmez |
Tam sayılar: smallint, integer, bigint
PostgreSQL'de üç tam sayı tipi vardır: 2 baytlık smallint (-32768 ile 32767), 4 baytlık integer (yaklaşık artı eksi 2,1 milyar) ve 8 baytlık bigint. Belgeye göre aralık, boyut ve performans arasında en iyi dengeyi integer verir; smallint genellikle yalnızca disk alanı çok kıymetliyse, bigint ise integer aralığı yetmediğinde kullanılır. Aralık dışı bir değer saklanmaya çalışıldığında hata verilir, sessiz taşma olmaz:
SELECT 2147483647::integer + 1;
SELECT 2147483647::bigint + 1 AS bigint_sonuc;
SELECT 7 / 2 AS tamsayi_bolme, 7 / 2.0 AS ondalik_bolme;psql:vtip1.sql:2: ERROR: integer out of range
bigint_sonuc
--------------
2147483648
(1 row)
tamsayi_bolme | ondalik_bolme
---------------+--------------------
3 | 3.5000000000000000
(1 row)İki tam sayının bölümü tam sayıdır ve kesirli kısım atılır; ondalıklı sonuç istiyorsanız işlenenlerden birini numeric yapmanız gerekir. int2, int4, int8 adları bu tiplerin PostgreSQL'e özgü takma adlarıdır. Otomatik artan kimlik sütunları için serial kısayolu ya da standart identity sütunları kullanılır; ikisinin farkı identity, serial ve sequence yazısında.
numeric: kesin ondalık sayılar
numeric çok sayıda basamağı kesin olarak saklar ve belge onu özellikle para ve kesinlik gereken diğer miktarlar için önerir; toplama, çıkarma ve çarpma kesin sonuç verir. Bedeli hızdır: belgeye göre numeric hesapları tam sayı ve kayan noktalı tiplere göre çok yavaştır. decimal ile numeric aynı tiptir. numeric(p, s) tanımında hassasiyet (p) toplam anlamlı basamak sayısı, ölçek (s) ise ondalık kısmın basamak sayısıdır; 23.5141 sayısının hassasiyeti 6, ölçeği 4'tür. Ölçekten fazla ondalık basamak yuvarlanır, tam kısım p - s basamağı aşarsa hata verilir:
CREATE TABLE fiyat_deneme (deger numeric(5,2));
INSERT INTO fiyat_deneme VALUES (12.345), (12.355), (999.994);
INSERT INTO fiyat_deneme VALUES (999.995);
SELECT deger FROM fiyat_deneme;INSERT 0 3
psql:vtip1.sql:8: ERROR: numeric field overflow
DETAIL: A field with precision 5, scale 2 must round to an absolute value less than 10^3.
deger
--------
12.35
12.36
999.99
(3 rows)999.995 değeri iki ondalığa yuvarlanınca 1000.00 olur ve numeric(5,2) en fazla üç tam basamak tuttuğu için reddedildi. Hassasiyet ve ölçek vermeden yazılan numeric, uygulama sınırlarına kadar her uzunlukta değeri kabul eden sınırsız bir sütundur ve değerleri belirli bir ölçeğe zorlamaz. Belge taşınabilirlik kaygınız varsa hassasiyet ve ölçeği her zaman açıkça yazmanızı önerir; açıkça yazılabilecek en büyük hassasiyet 1000'dir. PostgreSQL 15'ten beri negatif ölçek de kabul edilir: numeric(2, -3) değerleri en yakın bine yuvarlar. Değerler başta ve sonda fazladan sıfır olmadan saklanır, yani tanımdaki hassasiyet bir üst sınırdır, sabit bir yer ayırımı değildir.
numeric ile double precision farkı
real ve double precision IEEE 754 kayan noktalı tiplerdir ve belgede kesin olmayan (inexact) tipler olarak tanımlanır: bazı değerler iç biçime tam dönüştürülemez ve yaklaşık saklanır. Belge, kesin saklama ve hesap gerekiyorsa (para gibi) numeric kullanılmasını, iki kayan noktalı değerin eşitlik karşılaştırmasının her zaman beklendiği gibi çalışmayabileceğini açıkça belirtir:
SELECT 0.1::float8 + 0.2::float8 AS float_toplam,
       0.1::numeric + 0.2::numeric AS numeric_toplam,
       0.1::float8 + 0.2::float8 = 0.3::float8 AS float_esit_mi;
SELECT x, round(x::numeric) AS numeric_yuvarla, round(x::double precision) AS float_yuvarla
FROM (VALUES (0.5), (1.5), (2.5)) AS t(x); float_toplam | numeric_toplam | float_esit_mi
---------------------+----------------+---------------
0.30000000000000004 | 0.3 | f
(1 row)
x | numeric_yuvarla | float_yuvarla
-----+-----------------+---------------
0.5 | 1 | 0
1.5 | 2 | 2
2.5 | 3 | 2
(3 rows)İkinci sorgu belgedeki bir ayrıntıyı doğruluyor: numeric yarımları sıfırdan uzağa yuvarlar (0.5 sonucu 1, 2.5 sonucu 3), real ve double precision ise çoğu makinede yarımları en yakın çift sayıya yuvarlar (0.5 sonucu 0, 2.5 sonucu 2). Fatura toplamı gibi hesaplarda bu fark kuruş farkı yaratabilir. real en az 6, double precision en az 15 basamak hassasiyet sağlar. Her iki tip ve numeric, tırnak içinde yazılan 'Infinity', '-Infinity' ve 'NaN' özel değerlerini de destekler. Standart IEEE kuralının aksine PostgreSQL, sıralama ve indekslemeyi mümkün kılmak için NaN değerlerini birbirine eşit ve bütün sayılardan büyük sayar:
SELECT 'NaN'::numeric > 1000000 AS nan_buyuk_mu, 'Infinity'::numeric - 'Infinity'::numeric AS fark; nan_buyuk_mu | fark
--------------+------
t | NaN
(1 row)Metin tipleri: text, varchar(n), char(n)
PostgreSQL'in yerel metin tipi text'tir ve her uzunlukta metin saklar; yerleşik metin fonksiyonlarının çoğu text alıp döndürür. SQL standardındaki character varying(n) (varchar(n)) ve character(n) (char(n)) tipleri en fazla n karakter saklar; dikkat, bayt değil karakter. Uzunluk belirtilmeyen varchar her uzunluğu kabul eder, uzunluk belirtilmeyen char ise char(1) demektir. Belirtilebilecek en büyük n 10.485.760'tır; saklanabilecek en uzun metin ise yaklaşık 1 GB'tır.
Uzunluk kurallarında standardın iki tuhaf istisnası vardır ve belge ikisini de açıkça yazar: sınırı aşan metin hata verir, ama aşan kısım yalnızca boşluklardan oluşuyorsa hata vermeden kesilir; metni açıkça varchar(n) tipine dönüştürürseniz (cast) de hata yerine sessizce kesilir:
CREATE TABLE metin_deneme (kisa varchar(5), sabit char(5), serbest text);
INSERT INTO metin_deneme VALUES ('Kars', 'Kars', 'Kars');
INSERT INTO metin_deneme VALUES ('Eskişehir', 'Van', 'Eskişehir');
INSERT INTO metin_deneme VALUES ('Eskişehir'::varchar(5), 'Van', 'Eskişehir');
INSERT INTO metin_deneme VALUES ('Muş     ', 'Muş', 'Muş');
SELECT kisa, char_length(kisa) AS k_uzunluk, sabit, char_length(sabit) AS s_uzunluk,
octet_length(sabit) AS s_bayt, serbest FROM metin_deneme;INSERT 0 1
psql:vtip1.sql:20: ERROR: value too long for type character varying(5)
INSERT 0 1
INSERT 0 1
kisa | k_uzunluk | sabit | s_uzunluk | s_bayt | serbest
-------+-----------+-------+-----------+--------+-----------
Kars | 4 | Kars | 4 | 5 | Kars
Eskiş | 5 | Van | 3 | 5 | Eskişehir
Muş | 5 | Muş | 3 | 6 | Muş
(3 rows)Sonuçları tek tek okuyalım. Eskişehir doğrudan eklenince hata verdi, açık dönüşümle eklenince sessizce Eskiş olarak kesildi; bu yüzden uygulama kodunda ::varchar(n) dönüşümünü veri doğrulama sanmayın. Sonunda beş boşluk olan Muş hata vermedi, fazla boşluklar kesildi ve değer boşluklarıyla beş karakter oldu. char(5) sütunu değerleri beş karaktere kadar boşlukla doldurur, ama char_length sondaki boşlukları saymaz. octet_length ise bayt sayar: UTF-8'de ş iki bayt olduğu için Muş için 6 bayt çıktı. Uzunluk sınırı karakter cinsinden olduğu için Türkçe metinlerde bayt hesabı yapmanız gerekmez, ama bayt cinsinden sınırı olan bir dış sistemle çalışıyorsanız bu farkı aklınızda tutun.
char(n) sondaki boşlukları anlamsız sayar ve karşılaştırmalarda yok sayar; text ve varchar ise sondaki boşlukları anlamlı kabul eder:
SELECT 'Kars '::char(5) = 'Kars'::char(5) AS char_esit, 'Kars '::text = 'Kars'::text AS text_esit; char_esit | text_esit
-----------+-----------
t | f
(1 row)Belgenin performans notu nettir: bu üç tip arasında, boşluk doldurmanın ek depolaması ve uzunluk kontrolünün birkaç işlemci döngüsü dışında performans farkı yoktur; char(n) diğer bazı sistemlerde avantajlı olsa da PostgreSQL'de ek depolama yüzünden genellikle en yavaşıdır. Çoğu durumda text veya varchar önerilir. Uzunluk sınırını yalnızca gerçek bir iş kuralıysa koyun; keyfi bir üst sınır yerine sınırsız text kullanmak belgede açıkça önerilir. Metinlerde sıfır kodlu (NUL) karakter saklanamaz. Metin fonksiyonları ve desen eşleme için string fonksiyonları, Türkçe sıralama ve büyük harf dönüşümü için collation yazısına bakın.
boolean: üç durumlu mantık
boolean 1 bayt yer kaplar ve üç durumu vardır: doğru, yanlış ve bilinmeyen (NULL). SQL'de tercih edilen yazım TRUE ve FALSE anahtar kelimeleridir. Metinden dönüşümde doğru için true, yes, on, 1, yanlış için false, no, off, 0 kabul edilir; bu kelimelerin benzersiz önekleri, büyük/küçük harf farkı ve baştaki ile sondaki boşluklar da sorun değildir. Çıktı her zaman t veya f olur. Türkçe kelimeler kabul edilmez:
SELECT 'yes'::boolean AS a, 'off'::boolean AS b, ' T '::boolean AS c, '1'::boolean AS d;
SELECT 'evet'::boolean; a | b | c | d
---+---+---+---
t | f | t | t
(1 row)
psql:vtip1.sql:28: ERROR: invalid input syntax for type boolean: "evet"
LINE 1: SELECT 'evet'::boolean;
^Formdan gelen evet/hayır gibi değerleri uygulama katmanında true ve false değerine çevirin. NULL değerin bilinmeyen anlamına geldiğini unutmayın: WHERE aktif = false koşulu NULL olan satırları getirmez; bunlar için IS NOT TRUE gibi bir koşul gerekir. Sütunun hiçbir zaman bilinmeyen olmaması gerekiyorsa NOT NULL DEFAULT false ile tanımlayın.
uuid ve PostgreSQL 18 ile gelen uuidv7()
uuid tipi RFC 9562 ve ilgili standartlarda tanımlanan 128 bitlik evrensel benzersiz kimlikleri saklar. Belgeye göre bu kimlikler, yalnızca tek bir veritabanında benzersiz olan sequence üreticilerine göre dağıtık sistemlerde daha iyi bir benzersizlik garantisi verir. Değer büyük harfle, süslü parantez içinde veya tireler eksik yazılsa da kabul edilir ve çıktı her zaman küçük harfli standart biçimdedir:
SELECT '{A0EEBC99-9C0B-4EF8-BB6D-6BB9BD380A11}'::uuid AS standart_bicim;
SELECT gen_random_uuid() AS v4, uuidv7() AS v7; standart_bicim
--------------------------------------
a0eebc99-9c0b-4ef8-bb6d-6bb9bd380a11
(1 row)
v4 | v7
--------------------------------------+--------------------------------------
1d73984a-072f-4428-8adb-c455712c2f1e | 01a1b558-0b9f-7131-a979-89c6a02c4c42
(1 row)Rastgele değerler her çalıştırmada farklı çıkar. PostgreSQL yerleşik olarak iki üretim algoritması sunar: gen_random_uuid() ve onun PostgreSQL 18'de eklenen açık adlı takma adı uuidv4() rastgele (sürüm 4) değer üretir; yine PostgreSQL 18 ile gelen uuidv7() ise zamana göre sıralı (sürüm 7) değer üretir. Sürüm notları uuidv7() değerlerinin zamansal olarak sıralanabilir olduğunu vurgular; fonksiyon belgesine göre değer milisaniye hassasiyetli UNIX zaman damgası, milisaniyenin altındaki zaman ve rastgele bitlerden oluşur. Yukarıdaki iki değerin farkı da buradan gelir: v7 değeri zamanla artan bir önekle başlar. İsteğe bağlı interval parametresi zaman damgasını kaydırır:
SELECT uuid_extract_version(gen_random_uuid()) AS v4, uuid_extract_version(uuidv7()) AS v7;
CREATE TABLE olay (id uuid DEFAULT uuidv7() PRIMARY KEY, ad text);
INSERT INTO olay (ad) VALUES ('giriş'), ('sepete ekleme'), ('ödeme');
SELECT ad, uuid_extract_timestamp(id) <= now() AS gecmiste FROM olay ORDER BY id;
SELECT uuidv7(interval '-1 day') < uuidv7() AS kaydirilmis_once; v4 | v7
----+----
4 | 7
(1 row)
CREATE TABLE
INSERT 0 3
ad | gecmiste
---------------+----------
giriş | t
sepete ekleme | t
ödeme | t
(3 rows)
kaydirilmis_once
------------------
t
(1 row)uuid_extract_version sürümü, uuid_extract_timestamp ise sürüm 1 veya 7 bir UUID'nin içindeki zaman damgasını timestamptz olarak döndürür; belge bu zamanın üretim anına tam eşit olmayabileceğini, üreten uygulamaya bağlı olduğunu belirtir. Kimliğin içinde zaman bilgisi taşıması, kimliği dışarıya gösterdiğiniz durumlarda kaydın ne zaman oluştuğunun da görülebileceği anlamına gelir; bunu tasarım kararınızda hesaba katın. Kılavuzda bunların dışında başka algoritmalar için uuid-ossp modülünün bulunduğu da belirtilir. 18.6 sürüm notlarında uuidv7() için aralık dışı zaman kaydırma değerlerinin reddedilmesini sağlayan bir düzeltme yer alıyor.
enum: sabit ve sıralı değer listeleri
Sayılan (enum) tipler, sabit ve sıralı bir değer kümesinden oluşur ve CREATE TYPE ... AS ENUM ile tanımlanır. Değerlerin sırası tanımdaki sıradır; karşılaştırma operatörleri ve min/max gibi toplama fonksiyonları bu sıraya göre çalışır. Listede olmayan bir değer reddedilir:
CREATE TYPE siparis_durumu AS ENUM ('alındı', 'hazırlanıyor', 'kargoda', 'teslim edildi');
CREATE TABLE gonderi (no integer, durum siparis_durumu);
INSERT INTO gonderi VALUES (1, 'kargoda'), (2, 'alındı'), (3, 'teslim edildi');
INSERT INTO gonderi VALUES (4, 'iptal');
SELECT no, durum FROM gonderi WHERE durum < 'teslim edildi' ORDER BY durum;
ALTER TYPE siparis_durumu ADD VALUE 'iade' AFTER 'teslim edildi';
SELECT enum_range(NULL::siparis_durumu);INSERT 0 3
psql:vtip2.sql:5: ERROR: invalid input value for enum siparis_durumu: "iptal"
LINE 1: INSERT INTO gonderi VALUES (4, 'iptal');
^
no | durum
----+---------
2 | alındı
1 | kargoda
(2 rows)
ALTER TYPE
enum_range
----------------------------------------------------
{alındı,hazırlanıyor,kargoda,"teslim edildi",iade}
(1 row)ORDER BY durum alfabetik değil tanım sırasına göre sıraladı. Belgedeki kurallar: etiketler büyük/küçük harfe ve boşluklara duyarlıdır, her enum değeri diskte 4 bayt kaplar, etiket uzunluğu standart derlemelerde en fazla 63 bayttır. Var olan bir enum'a yeni değer eklenebilir ve değerler yeniden adlandırılabilir, ama bir değer silinemez ve sıralama değiştirilemez; bunun için tipi silip yeniden oluşturmak gerekir. Her enum tipi ayrıdır ve başka bir enum tipiyle doğrudan karşılaştırılamaz. Değer listesinin sık değişeceğini düşünüyorsanız ayrı bir arama tablosu ve yabancı anahtar ya da CHECK kısıtı daha esnektir.
bytea: ham ikili veri
bytea bayt dizilerini saklar. Belge onu metin tiplerinden iki noktada ayırır: ikili diziler sıfır baytı ve yazdırılamayan baytları saklayabilir, metin tipleri ise sıfır baytı ve veritabanı kodlamasına göre geçersiz bayt dizilerini kabul etmez; ayrıca ikili işlemler locale'e değil gerçek baytlara göre çalışır. Varsayılan çıktı biçimi, her baytı iki onaltılık basamakla gösteren ve \x ile başlayan hex biçimidir. PostgreSQL 18 sürüm notlarına göre tam sayı tipleri ile bytea arasında dönüşüm (ikiye tümleyen biçiminde) ve baytları ters çeviren reverse() fonksiyonu eklendi:
SELECT '\xDEADBEEF'::bytea AS hex_girdi, convert_to('Ağrı', 'UTF8') AS utf8_baytlari,
       octet_length(convert_to('Ağrı', 'UTF8')) AS bayt_sayisi;
SELECT 258::integer::bytea AS int_bytea, reverse('\x010203'::bytea) AS ters; hex_girdi | utf8_baytlari | bayt_sayisi
------------+----------------+-------------
\xdeadbeef | \x41c49f72c4b1 | 6
(1 row)
int_bytea | ters
------------+----------
\x00000102 | \x030201
(1 row)Dört harfli Ağrı kelimesi UTF-8'de 6 bayt tuttu, çünkü ğ ve ı ikişer bayttır. 258 sayısı 4 baytlık integer olduğu için dört bayt olarak (00 00 01 02) göründü. Belge eski escape biçiminin yeni uygulamalarda kullanılmamasını önerir. Büyük dosyaları veritabanında mı yoksa dosya sisteminde mi tutacağınız ayrı bir mimari karardır; veritabanında tutulacaksa tip bytea olmalıdır, text değil.
money: neden önerilmez?
money tipi sabit ondalık hassasiyetli bir para tutarı saklar, ama ondalık hassasiyeti ve çıktı biçimi veritabanının lc_monetary ayarına bağlıdır. Belge bu yüzden lc_monetary değeri farklı bir veritabanına money verisi yüklemenin çalışmayabileceğini, bir döküm geri yüklenmeden önce bu ayarın aynı olması gerektiğini belirtir. Ayrıca money bir tam sayıya bölündüğünde kesirli kısım sıfıra doğru kesilir, yuvarlanmaz:
SHOW lc_monetary;
SELECT 1234.5::money AS para, 1234.5::money::numeric AS sayi;
SELECT 100::money / 6 AS money_bolme, round(100::numeric / 6, 2) AS numeric_bolme;
SET lc_monetary = 'tr-TR';
SELECT 1234.5::money AS para_tr; lc_monetary
-------------
C
(1 row)
para | sayi
-----------+---------
$1,234.50 | 1234.50
(1 row)
money_bolme | numeric_bolme
-------------+---------------
$16.66 | 16.67
(1 row)
SET
para_tr
-----------
?1.234,50
(1 row)Üç sorun aynı anda görünüyor: C locale'inde tutar dolar işaretiyle yazıldı; bölme 16.67 yerine 16.66 verdi; Türkçe locale'e geçince basamak ayırıcıları değişti ve bu Windows denemesinde para simgesi bile doğru görüntülenemedi (soru işareti çıktı). Uygulamalar ise genellikle tutarı biçimlendirilmiş metin olarak değil sayı olarak okumak ister. money değeri numeric tipine kayıpsız dönüştürülebilir, ama kayan noktalı tiplerden money'ye geçiş belgede önerilmez. Para tutarlarını numeric(12,2) gibi bir tiple saklayın, para birimini gerekiyorsa ayrı bir sütunda tutun ve biçimlendirmeyi uygulama tarafında ya da to_char gibi biçimlendirme fonksiyonlarıyla yapın.
Sabitlerin tipi ve pg_typeof
Bir sorgudaki sabitin hangi tipe çözüldüğünü bilmek, beklenmedik tam sayı bölmesi gibi hataları anlamayı kolaylaştırır. pg_typeof bir ifadenin tipini döndürür:
SELECT pg_typeof(1) AS a, pg_typeof(1.5) AS b, pg_typeof(3000000000) AS c, pg_typeof('metin') AS d; a | b | c | d
---------+---------+--------+---------
integer | numeric | bigint | unknown
(1 row)Noktasız sayı integer, sığmıyorsa bigint; noktalı sayı double precision değil numeric olarak yorumlandı. Tırnaklı sabitin tipi ise bağlamdan çıkarılana kadar unknown kalır; bu yüzden '1'::integer gibi açık dönüşümler bazen gerekir.
Sık yapılan hatalar
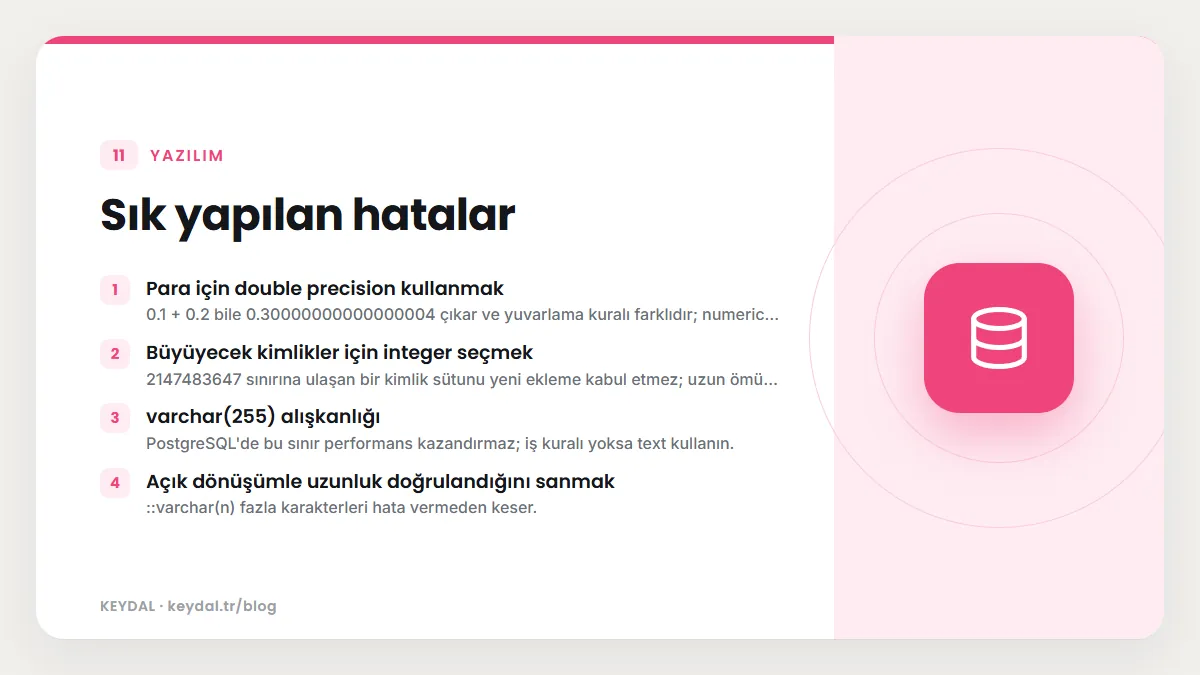
- Para için double precision kullanmak: 0.1 + 0.2 bile 0.30000000000000004 çıkar ve yuvarlama kuralı farklıdır;
numerickullanın. - Büyüyecek kimlikler için integer seçmek: 2147483647 sınırına ulaşan bir kimlik sütunu yeni ekleme kabul etmez; uzun ömürlü ve yoğun tablolar için
bigintseçin. - varchar(255) alışkanlığı: PostgreSQL'de bu sınır performans kazandırmaz; iş kuralı yoksa
textkullanın. - Açık dönüşümle uzunluk doğrulandığını sanmak:
::varchar(n)fazla karakterleri hata vermeden keser. - char(n) ile karşılaştırma sürprizleri: Sondaki boşluklar yok sayılır, başka tiplere dönüştürüldüğünde silinir; yeni tasarımlarda kullanmayın.
- Boolean sütunda NULL'ı unutmak:
= falsekoşulu NULL satırları getirmez; varsayılan değer veNOT NULLtanımlayın. - money tipine güvenmek: Locale'e bağlı çıktı, kesen bölme ve döküm sorunları nedeniyle
numerictercih edin.
Sık Sorulan Sorular
text mi varchar mı kullanmalıyım?
PostgreSQL'de ikisi arasında anlamlı bir performans farkı yoktur ve uzunluk belirtilmeyen varchar pratikte text gibi davranır. Bir uzunluk sınırı gerçek bir iş kuralıysa varchar(n) veya text ile birlikte CHECK (char_length(sütun) <= n) kullanın; değilse text yeterlidir.
Birincil anahtar için uuid mi bigint mi?
Tek bir veritabanında üretilen kimlikler için identity bigint daha küçük ve basittir. Kimliklerin birden çok sistemde çakışmadan üretilmesi gerekiyorsa uuid uygundur; PostgreSQL 18'deki uuidv7() zamana göre sıralı değer ürettiği için rastgele v4 değerlerine göre ekleme sırasıyla uyumludur. Identity sütunlarının ayrıntısı identity ve sequence yazısında.
Bir sütunun tipini sonradan değiştirebilir miyim?
Evet, ALTER TABLE ... ALTER COLUMN ... TYPE ... USING ile; ancak çoğu tip değişikliği tabloyu yeniden yazar. Ayrıntılar ve örnek CREATE TABLE ve ALTER TABLE yazısında.
Tarih, JSON ve dizi tipleri bu yazıda neden yok?
Her biri kendi fonksiyonları ve tuzaklarıyla ayrı bir yazıyı hak ediyor: tarih ve saat tipleri, JSONB, SQL/JSON ve jsonpath ve dizi tipi yazılarına bakın.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: PostgreSQL öğrenme rehberi · CREATE TABLE ve ALTER TABLE · Identity, serial ve sequence · Tarih ve saat tipleri · JSONB kullanımı · PostgreSQL 18 yenilikleri