PostgreSQL'de bir veritabanının yedeğini almanın en kolay yolu pg_dump komutudur: pg_dump -Fc -f yedek.dump veritabani veritabanının o anki tutarlı bir görüntüsünü tek dosyaya yazar, pg_restore -d yeni_db yedek.dump ise bu dosyayı geri yükler. Düz metin (SQL betiği) biçimindeki yedekler psql ile, diğer üç arşiv biçimi (custom, directory, tar) ise pg_restore ile geri yüklenir. Roller ve tablespace gibi küme geneli nesneler için ayrıca pg_dumpall gerekir.
Bu yazıda dört çıktı biçiminin farkını, pg_restore ile seçici geri yükleme yapmayı, paralel yedek almayı, pg_dumpall ile rolleri taşımayı ve sık yapılan hataları gerçek komut çıktılarıyla anlatıyoruz. Yedekleme stratejisini (3-2-1 kuralı, saklama süresi, yedeğin nerede durduğu) veritabanı yedekleme stratejileri yazısında ele aldık; burası komutların uygulamalı rehberidir. Tüm örnekler PostgreSQL 18.1 üzerinde, içinde satis.musteri, satis.siparis ve 1000 satırlık public.log_kaydi tablosu bulunan ornek_dump adlı bir veritabanıyla denendi.
pg_dump ne yapar, ne yapmaz?
pg_dump, sunucuya sıradan bir istemci gibi bağlanan bir programdır. Çalışmaya başladığı anda bir anlık görüntü (snapshot) alır ve yedeği bu görüntüye göre yazar; dolayısıyla yedek, işlem sürerken yapılan değişikliklerden etkilenmez ve kendi içinde tutarlıdır. Okuyanları da yazanları da engellemez. Yalnızca ALTER TABLE türünden özel (exclusive) kilit isteyen işlemler, yedek bitene kadar bekleyebilir.
İstemci olmasının iki sonucu var. Birincisi, yedeği ağ üzerinden başka bir makineden alabilirsiniz; bağlantı için -h, -p, -U seçenekleri ve PGHOST, PGPORT, PGUSER ortam değişkenleri geçerlidir. İkincisi, pg_dump özel bir yetkiyle çalışmaz: yedeklenecek her tabloyu okuyabilmesi gerekir. Bütün veritabanını yedeklemek için bu yüzden pratikte süper kullanıcı ya da tüm tabloları okuyabilen bir rol gerekir. Yetkiniz kısıtlıysa -n (şema) veya -t (tablo) ile erişebildiğiniz kısmı yedekleyebilirsiniz.
pg_dump tek bir veritabanını yedekler. Roller (kullanıcılar), tablespace tanımları ve yapılandırma parametrelerine verilmiş yetkiler küme genelinde tutulduğu için bu yedeğe girmez. Bunun pratikteki anlamını aşağıda bir hata örneğiyle göreceğiz.
Kılavuz önemli bir uyarı da yapıyor: basit durumlar dışında pg_dump, üretim veritabanlarının düzenli yedeği için genellikle doğru araç sayılmaz; çünkü yedek yalnızca alındığı ana döner, aradaki değişiklikler kaybolur. Belirli bir saniyeye geri dönebilmek için WAL arşivleme ve PITR yöntemini kullanırsınız. Öte yandan pg_dump çıktısının çok değerli bir özelliği vardır: genellikle daha yeni PostgreSQL sürümlerine yüklenebilir ve farklı makine mimarileri arasında taşınabilir. Dosya düzeyindeki yedekler ise sunucu sürümüne sıkı sıkıya bağlıdır.
Dört çıktı biçimi: plain, custom, directory, tar
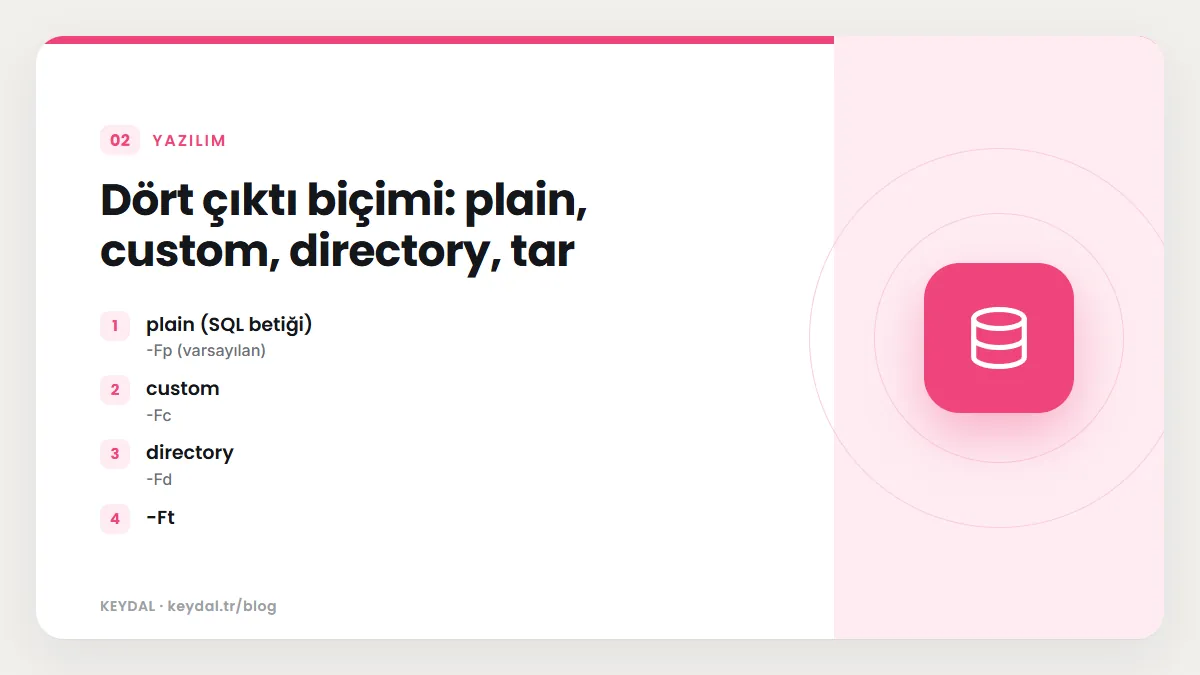
Biçimi -F (veya --format) seçeneği belirler. Seçmezseniz düz metin SQL betiği üretilir.
| Biçim | Seçenek | Geri yükleme | Sıkıştırma | Paralel yedek | Seçici geri yükleme |
|---|---|---|---|---|---|
| plain (SQL betiği) | -Fp (varsayılan) | psql | varsayılan yok, -Z ile tüm dosya | hayır | hayır (dosyayı elle düzenlemek gerekir) |
| custom | -Fc | pg_restore | varsayılan gzip | hayır | evet, sıralama da değiştirilebilir |
| directory | -Fd | pg_restore | varsayılan gzip, tablo başına dosya | evet (-j) | evet |
| tar | -Ft | pg_restore | desteklenmez | hayır | evet, ancak tablo verisinin sırası değiştirilemez |
Pratik bir kural olarak tek dosya istiyorsanız -Fc, büyük veritabanında paralel yedek almak istiyorsanız -Fd seçin. Düz metin biçimi, yedeği okumak, başka bir sisteme aktarmak ya da sürüm kontrolünde şema farkı görmek istediğinizde işe yarar. Custom ve directory biçimleri en esnek olanlardır: hem içerikten seçim yapmayı hem de sırayı değiştirmeyi destekler, ayrıca varsayılan olarak sıkıştırılır. Sıkıştırma yöntemini -Z ile gzip, lz4, zstd veya none olarak değiştirebilirsiniz; -Z yalnızca bir sayı içeriyorsa ve bu sayı 0'dan büyükse gzip kullanılır.
Düz metin yedek alma ve içeriğini okuma
pg_dump -h 127.0.0.1 -p 46470 -U postgres -f ornek.sql ornek_dump
echo $?
# 0
Oluşan dosya sıradan bir SQL betiğidir. Başında oturum ayarları (SET client_encoding, SET row_security = off gibi), ardından şema ve tablo tanımları, sonra COPY ... FROM stdin blokları halinde veri, en sonda da birincil anahtar, indeks ve yabancı anahtar tanımları gelir. Dosyanın sonundaki bölüm şöyle görünür (kısaltıldı):
COPY satis.musteri (id, ad, il) FROM stdin;
1	Ayşe Yılmaz	İzmir
2	Mehmet Öztürk	Ankara
3	Zeynep Çelik	Muğla
\.
...
SELECT pg_catalog.setval('satis.musteri_id_seq', 3, true);
...
ALTER TABLE ONLY satis.musteri
    ADD CONSTRAINT musteri_pkey PRIMARY KEY (id);
...
CREATE INDEX siparis_musteri_idx ON satis.siparis USING btree (musteri_id);
...
ALTER TABLE ONLY satis.siparis
    ADD CONSTRAINT siparis_musteri_id_fkey FOREIGN KEY (musteri_id) REFERENCES satis.musteri(id);
Sıralamaya dikkat edin: veri, indeks ve kısıtlardan önce yükleniyor. Bu bilinçli bir tercih; boş tabloya veri doldurup indeksi sonra kurmak, her satırda indeksi güncellemekten çok daha hızlıdır. Kılavuz bu üç parçaya bölüm (section) diyor: pre-data (tablo, şema, tip tanımları), data (tablo verisi, sequence değerleri) ve post-data (indeksler, tetikleyiciler, kurallar ve doğrulanmış CHECK ile NOT NULL dışındaki kısıtlar). --section seçeneğiyle yalnızca birini yedekleyebilir veya geri yükleyebilirsiniz.
PostgreSQL 18.1 ile alınan düz metin yedeklerin ilk ve son satırlarında \restrict ve \unrestrict adlı psql meta komutlarını ve ardından rastgele bir anahtar göreceksiniz. pg_dump belgesi bu anahtarın her yedekte rastgele üretildiğini, --restrict-key ile sabitlenmesinin yalnızca test gibi tekrarlanabilir çıktı gereken durumlar için düşünüldüğünü ve genel kullanımda önerilmediğini söylüyor. Bu satırlar psql'e özgü olduğundan düz metin yedeği psql dışındaki bir istemciyle çalıştırmak sorun çıkarabilir.
Düz metin yedeği psql ile geri yükleme
Düz metin betik, hedef veritabanını kendisi oluşturmaz (-C ile alınmadıysa). Önce boş bir veritabanı açmanız gerekir; kılavuz bunun template1 yerine template0 şablonundan yapılmasını öneriyor, çünkü template1'e sonradan eklenmiş nesneler varsa yedekteki tanımlarla çakışır. Ardından psql'i -X ile (kişisel .psqlrc ayarlarını okumadan) çalıştırırsınız:
createdb -h 127.0.0.1 -p 46471 -U postgres -T template0 ornek_duz
psql -h 127.0.0.1 -p 46471 -U postgres -X -q -1 --set ON_ERROR_STOP=on -d ornek_duz -f ornek.sql
echo $?
# 0
Burada iki seçenek önemli. ON_ERROR_STOP=on olmadan psql hata alsa bile betiğin geri kalanını çalıştırmaya devam eder ve sonuçta yarım yüklenmiş bir veritabanı kalır. -1 (--single-transaction) ise tüm betiği tek transaction içinde çalıştırır: ya hepsi yüklenir ya hiçbiri. Aynı komutu, içi zaten dolu olan veritabanına ikinci kez çalıştırdığımızda ne olduğuna bakalım:
psql -h 127.0.0.1 -p 46471 -U postgres -X -q -1 --set ON_ERROR_STOP=on -d ornek_duz -f ornek.sql
# psql:ornek.sql:26: ERROR:  schema "satis" already exists
echo $?
# 3
psql ilk hatada durdu ve çıkış kodu olarak 3 döndürdü; tek transaction kullandığımız için de hiçbir değişiklik kalıcı olmadı. Betik içinde bu kodu kontrol etmek, gece çalışan otomatik geri yükleme testlerinde sessiz hataları yakalamanın en kolay yoludur. Tek transaction'ın bir bedeli de var: saatlerce süren bir geri yükleme, sondaki küçük bir hata yüzünden tamamen geri alınabilir. Kılavuz yine de bunun, yarım kalmış karmaşık bir veritabanını elle temizlemekten çoğu zaman daha iyi olduğunu belirtiyor.
pg_dump ve psql standart çıktı ve girdiyle çalıştığı için veritabanını iki sunucu arasında doğrudan boru hattıyla da taşıyabilirsiniz: pg_dump -h kaynak veritabani | psql -X -h hedef veritabani. Böylece arada dosya oluşmaz.
Custom biçim ve pg_restore ile içindekiler listesi
pg_dump -h 127.0.0.1 -p 46470 -U postgres -Fc -f ornek.dump ornek_dump
pg_restore -l ornek.dump;
; Archive created at 2026-11-07 12:18:35
; dbname: ornek_dump
; TOC Entries: 19
; Compression: gzip
; Dump Version: 1.16-0
; Format: CUSTOM
; Integer: 4 bytes
; Offset: 8 bytes
; Dumped from database version: 18.1
; Dumped by pg_dump version: 18.1
;
;
; Selected TOC Entries:
;
6; 2615 16386 SCHEMA - satis magaza_sahibi
224; 1259 16412 TABLE public log_kaydi magaza_sahibi
221; 1259 16388 TABLE satis musteri magaza_sahibi
220; 1259 16387 SEQUENCE satis musteri_id_seq magaza_sahibi
223; 1259 16399 TABLE satis siparis magaza_sahibi
222; 1259 16398 SEQUENCE satis siparis_id_seq magaza_sahibi
5023; 0 16412 TABLE DATA public log_kaydi magaza_sahibi
5020; 0 16388 TABLE DATA satis musteri magaza_sahibi
5022; 0 16399 TABLE DATA satis siparis magaza_sahibi
5030; 0 0 SEQUENCE SET satis musteri_id_seq magaza_sahibi
5031; 0 0 SEQUENCE SET satis siparis_id_seq magaza_sahibi
4867; 2606 16397 CONSTRAINT satis musteri musteri_pkey magaza_sahibi
4870; 2606 16406 CONSTRAINT satis siparis siparis_pkey magaza_sahibi
4868; 1259 16417 INDEX satis siparis_musteri_idx magaza_sahibi
4871; 2606 16407 FK CONSTRAINT satis siparis siparis_musteri_id_fkey magaza_sahibi-l çıktısı arşivin içindekiler tablosudur (TOC). Satır başındaki sayı arşiv içindeki öğe numarasıdır, noktalı virgülle başlayan satırlar yorumdur. Bu listeyi bir dosyaya yazıp istemediğiniz satırların başına ; koyar ya da satırların yerini değiştirirseniz, pg_restore -L liste.txt yalnızca kalan öğeleri, dosyadaki sırayla geri yükler. Çok büyük bir log tablosunu atlamak veya bir tabloyu ötekinden önce yüklemek için bu yöntem idealdir.
Arşiv biçimindeki bir dosyayı okumak için doğrudan veritabanına yüklemek zorunda değilsiniz: pg_restore -f - ornek.dump içeriği düz SQL olarak ekrana yazar. Kılavuzun güvenlik uyarısı tam da buna dayanıyor: bir yedeği geri yüklemek, kaynak sunucunun süper kullanıcısının yedeğe koyduğu kodu hedefte çalıştırmak demektir. Güvenmediğiniz bir kaynaktan gelen yedeği önce bu şekilde inceleyin.
Geri yükleme için önce boş bir veritabanı açıp ona bağlanırsınız:
createdb -h 127.0.0.1 -p 46470 -U postgres -T template0 ornek_geri
pg_restore -h 127.0.0.1 -p 46470 -U postgres -d ornek_geri ornek.dump
echo $?
# 0
Alternatif olarak -C ile veritabanını pg_restore'un oluşturmasını isteyebilirsiniz. Bu durumda -d ile verdiğiniz veritabanı (genellikle postgres) yalnızca CREATE DATABASE komutunu çalıştırmak için kullanılır; veri her zaman yedekteki veritabanı adına yüklenir. -c (--clean) önce mevcut nesneleri düşürür; olmayan nesneler için çıkan zararsız hataları --if-exists ile susturursunuz. pg_dump belgesindeki örnek, bir yedeği alındığı veritabanının üzerine yazmak için pg_restore -d postgres --clean --create db.dump kullanıyor.
Tek tablo geri yükleme ve gizli tuzakları
Custom arşivden yalnızca bir tabloyu geri almak için -n ile şemayı, -t ile tabloyu verirsiniz. Ancak bu seçenek, tablonun bağlı olduğu diğer nesneleri getirmez. Boş bir veritabanında denediğimizde sonuç şuydu:
pg_restore -h 127.0.0.1 -p 46470 -U postgres -d ornek_tek -n satis -t musteri ornek.dumppg_restore: error: could not execute query: ERROR: schema "satis" does not exist
LINE 1: CREATE TABLE satis.musteri (
^
...
pg_restore: warning: errors ignored on restore: 3Şema, tablonun bir parçası sayılmadığı için oluşturulmadı. pg_restore varsayılan olarak hatada durmaz; sona kadar devam eder ve kaç hatayı geçtiğini yazar. Bu davranışı -e (--exit-on-error) ile değiştirebilirsiniz; -1 de bu seçeneği kendiliğinden açar. Şemayı elle oluşturup aynı komutu tekrar çalıştırdığımızda tablo geldi, fakat yapısına bakınca bir eksik göze çarpıyor:
               Table "satis.musteri"
 Column |  Type   | Collation | Nullable | Default
--------+---------+-----------+----------+---------
 id     | integer |           | not null |
 ad     | text    |           | not null |
 il     | text    |           | not null |
Birincil anahtar yok, id sütunundaki identity tanımı da gelmedi. Belge bunu açıkça yazıyor: pg_restore'un -t seçeneği, pg_dump'ın -t seçeneğinden farklı davranır; indeks gibi bağlı nesneleri dahil etmez, joker karakter kabul etmez ve tablo adının içinde şema adı yazılamaz. Tek tabloyu eksiksiz geri almak istiyorsanız iki yol var: -l çıktısından ilgili TABLE, SEQUENCE, TABLE DATA, CONSTRAINT ve INDEX satırlarını seçip -L ile vermek ya da tablonun yalnızca verisini (--data-only) zaten tanımları yerinde olan bir veritabanına yüklemek.
Directory biçimi ve paralel yedek
Büyük veritabanlarında yedek süresini kısaltmanın yolu -j ile birden fazla tabloyu aynı anda yedeklemektir. Birden çok sürecin aynı anda yazabildiği tek biçim directory olduğu için -j yalnızca -Fd ile çalışır:
pg_dump -h 127.0.0.1 -p 46470 -U postgres -Fd -j 2 -f ornek_dizin ornek_dump
ls ornek_dizin
# 5020.dat.gz
# 5022.dat.gz
# 5023.dat.gz
# toc.dat
Her tablonun verisi ayrı bir sıkıştırılmış dosyaya, içindekiler tablosu toc.dat dosyasına yazıldı. Dosya adlarındaki numaralar, yukarıdaki -l listesindeki TABLE DATA satırlarının numaralarıyla aynıdır. Hedef dizin önceden var olmamalıdır; pg_dump onu kendisi oluşturur.
pg_dump -j N sunucuya N+1 bağlantı açar: bir lider ve N işçi. max_connections değerinin buna yetmesi gerekir. Paralel yedeğin bilinmesi gereken bir zayıf noktası da var: lider süreç tablolara paylaşımlı kilit alır; yedek sürerken başka bir oturum aynı tabloda özel kilit isterse, işçi süreç kilidi NOWAIT ile alamaz ve yedek iptal edilir. Yedek saatlerinde şema değişikliği yapan işler planlamamak bu yüzden önemlidir. Geri yüklemede pg_restore -j, custom veya directory biçimindeki her arşivle çalışır; arşivin paralel alınmış olması gerekmez:
createdb -h 127.0.0.1 -p 46471 -U postgres -T template0 ornek_paralel
pg_restore -h 127.0.0.1 -p 46471 -U postgres -j 2 -d ornek_paralel ornek_dizin
echo $?
# 0
pg_restore -j, veri yükleme, indeks oluşturma ve kısıt kurma gibi en uzun süren adımları eşzamanlı oturumlarda çalıştırır. Betik çıktısı üretirken (yani -d verilmediğinde) bu seçenek yok sayılır. Ayrıca -j ile -1 birlikte kullanılamaz; çok büyük geri yüklemelerde tek transaction yerine --transaction-size=N seçeneği, her N nesnede bir transaction açarak kilit tablosunun dolmasını engeller.
pg_dumpall ve "role does not exist" hatası
Yedeği başka bir sunucuya taşırken en sık karşılaşılan sorun, yedekteki nesnelerin sahibi olan rolün hedefte bulunmamasıdır. Custom yedeği, magaza_sahibi rolü olmayan yeni bir kümeye yüklemeye çalıştığımızda şu çıktıyı aldık:
pg_restore -h 127.0.0.1 -p 46471 -U postgres -d postgres -C ornek.dumppg_restore: error: could not execute query: ERROR: role "magaza_sahibi" does not exist
Command was: ALTER DATABASE ornek_dump OWNER TO magaza_sahibi;
pg_restore: error: could not execute query: ERROR: role "magaza_sahibi" does not exist
Command was: ALTER SCHEMA satis OWNER TO magaza_sahibi;
...
pg_restore: warning: errors ignored on restore: 5Veri yüklendi ama tüm nesneler bağlanan kullanıcıya (burada postgres) ait kaldı. Bazen istenen tam da budur; o durumda -O (--no-owner) ile sahiplik komutlarını hiç üretmeyebilirsiniz. Sahipliği korumak istiyorsanız rolleri önceden taşımanız gerekir. Bunun için pg_dumpall --globals-only (-g) yalnızca rolleri ve tablespace'leri yazar:
pg_dumpall -h 127.0.0.1 -p 46470 -U postgres --globals-only -f roller.sqlCREATE ROLE magaza_sahibi;
ALTER ROLE magaza_sahibi WITH NOSUPERUSER INHERIT NOCREATEROLE NOCREATEDB LOGIN NOREPLICATION NOBYPASSRLS;
CREATE ROLE postgres;
ALTER ROLE postgres WITH SUPERUSER INHERIT CREATEROLE CREATEDB LOGIN REPLICATION BYPASSRLS;Bu dosyayı hedefte çalıştırdığımızda psql:roller.sql:18: ERROR: role "postgres" already exists hatası çıktı. Kılavuz bu hatanın zararsız olduğunu ve beklenmesi gerektiğini söylüyor: betik kaynaktaki her rol için CREATE ROLE yazar, hedef küme de aynı adlı önyükleme süper kullanıcısıyla kurulmuşsa bu satır başarısız olur. Roller yüklendikten sonra aynı pg_restore -C komutu hatasız tamamlandı ve tablolar magaza_sahibi sahipliğiyle geldi.
pg_dumpall seçeneksiz çalıştırıldığında bütün kümeyi tek bir SQL betiği olarak yazar: önce rolleri, tablespace'leri ve boş veritabanlarını oluşturan komutlar, ardından her veritabanı için pg_dump çıktısı. Bunun iki sonucu var. Çıktı her zaman düz metindir, dolayısıyla paralel geri yükleme ve seçici geri yükleme yoktur. Ayrıca her veritabanı kendi içinde tutarlı olsa da farklı veritabanlarının anlık görüntüleri aynı ana ait değildir. Bu yüzden büyük kümelerde sık görülen düzen, pg_dumpall -g ile globalleri ve her veritabanı için ayrı pg_dump -Fc yedeğini birlikte almaktır. Geri yüklemede psql -X -f yedek.sql postgres kullanılır; --clean ile alınmışsa mutlaka postgres veritabanına bağlanmalısınız, çünkü betik diğer veritabanlarını düşürmeye çalışır. Parolaları yedeğe koymak istemiyorsanız --no-role-passwords seçeneği var; bu durumda roller parolasız gelir ve parola atanana kadar parola doğrulamasıyla giriş yapamaz.
Sık kullanılan seçenekler
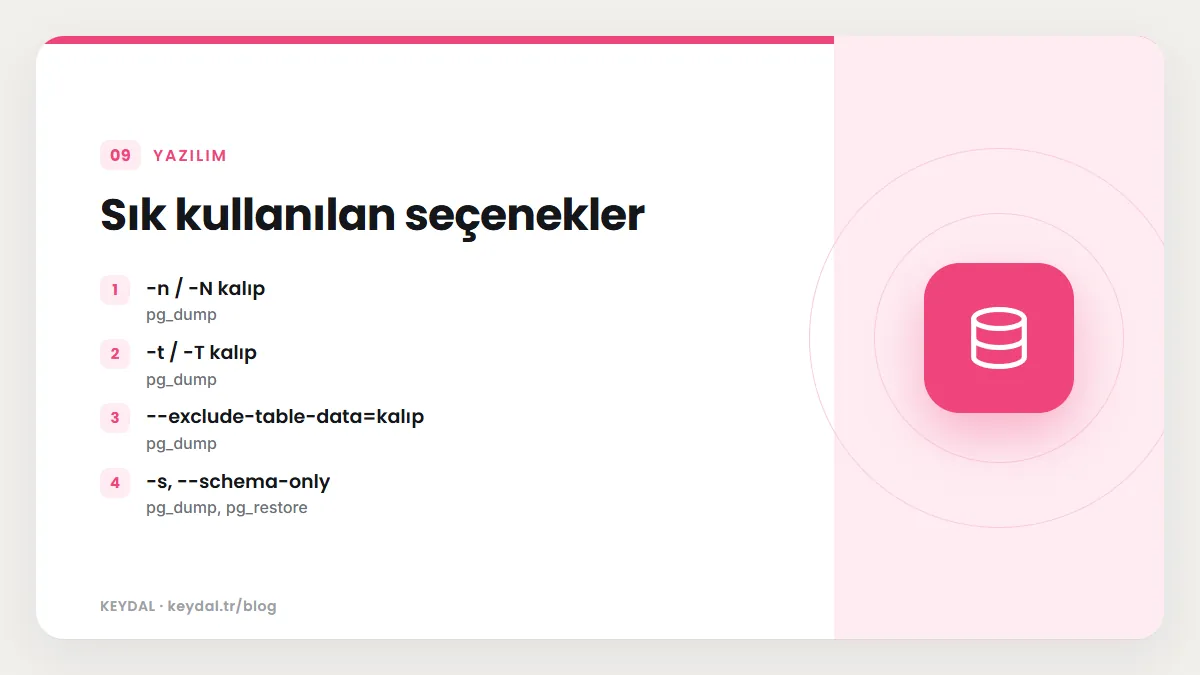
| Seçenek | Araç | Ne yapar |
|---|---|---|
| -n / -N kalıp | pg_dump | Şemayı dahil eder / hariç tutar, joker karakter kabul eder |
| -t / -T kalıp | pg_dump | Tabloyu dahil eder / hariç tutar; bağlı nesneleri (şema gibi) getirmez |
| --exclude-table-data=kalıp | pg_dump | Tablo tanımını alır, verisini almaz |
| -s, --schema-only | pg_dump, pg_restore | Yalnızca nesne tanımları |
| -a, --data-only | pg_dump, pg_restore | Yalnızca veri |
| -O, --no-owner | pg_dump (plain), pg_restore | Sahiplik komutlarını üretmez |
| -x, --no-privileges | pg_dump, pg_restore | GRANT/REVOKE komutlarını atlar |
| -c --if-exists | pg_dump (plain), pg_restore | Önce DROP IF EXISTS yazar |
| -e, --exit-on-error | pg_restore | İlk hatada durur |
| -1, --single-transaction | pg_restore, psql | Hepsi ya da hiçbiri |
| --filter=dosya | pg_dump, pg_dumpall, pg_restore | Dahil/hariç kalıplarını dosyadan okur |
Örneğin 1000 satırlık log tablosunun yapısını tutup verisini dışarıda bırakmak için pg_dump --exclude-table-data=public.log_kaydi -f kucuk.sql ornek_dump çalıştırdık; çıktıda yalnızca iki COPY bloğu (musteri ve siparis) kaldı. Düz metin biçiminde -c, -C, -O gibi seçenekler yedek alınırken uygulanır; arşiv biçimlerinde ise bu seçenekler pg_dump'ta yok sayılır ve geri yükleme sırasında pg_restore'a verilir. Arşiv biçimlerinin esnekliği buradan gelir: aynı dosyadan bir kez sahiplikle, bir kez sahipliksiz geri yükleme yapabilirsiniz.
PostgreSQL 18 ile gelen seçenekler
PostgreSQL: Release 18 notlarına göre bu sürümde pg_dump, pg_dumpall ve pg_restore'a planlayıcı istatistikleriyle ilgili --statistics, --statistics-only ve --no-statistics seçenekleri, ayrıca --no-data, --no-schema ve satır düzeyi güvenlik politikalarını atlayan --no-policies eklendi. --sequence-data ise normalde dışarıda kalacak sequence değerlerini de yedeğe koyar. 18 belgesine göre pg_dump varsayılan olarak istatistik yazmaz; --statistics verdiğinizde iyileştirici istatistiklerinin çoğu dahil edilir, ama CREATE STATISTICS ile oluşturulanlar gibi bazıları yine dışarıda kalır. Bu yüzden geri yüklemeden sonra ANALYZE çalıştırmak hâlâ önerilen adımdır.
Sürümler arası taşıma kuralları
pg_dump kendi sürümünden eski sunuculardan yedek alabilir (belgeye göre 9.2'ye kadar), ama kendi ana sürümünden yeni bir sunucuya bağlanmayı reddeder. Çıktısı daha yeni sunuculara yüklenebilir, eski sunuculara yüklenmesi ise garanti edilmez. Pratik kural şudur: yükseltme yaparken hedef sürümün pg_dump programını kullanın ve farklı ana sürümler arasında --quote-all-identifiers ekleyin; böylece yeni sürümde ayrılmış kelime haline gelen tanımlayıcılar sorun çıkarmaz. Sürüm yükseltmenin tamamı için pg_upgrade ile sürüm yükseltme yazısına bakabilirsiniz.
Sık yapılan hatalar
- Düz metin yedeği
pg_restoreile, arşiv yedeği psql ile açmaya çalışmak.-Fc,-Fd,-Ftdosyaları SQL betiği değildir. - Geri yüklemeden önce
template1'den veritabanı açmak; özelleştirilmiştemplate1nesneleri yedekle çakışır.createdb -T template0kullanın. - Rolleri taşımamak; sahiplik ve GRANT komutları "role does not exist" ile düşer. Önce
pg_dumpall -gçıktısını yükleyin ya da bilerek-O -xkullanın. pg_restore'un hatada durduğunu sanmak. Varsayılan davranış devam etmektir; otomasyonda-eveya-1ve çıkış kodu kontrolü kullanın.- Geri yüklemeden sonra
ANALYZEçalıştırmamak; planlayıcı istatistik olmadan kötü plan seçebilir. - Yedeği hiç geri yükleyip denememek. Bir yedeğin çalıştığını bilmenin tek yolu onu ayrı bir kümede geri yüklemektir.
Büyük veritabanlarını hızlı yüklemek için önerilen diğer ayarları (örneğin maintenance_work_mem) COPY ile toplu yükleme yazısında, düzenli yedeği zamanlamayı crontab rehberi yazısında bulabilirsiniz.
Sık Sorulan Sorular
pg_dump çalışırken veritabanı kullanılabilir mi?
Evet. pg_dump okuma ve yazma işlemlerini engellemez, yedeği başladığı anın görüntüsüne göre alır. Yalnızca özel kilit isteyen işlemler (çoğu ALTER TABLE biçimi gibi) yedeğin bitmesini bekleyebilir.
Hangi biçimi seçmeliyim?
Genel kullanım için -Fc: tek dosya, sıkıştırılmış, seçici ve paralel geri yüklemeye uygun. Paralel yedek gerekiyorsa -Fd -j. İnsan tarafından okunabilir bir betik ya da başka bir veritabanına aktarma gerekiyorsa düz metin.
Kullanıcılar ve parolalar pg_dump yedeğinde var mı?
Hayır. Roller küme geneli nesnelerdir; pg_dumpall --globals-only veya --roles-only ile ayrıca yedeklenmeleri gerekir. Rollerin ayrıntıları için kullanıcı ve rol yönetimi yazısına bakın.
pg_dump yedeği ile belirli bir saate dönebilir miyim?
Hayır, yalnızca yedeğin alındığı ana dönebilirsiniz. Saniye hassasiyetinde geri dönüş için temel yedek ile WAL arşivinin birlikte kullanıldığı PITR gerekir.
Yedeği alan kullanıcının süper kullanıcı olması şart mı?
Şart değil, ama yedeklenecek tüm nesneleri okuyabilmesi gerekir. Doğrudan süper kullanıcıyla giriş yapmayı yasaklayan ortamlarda --role seçeneği bağlandıktan sonra SET ROLE ile yetkili bir role geçer.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: PostgreSQL öğrenme rehberi · WAL arşivleme ve PITR · COPY ile CSV aktarma · Sürüm yükseltme · Yedekleme stratejileri · Rol yönetimi