PHP'nin klasik metin fonksiyonları (strlen(), substr(), strtoupper() gibi) karakterlerle değil baytlarla çalışır. UTF-8'de ç, ğ, ı, İ, ö, ş, ü gibi Türkçe harfler iki bayt yer kapladığı için bu fonksiyonlar Türkçe metinde yanlış uzunluk verir, kelimeleri harfin ortasından keser ve büyük/küçük harf dönüşümünde Türkçe harflere dokunmaz. Çözüm, mbstring eklentisindeki mb_ önekli fonksiyonları kullanmaktır: mb_strlen(), mb_substr(), mb_strtoupper() ve benzerleri karakter sayar.
Ancak mbstring de Türkçe için tek başına yeterli değildir. mb_strtoupper('istanbul') çağrısı İSTANBUL değil ISTANBUL döndürür, çünkü Unicode'un varsayılan kuralları noktalı ve noktasız i ayrımını bilmez. Bu yazıda bayt ile karakter farkını, mbstring fonksiyonlarını, Türkçe i/I sorununun nedenini ve küçük yardımcı fonksiyonlarla nasıl çözüleceğini, PHP 8.4 ile gelen mb_ucfirst() ve mb_trim() fonksiyonlarını anlatıyoruz. Temel metin işlemleri için PHP string fonksiyonları yazısına bakabilirsiniz.
Bayt mı, karakter mi?
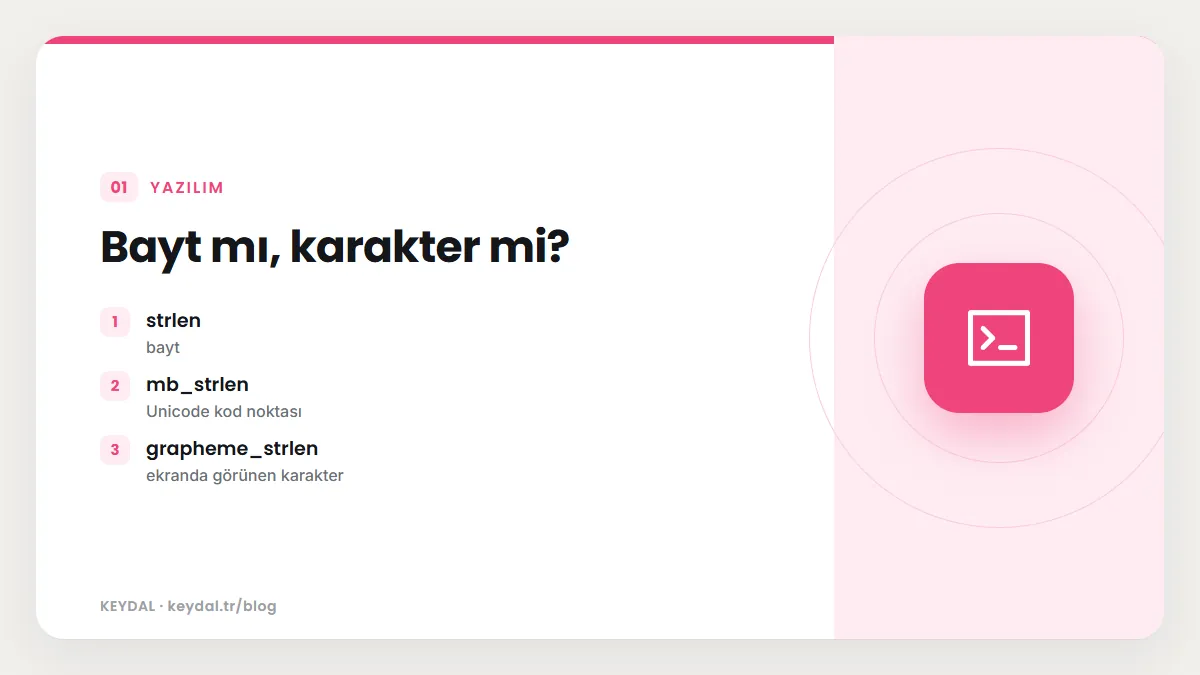
PHP'de string tipi bir bayt dizisidir; içindeki baytların hangi karakter kodlamasına ait olduğunu bilmez. Kılavuz strlen() için bunu açıkça yazar: fonksiyon karakter sayısını değil bayt sayısını döndürür. ASCII harfleri UTF-8'de tek bayt olduğu için İngilizce metinde fark görünmez. Türkçe harflerin her biri ise iki bayttır; Şişli kelimesinde beş harf, yedi bayt vardır.
İşin bir katmanı daha var. Bazı karakterler birden fazla Unicode kod noktasından oluşur: harfin üstündeki vurgu işareti ayrı bir "birleştirici" karakter olarak yazılabilir, emojiler ten rengi değiştiricisiyle birleşebilir. mb_strlen() kod noktalarını sayar. Ekranda tek karakter görünen birimleri (grapheme) saymak için intl eklentisindeki grapheme_strlen() fonksiyonu kullanılır. Kullanıcı adı veya mesaj uzunluğu sınırı gibi işlerde hangi birimi saydığınızı bilmeniz gerekir.
<?php
$sehir = 'Şişli';
echo strlen($sehir), "\n";      // çıktı: 7  (bayt)
echo mb_strlen($sehir), "\n";   // çıktı: 5  (karakter)

$vurgulu = "e\u{0301}";         // e harfi + birleştirici vurgu işareti
echo strlen($vurgulu), ' ', mb_strlen($vurgulu), ' ', grapheme_strlen($vurgulu), "\n"; // çıktı: 3 2 1

$emoji = "👍🏽";                  // başparmak + ten rengi değiştiricisi
echo strlen($emoji), ' ', mb_strlen($emoji), ' ', grapheme_strlen($emoji), "\n"; // çıktı: 8 2 1| Fonksiyon | Neyi sayar | Şişli için sonuç | Ne zaman kullanılır |
|---|---|---|---|
| strlen | bayt | 7 | bayt boyutu gerektiğinde (depolama, protokol) |
| mb_strlen | Unicode kod noktası | 5 | Türkçe metinde karakter sayısı |
| grapheme_strlen | ekranda görünen karakter | 5 | emoji ve birleştirici işaretli metin |
İç kodlama: mbstring hangi kodlamayı varsayar?
mbstring fonksiyonlarının hepsi isteğe bağlı bir $encoding parametresi alır. Bu parametreyi vermezseniz iç kodlama (internal encoding) kullanılır. Kılavuz, mbstring'in kodlama ayarlarını boş bırakıp çekirdekteki default_charset ayarını kullanmayı önerir; bu ayarın varsayılan değeri de UTF-8'dir. Hiç php.ini kullanmadan çalıştırdığımız PHP 8.5.12'de mb_internal_encoding() çağrısı UTF-8 döndürdü. Eski bir projede bu değer farklı ayarlanmışsa fonksiyonlara 'UTF-8' parametresini açıkça vermek en güvenli yoldur. PHP 8.0'dan beri geçersiz bir kodlama adı verirseniz ValueError fırlatılır.
substr() ile harfi ortadan kesmek
substr() başlangıç ve uzunluğu bayt olarak alır. Kesme noktası iki baytlık bir harfin ortasına denk gelirse sonuçta geçersiz bir UTF-8 dizisi kalır; tarayıcıda soru işaretli bir kutu olarak görünür, veritabanına yazarken hata verebilir, json_encode() ise bu metni kodlayamaz. mb_substr() aynı parametreleri karakter olarak yorumlar. Negatif başlangıç sondan sayar. Karakter konumu bulmak için de strpos() yerine mb_strpos() kullanılmalıdır; ikisi aynı metinde farklı sayılar döndürür, ve strpos() sonucunu mb_substr()'a vermek yanlış yerden keser.
<?php
$sehir = 'Şişli';
$yarim = substr($sehir, 0, 4);
var_dump(mb_check_encoding($yarim, 'UTF-8'));   // çıktı: bool(false)  (ş ortadan kesildi)
echo mb_substr($sehir, 0, 4), "\n";              // çıktı: Şişl

$ilce = 'Kadıköy';
echo mb_substr($ilce, -3), "\n";                 // çıktı: köy
echo mb_strpos($ilce, 'köy'), ' ', strpos($ilce, 'köy'), "\n"; // çıktı: 4 5
Kullanıcıdan gelen bir metnin geçerli UTF-8 olup olmadığını mb_check_encoding($metin, 'UTF-8') ile kontrol edebilirsiniz. Kılavuz bu fonksiyonu "geçersiz kodlama saldırılarına" karşı bir önlem olarak tanıtır. PHP 8.1'den beri fonksiyonu parametresiz veya null ile çağırmak kullanımdan kaldırılmıştır; kontrol edeceğiniz değeri her zaman açıkça verin.
strtoupper() artık yalnızca ASCII harflere dokunur
strtoupper(), strtolower(), ucfirst() ve ucwords() fonksiyonlarının kılavuzdaki sürüm notu nettir: PHP 8.2'den beri bu fonksiyonlar setlocale() ile seçilen yerel ayara bakmaz ve yalnızca ASCII harfleri (a ile z arası) dönüştürür. 8.2'den önce sonuç, setlocale() ile seçilen yerel ayara bağlı olabiliyordu; artık davranış her sistemde aynıdır ve UTF-8 metindeki Türkçe harfler olduğu gibi kalır. Bu yüzden çiğdem kelimesi strtoupper() ile çIğDEM olur ve ucfirst('çiğdem') hiçbir şeyi değiştirmez.
mb_strtoupper() ve mb_strtolower() ise harfin ne olduğuna Unicode karakter özelliklerine bakarak karar verir ve kılavuza göre yerel ayardan etkilenmez. Ç, Ğ, Ö, Ş, Ü harflerini doğru dönüştürürler. Sorun yalnızca i ve ı harflerindedir.
<?php
echo strtoupper('çiğdem'), "\n";     // çıktı: çIğDEM
echo ucfirst('çiğdem'), "\n";        // çıktı: çiğdem
echo mb_strtoupper('çiğdem'), "\n";  // çıktı: ÇIĞDEM  (Türkçede ÇİĞDEM olmalı)
echo mb_strtoupper('ılık'), "\n";    // çıktı: ILIK    (doğru)
Türkçe i/I sorunu: neden oluyor?
Türkçe alfabede dört ayrı harf vardır: noktasız küçük ı, noktalı küçük i, noktasız büyük I ve noktalı büyük İ. Türkçede i harfinin büyüğü İ, ı harfinin büyüğü I'dır. Unicode'un dilden bağımsız varsayılan kuralları ise İngilizceyi esas alır: i harfinin büyüğü I sayılır. ı harfi büyütülünce yine I olur, böylece iki farklı küçük harf aynı büyük harfe düşer.
Küçültme yönünde tablo daha da ilginçtir. mb_strtolower('I') sonucu Türkçe beklentideki ı değil i'dir. mb_strtolower('İ') ise tek bir harf değil, iki kod noktasından oluşan bir dizi döndürür: düz i ve onun üstüne eklenen birleştirici nokta (U+0307). Ekranda çoğu zaman normal bir i gibi görünse de bayt düzeyinde farklıdır; bu yüzden mb_strtolower('İSTANBUL') === 'istanbul' karşılaştırması false döner ve arama, eşleştirme, tekil kullanıcı adı kontrolü gibi işler sessizce bozulur. mb_convert_case() fonksiyonunun MB_CASE_LOWER ve MB_CASE_TITLE kipleri de aynı kuralları kullanır.
<?php
echo mb_strtoupper('istanbul'), "\n";               // çıktı: ISTANBUL
echo mb_strtolower('IŞIK'), "\n";                   // çıktı: işik
echo bin2hex(mb_strtolower('İ')), "\n";             // çıktı: 69cc87  (i + U+0307)
var_dump(mb_strtolower('İSTANBUL') === 'istanbul'); // çıktı: bool(false)
echo mb_convert_case('ahmet IŞIK', MB_CASE_TITLE), "\n"; // çıktı: Ahmet Işik
Türkçe büyük/küçük harf için yardımcı fonksiyonlar
Sorun yalnızca dört harfte olduğu için çözüm de basittir: dönüşümden önce bu harfleri Türkçe karşılıklarıyla değiştirin, kalan işi mbstring'e bırakın. Büyütmeden önce i harfini İ'ye, ı harfini I'ya; küçültmeden önce İ harfini i'ye, I harfini ı'ya çevirirsiniz. str_replace() bayt düzeyinde çalışsa da burada güvenlidir, çünkü aranan ve yerine konan değerlerin hepsi tam karakterlerdir.
<?php
function tr_buyuk(string $s): string
{
    return mb_strtoupper(str_replace(['i', 'ı'], ['İ', 'I'], $s));
}

function tr_kucuk(string $s): string
{
    return mb_strtolower(str_replace(['İ', 'I'], ['i', 'ı'], $s));
}

function tr_ilk_buyuk(string $s): string
{
    return tr_buyuk(mb_substr($s, 0, 1)) . mb_substr($s, 1);
}

function tr_baslik(string $s): string
{
    $kelimeler = explode(' ', tr_kucuk($s));
    return implode(' ', array_map(tr_ilk_buyuk(...), $kelimeler));
}

echo tr_buyuk('istanbul ılık'), "\n";     // çıktı: İSTANBUL ILIK
echo tr_kucuk('İSTANBUL IŞIK'), "\n";     // çıktı: istanbul ışık
echo tr_ilk_buyuk('izmir'), "\n";         // çıktı: İzmir
echo tr_baslik('ahmet IŞIK izmir'), "\n"; // çıktı: Ahmet Işık İzmir
var_dump(tr_kucuk('İSTANBUL') === 'istanbul'); // çıktı: bool(true)
tr_baslik() kelimeleri yalnızca boşluktan ayırır; tire veya kesme işaretiyle birleşik adlarda ek kurallar gerekebilir. Bu fonksiyonları yalnızca metnin Türkçe olduğunu bildiğiniz yerlerde kullanın. Aynı sayfada İngilizce bir ürün adı varsa (örneğin Linux), tr_buyuk() onu LİNUX yapar. Çok dilli içerikte dönüşümün dile göre seçilmesi gerekir.
PHP 8.4: mb_ucfirst(), mb_lcfirst() ve mb_trim()
PHP 8.4 mbstring'e beş yeni fonksiyon ekledi: mb_ucfirst(), mb_lcfirst(), mb_trim(), mb_ltrim() ve mb_rtrim(). mb_ucfirst(), ucfirst()'ün çok baytlı karşılığıdır ve ilk karakteri başlık harfine çevirir. ılgaz kelimesini doğru biçimde Ilgaz yapar; ancak Unicode varsayılanlarını kullandığı için izmir kelimesini Izmir yapar. Türkçe için yukarıdaki tr_ilk_buyuk() yardımcısı hâlâ gereklidir.
trim() varsayılan olarak yalnızca birkaç ASCII boşluk karakterini (boşluk, sekme, satır başı, satır sonu, NUL ve dikey sekme) temizler. Word belgelerinden veya web sayfalarından kopyalanan metinlerde sık görülen bölünemez boşluk (U+00A0) ya da Japonca metinlerdeki ideografik boşluk (U+3000) bu listede yoktur. mb_trim() varsayılan olarak bu Unicode boşluklarının uzun bir listesini temizler; ikinci parametreyle kendi karakter listenizi verebilirsiniz. Bu fonksiyonlar PHP 8.4 veya üstünü gerektirir.
<?php
$girdi = "\u{00A0} Merhaba \u{3000}";

$t = trim($girdi);
var_dump(str_starts_with($t, "\u{00A0}"));    // çıktı: bool(true)  (bölünemez boşluk kaldı)
var_dump(mb_trim($girdi));                    // çıktı: string(7) "Merhaba"

echo mb_ucfirst('ılgaz'), ' ', mb_ucfirst('izmir'), "\n"; // çıktı: Ilgaz Izmir
echo mb_lcfirst('IŞIK'), "\n";                            // çıktı: iŞIK
Metni karakterlere bölmek ve doldurmak
str_split() metni bayt bayt böler; Türkçe harfler iki parçaya ayrılır. mb_str_split() ise karakter karakter böler, ikinci parametreyle her parçanın kaç karakter olacağını belirleyebilirsiniz. Bir metni tersine çevirmek için kullanılan strrev() da bayt düzeyinde çalıştığı için Türkçe metni bozar; karakterlere bölüp diziyi ters çevirmek doğru sonucu verir.
Sabit genişlikli tablo veya fiş çıktısı hazırlarken kullanılan str_pad() uzunluğu bayt olarak hesaplar. Türkçe harf içeren bir kelime bu yüzden eksik doldurulur ve sütunlar kayar. PHP 8.3 ile gelen mb_str_pad() uzunluğu Unicode kod noktası olarak hesaplar ve sütunları hizalı tutar. Aynı sorun printf() genişlik belirticilerinde de vardır; ayrıntısı sprintf ve number_format yazısında.
<?php
echo json_encode(mb_str_split('Ağaç'), JSON_UNESCAPED_UNICODE), "\n";    // çıktı: ["A","ğ","a","ç"]
echo json_encode(mb_str_split('Ağaçlar', 3), JSON_UNESCAPED_UNICODE), "\n"; // çıktı: ["Ağa","çla","r"]
echo count(str_split('Ağaç')), "\n";                                       // çıktı: 6  (bayt parçası)

echo implode('', array_reverse(mb_str_split('Ağaç'))), "\n";              // çıktı: çağA

echo str_pad('Şişli', 8, '.'), "|\n";      // çıktı: Şişli.|
echo mb_str_pad('Şişli', 8, '.'), "|\n";   // çıktı: Şişli...|
Hangi fonksiyonun mb_ karşılığını kullanmalıyım?
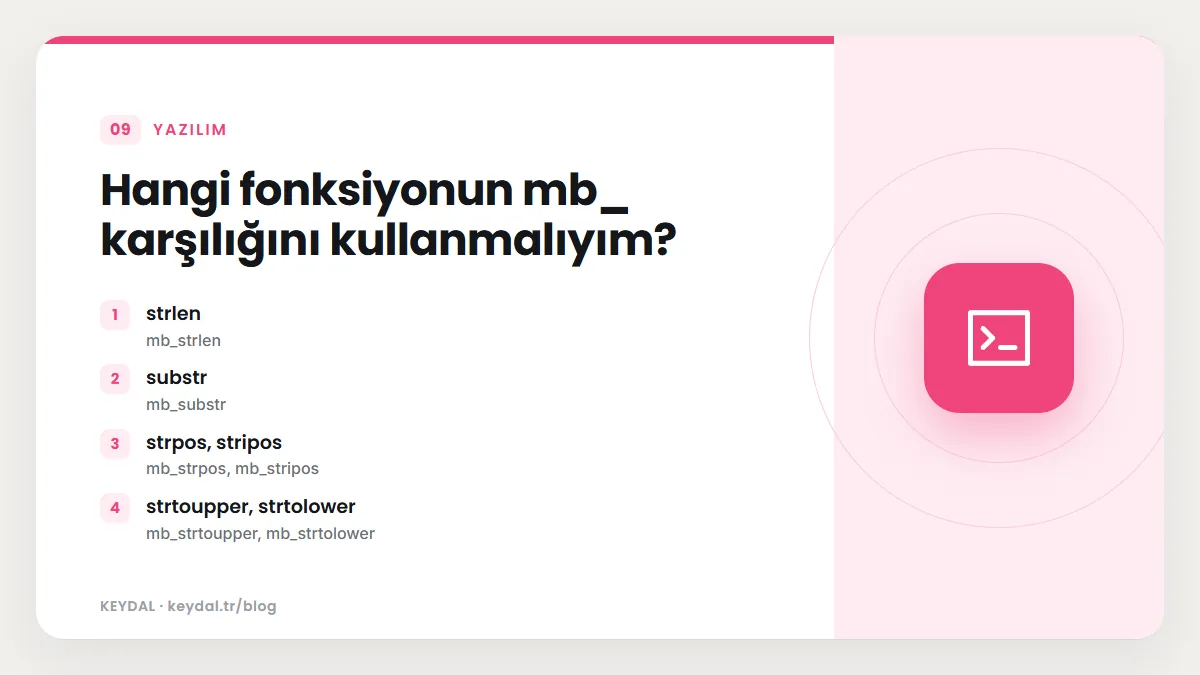
Her metin fonksiyonunun çok baytlı sürümüne ihtiyacınız yoktur. Konum ve uzunlukla ilgilenmeyen, yalnızca "bu metin içinde var mı" veya "şununla değiştir" diye soran işlemler UTF-8'de bayt düzeyinde de doğru çalışır: str_contains(), str_starts_with(), str_replace(), explode() ve implode() buna örnektir. Uzunluk, konum, kesme, büyük/küçük harf ve hizalama söz konusu olduğunda ise mb_ karşılığı şarttır.
| Bayt tabanlı | Karakter tabanlı | Not |
|---|---|---|
| strlen | mb_strlen | grapheme_strlen görünen karakteri sayar |
| substr | mb_substr | konum ve uzunluk karakter cinsinden |
| strpos, stripos | mb_strpos, mb_stripos | dönen konumlar farklıdır |
| strtoupper, strtolower | mb_strtoupper, mb_strtolower | Türkçe i/I için ön dönüşüm gerekir |
| ucfirst, lcfirst | mb_ucfirst, mb_lcfirst | PHP 8.4 ve üstü |
| trim, ltrim, rtrim | mb_trim, mb_ltrim, mb_rtrim | PHP 8.4 ve üstü, Unicode boşluklar |
| str_pad | mb_str_pad | PHP 8.3 ve üstü |
| str_split | mb_str_split | PHP 7.4 ve üstü |
| strrev | yok | mb_str_split ve array_reverse ile |
Sık yapılan hatalar
- Karakter sınırını
strlen()ile kontrol etmek: 20 karakterlik bir kullanıcı adı sınırı Türkçe harflerle 10 karaktere kadar düşebilir.mb_strlen()kullanın. - Önizleme metnini
substr()ile kesmek: son harf yarım kalır ve çıktı geçersiz UTF-8 olur.mb_substr()veyamb_strimwidth()kullanın. mb_strtoupper()'ın Türkçeyi bildiğini varsaymak: i ve ı harfleri için ön dönüşüm yapmanız gerekir.mb_strtolower()sonucunu doğrudan karşılaştırmak:İharfi iki kod noktasına dönüşür, eşitlik testleri başarısız olur.strpos()konumunumb_substr()'a vermek: biri bayt, diğeri karakter konumudur. Aynı ailedeki fonksiyonları birlikte kullanın.- Gelen metnin kodlamasını kontrol etmemek: dışarıdan gelen veriyi işlemeden önce
mb_check_encoding()ile doğrulayın; düzenli ifadelerdekiubayrağı da geçersiz UTF-8 ile eşleşme yapmaz. Ayrıntılar PHP preg_match ve düzenli ifadeler yazısında.
Sık Sorulan Sorular
mbstring eklentisi her sunucuda yüklü mü?
Kılavuza göre mbstring varsayılan olarak etkin olmayan bir eklentidir; PHP kaynak koddan derlenirken açıkça etkinleştirilmesi gerekir. Hazır paketlerde ve barındırma ortamlarında sık bulunsa da her sunucuda olacağı garanti değildir. Kodunuzun başında extension_loaded('mbstring') ile kontrol edebilir veya php -m komutuyla yüklü eklentileri listeleyebilirsiniz. Eklenti yönetimi ve sürüm seçimi için PHP hosting rehberi yazısına bakabilirsiniz.
Kullanıcı adlarını büyük/küçük harf farkı gözetmeden nasıl tekil tutarım?
Kaydederken adın Türkçe kurallarla küçültülmüş bir kopyasını ayrı bir alanda saklayın ve tekillik kontrolünü bu alan üzerinden yapın. Küçültme için yukarıdaki tr_kucuk() gibi tek bir fonksiyon kullanın ve kayıt, giriş ve arama ekranlarının hepsinde aynı fonksiyonu çağırın. Farklı yerlerde farklı dönüşüm kullanmak, aynı kişinin iki ayrı hesap açabilmesine yol açar. Başındaki ve sonundaki görünmez boşlukları da mb_trim() ile temizlemeyi unutmayın.
mb_ fonksiyonlarına her seferinde UTF-8 yazmam gerekir mi?
İç kodlama UTF-8 ise gerekmez; parametre verilmediğinde fonksiyonlar iç kodlamayı kullanır. Kütüphane yazıyorsanız veya kodunuzun hangi ayarlarla çalışacağını bilmiyorsanız 'UTF-8' parametresini açıkça vermek, davranışı ortamdan bağımsız kılar.
Türkçe sıralama için de mbstring yeterli mi?
Hayır. mbstring karşılaştırma için alfabe kuralı sunmaz; sort() bayt sırasına göre çalışır. Türkçe alfabe sırası için intl eklentisindeki Collator sınıfı gerekir; kullanımı PHP dizi sıralama yazısında.
Veritabanına Türkçe karakter kaydederken nelere dikkat etmeliyim?
PHP tarafında metnin geçerli UTF-8 olduğundan emin olun ve kesme işlemlerini mb_substr() ile yapın. Veritabanı bağlantısının ve tabloların karakter kümesi de UTF-8 olmalıdır; PDO ile bağlantı kurmayı PHP PDO veritabanı bağlantısı yazısında anlattık.
HTML çıktısında Türkçe karakterler bozuk görünüyorsa sebep ne olabilir?
Genellikle sayfanın UTF-8 olarak bildirilmemesi ya da metnin bir yerde bayt düzeyinde kesilmesidir. Çıktıyı htmlspecialchars() ile kaçırırken kodlama parametresi varsayılan olarak default_charset değerini kullanır. HTML özel karakterleri için HTML entity nedir yazısına bakabilirsiniz.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: PHP öğrenme rehberi · PHP string fonksiyonları · sprintf ve number_format · PHP preg_match ve regex · PHP dizi sıralama