MongoDB'de E11000 duplicate key error, bir ekleme veya güncelleme işleminin benzersiz (unique) bir indeksin zaten var olan bir değerini ikinci kez yazmaya çalıştığı anlamına gelir. Hata kodu 11000, kod adı DuplicateKey'dir. Çözüm için önce mesajdaki indeks adına ve dup key değerine bakarsınız; sonra sorunun aynı _id'nin tekrar kullanılması mı, eksik alanların null sayılması mı, eşzamanlı bir upsert yarışı mı yoksa mevcut verideki eski bir tekrar mı olduğunu belirleyip ona göre düzeltirsiniz.
Bu yazıda hata mesajının nasıl okunacağını, hatanın en sık sekiz nedenini, tekrarlanan belgeleri bulmak için kullanılabilecek sorguları ve kalıcı çözümleri örneklerle anlatıyoruz. Unique indeksin kendisini ayrıntılı öğrenmek isterseniz unique, partial ve sparse index yazısına, serinin tamamı için MongoDB öğrenme rehberine bakabilirsiniz.
Hata Mesajını Okumak
Belgelerdeki örneklerde mesaj şu biçimde gelir: E11000 duplicate key error collection: test.pizzas index: _id_ dup key: { _id: 4 }. Mesaj üç parça bilgi taşır:
- collection: Hatanın oluştuğu ad alanı, yani
veritabani.koleksiyon. - index: Kuralı çiğnenen indeksin adı.
_id_her koleksiyonda otomatik bulunan_idindeksidir;email_1gibi bir ad,emailalanı üzerinde sizin oluşturduğunuz bir indeksi gösterir. Belgelerdeki bir örnekte olduğu gibi indeksin özel bir adı da olabilir. - dup key: Çakışan anahtar değeri. Bileşik indekste tüm alanların değerleri birlikte görünür, örneğin
{ accounts.bank: null, accounts.number: null }. Değerlerinnullolması, belgede o alanların hiç bulunmadığına işaret eder.
mongosh içinde tek bir ekleme hatası MongoServerError ya da WriteError olarak görünür ve code: 11000 alanını taşır. insertMany ve bulkWrite gibi toplu işlemlerde ise BulkWriteError döner: hatalar writeErrors dizisinde, her biri işlemin sırasını gösteren index ve hatalı belgeyi gösteren op alanıyla listelenir; başarılı işlemlerin sayısı nInserted gibi alanlarda verilir. Write concern hataları ise ayrı bir writeConcernErrors alanında durur ve duplicate key ile karıştırılmamalıdır.
Hangi indeksin söz konusu olduğunu tam görmek için indeks listesini alın. Çıktıdaki name alanı hata mesajındaki indeks adıyla eşleşir; unique: true seçeneği olan indeksler benzersizlik kuralı koyanlardır:
db.kullanicilar.getIndexes()Neden 1: Aynı _id ile İkinci Ekleme
Her koleksiyon oluşturulurken MongoDB _id alanı üzerinde benzersiz bir indeks oluşturur. _id değerini uygulamanız veriyorsa ve aynı değeri ikinci kez gönderirse ekleme reddedilir. Tipik senaryolar; içe aktarma betiğinin iki kez çalışması, ağ hatasından sonra körü körüne yeniden deneme veya ardışık numaraların elle üretilmesidir.
db.urunler.insertOne({ _id: 101, ad: "Klavye" })
db.urunler.insertOne({ _id: 101, ad: "Mouse" })  // E11000: index _id_
Kendi _id değerinizi üretmek zorunda değilseniz alanı hiç göndermeyin; MongoDB her belge için otomatik bir ObjectId üretir. Değer gerçekten bir iş anahtarıysa (ürün kodu gibi) ve aynı kayıt tekrar gelebiliyorsa ekleme yerine upsert kullanmayı düşünün; aşağıdaki uyarıları okuyarak. Ekleme ayrıntıları için insertOne ve insertMany yazısına bakın.
Neden 2: Unique İndeksli Bir Alanda Tekrar
En yaygın durum budur: email veya kullaniciAdi gibi bir alana unique indeks koymuşsunuzdur ve aynı değerle ikinci bir kayıt gelir. Bu durumda hata tam istediğiniz şeydir; veritabanı iş kuralınızı uyguluyor demektir. Yapılacak şey hatayı uygulamada yakalayıp kullanıcıya anlamlı bir mesaj göstermektir.
db.kullanicilar.createIndex({ email: 1 }, { unique: true })

try {
  db.kullanicilar.insertOne({ email: "ali@ornek.com", ad: "Ali" })
} catch (e) {
  if (e.code === 11000) {
    print("Bu e-posta adresi zaten kayıtlı")
  } else {
    throw e
  }
}
Uygulamada önce "bu e-posta var mı" diye sorgulayıp sonra eklemek yarışa açıktır: iki istek aynı anda kontrolü geçebilir. Doğru yaklaşım unique indekse güvenmek ve 11000 kodunu yakalamaktır.
Neden 3: Eksik Alanlar null Sayılır
Bu neden çoğu geliştiriciyi şaşırtır. Belgelere göre tek alanlı bir unique indekste, indekslenen alan belgede yoksa veya null ise indeks o belge için null değerini saklar. Benzersizlik kuralı nedeniyle bu indekste null girişli yalnızca bir belge olabilir. Yani telefon alanına unique indeks koyup telefonu olmayan iki kullanıcı eklemeye çalışırsanız ikincisi E11000 verir.
db.kullanicilar.createIndex({ telefon: 1 }, { unique: true })
db.kullanicilar.insertOne({ ad: "Ayşe" })   // telefon yok: indekse null yazılır
db.kullanicilar.insertOne({ ad: "Mehmet" }) // E11000: ikinci null
Bileşik unique indekslerde de aynı mantık geçerlidir. Belgelerdeki bir örnekte accounts.bank ve accounts.number üzerinde bileşik unique indeks vardır; hesap bilgisi olmayan iki kullanıcı eklendiğinde ikincisi dup key: { accounts.bank: null, accounts.number: null } ile reddedilir. Bu durumun iki temiz çözümü vardır.
Çözüm A: Partial unique index
partialFilterExpression ile indeksi yalnızca alanı gerçekten olan belgelere uygularsınız. Belgelere göre unique kısıtı yalnızca filtreye uyan belgeler için geçerlidir; filtreye uymayan belgeler bu kurala takılmaz.
db.kullanicilar.createIndex(
  { telefon: 1 },
  { unique: true, partialFilterExpression: { telefon: { $exists: true } } }
)
Çözüm B: Sparse unique index
Hem sparse hem unique olan bir indeks, belgelere göre alanda tekrar eden değerleri engeller ama alanı hiç içermeyen birden fazla belgeye izin verir. Partial indeks daha esnek bir filtre sunduğu için çoğu durumda tercih edilir; iki seçeneğin farkları için unique, partial ve sparse index yazısına bakın.
db.kullanicilar.createIndex({ telefon: 1 }, { unique: true, sparse: true })Neden 4: Eşzamanlı upsert Yarışı
upsert: true ile yapılan bir güncelleme, eşleşen belge yoksa yeni bir belge ekler. Belgelere göre unique indeks yoksa, aynı anda çalışan birkaç upsert sorgu aşamasını aynı anda bitirip her biri ayrı bir belge ekleyebilir; yani tekrar eden kayıtlar oluşur. Unique indeks varsa yalnızca bir işlem ekleme yapar, diğerleri ya yeni eklenen belgeyi günceller ya da benzersizlik çakışmasıyla başarısız olur.
Diğer işlemlerin hata yerine güncellemeye dönmesi için belgelerdeki koşulların hepsinin sağlanması gerekir: koleksiyonda çakışmaya neden olacak bir unique indeks olmalı; işlem updateMany veya multi: true olmamalı; eşleşme koşulu tek bir eşitlik ya da eşitliklerin VE bağlacıyla birleşimi olmalı; bu eşitlikteki alanlar unique indeksin alanlarıyla birebir aynı olmalı ve güncelleme indeks alanlarını değiştirmemeli.
| Unique indeks | upsert filtresi ve güncelleme | Çakışmada sonuç |
|---|---|---|
| { kod: 1 } | filtre { kod: "A1" }, $inc ile sayaç artırma | Yeni eklenen belge güncellenir |
| { kod: 1 } | filtre { kod: { $ne: "B2" } }, $set ile kod yazma | Hata: güncelleme indeks alanını değiştiriyor |
| { kod: 1 } | filtre { kod: "A1", depo: "ist" } | Hata: filtre alanları indeks alanlarıyla aynı değil |
db.stok.createIndex({ kod: 1 }, { unique: true })

// Aynı anda birden çok istemci çalıştırsa da tek belge oluşur
db.stok.updateOne(
  { kod: "A1" },
  { $inc: { adet: 1 } },
  { upsert: true }
)
Belgelere göre MongoDB 8.1'den itibaren çok belgeli bir transaction içinde çalışan upsert, duplicate key hatasıyla karşılaştığında yeniden denenmez. Transaction içinde upsert kullanıyorsanız 11000 hatasını uygulamada ele almanız gerekir; bkz. transaction kullanımı. Güncelleme operatörleri için updateOne ve updateMany yazısına bakın.
Neden 5: Toplu Eklemede Tekrar Eden Belgeler
insertMany varsayılan olarak sıralı (ordered: true) çalışır. Belgelere göre sıralı modda bir ekleme başarısız olursa sunucu kalan kayıtları eklemeye devam etmez; hatadan önceki eklemeler ise yapılmış olarak kalır. ordered: false verirseniz sunucu hatalı belgeyi atlayıp diğerlerini eklemeye devam eder ve tüm hataları bir dizi olarak döndürür; bu modda eklemelerin sırası değişebilir.
db.urunler.insertMany(
  [
    { _id: 1, ad: "Kalem" },
    { _id: 1, ad: "Silgi" },
    { _id: 2, ad: "Defter" }
  ],
  { ordered: false }
)
// ordered: false: _id 1 olan belgelerden biri ve _id 2 eklenir,
// çakışan belge hata nesnesinin writeErrors dizisinde raporlanır
Veri aktarımında tekrar eden kayıtları atlamak istiyorsanız ordered: false kullanmak ve hata nesnesindeki writeErrors listesini kaydetmek pratik bir yoldur. Aynı davranış bulkWrite için de geçerlidir; bkz. bulkWrite ve toplu işlemler. Dosyadan içe aktarma araçları için mongoexport ve mongoimport yazısına bakabilirsiniz.
Neden 6: Tekrarlı Veri Varken Unique İndeks Oluşturmak
Belgelere göre koleksiyonda indeksin kuralını çiğneyen veri zaten varsa MongoDB unique indeksi oluşturamaz ve indeks oluşturma duplicate key hatasıyla başarısız olur. Önce tekrarları bulmanız gerekir. Bunun için alan değerine göre gruplayıp birden fazla belgesi olan grupları listeleyen bir aggregation yeterlidir:
db.kullanicilar.aggregate([
  { $group: { _id: "$email", adet: { $sum: 1 }, idler: { $push: "$_id" } } },
  { $match: { adet: { $gt: 1 } } },
  { $sort: { adet: -1 } }
])
Bu sorgu her tekrar eden e-posta için kaç belge olduğunu ve o belgelerin _id listesini döndürür. Eksik alanlar da tek bir null grubunda toplanır; bu grup, yukarıda anlatılan null sorununu görmenin de kolay bir yoludur. Gruplama hakkında ayrıntı için $group ve accumulator yazısına bakın. Hangi kaydın kalacağına karar verip diğerlerini birleştirdikten veya sildikten sonra indeksi oluşturabilirsiniz; silme işlemleri için deleteOne ve deleteMany yazısı yardımcı olur.
Var olan indeksi unique'e dönüştürmek
Alanda zaten normal bir indeks varsa onu silmeden collMod ile unique'e dönüştürebilirsiniz. Belgelerdeki prosedür üç aşamalıdır. Önce indekste prepareUnique: true ayarlanır; bu ayardan sonra tekrar oluşturacak yeni eklemeler zaten E11000 ile reddedilir. Sonra unique: true ve dryRun: true ile çakışan belgelerin listesi alınır. Çakışmalar giderildikten sonra komut dryRun olmadan çalıştırılır.
db.runCommand({ collMod: "kullanicilar", index: { keyPattern: { email: 1 }, prepareUnique: true } })

db.runCommand({
  collMod: "kullanicilar",
  index: { keyPattern: { email: 1 }, unique: true },
  dryRun: true
})

// çakışmalar giderildikten sonra:
db.runCommand({ collMod: "kullanicilar", index: { keyPattern: { email: 1 }, unique: true } })
Belgeler bazı kurallar da koyar: prepareUnique ayrı bir collMod komutunda ve tek başına verilmelidir; prepareUnique ayarlanmadan unique: true hata döndürür; time series koleksiyonlarındaki indekslerde prepareUnique kullanılamaz. Sharded koleksiyonda herhangi bir shard'da tekrar varsa komut CannotConvertIndexToUnique döndürür ve hiçbir shard'da dönüşüm yapılmaz. Koleksiyon yapısını değiştiren collMod komutlarından önce yedek almanızı öneririz.
Neden 7: Sharded Kümelerde Benzersizlik
Sharded bir kümede unique kısıt, shard'lar arasında yalnızca indeks shard key üzerindeyse ya da shard key'i ön ek olarak içeriyorsa uygulanır. Hashed indekslerde unique kısıtı hiç tanımlanamaz; bunun yerine ayrı, hash olmayan bir unique indeks oluşturulabilir. Shard key'e dahil olmayan bir alanda küme genelinde benzersizlik istiyorsanız belgeler ayrı bir yardımcı koleksiyon kullanan yöntemler anlatır. Bu konunun ayrıntıları için sharding ve shard key yazısına bakın.
Neden 8: Yeniden Deneme ve Zaman Aşımı Sonrası Tekrar
Bir yazma işleminin write concern zaman aşımıyla (wtimeout) dönmesi yazmanın geri alındığı anlamına gelmez; değişiklik primary'de kalır. Uygulamanız bu hatayı başarısızlık sayıp aynı belgeyi aynı _id ile yeniden eklerse E11000 alırsınız. Bu durumda hata aslında ilk yazmanın gerçekleştiğini gösteren bir işarettir. Zaman aşımı davranışının ayrıntıları için write concern ve read concern yazısına bakın.
Hızlı Teşhis Tablosu
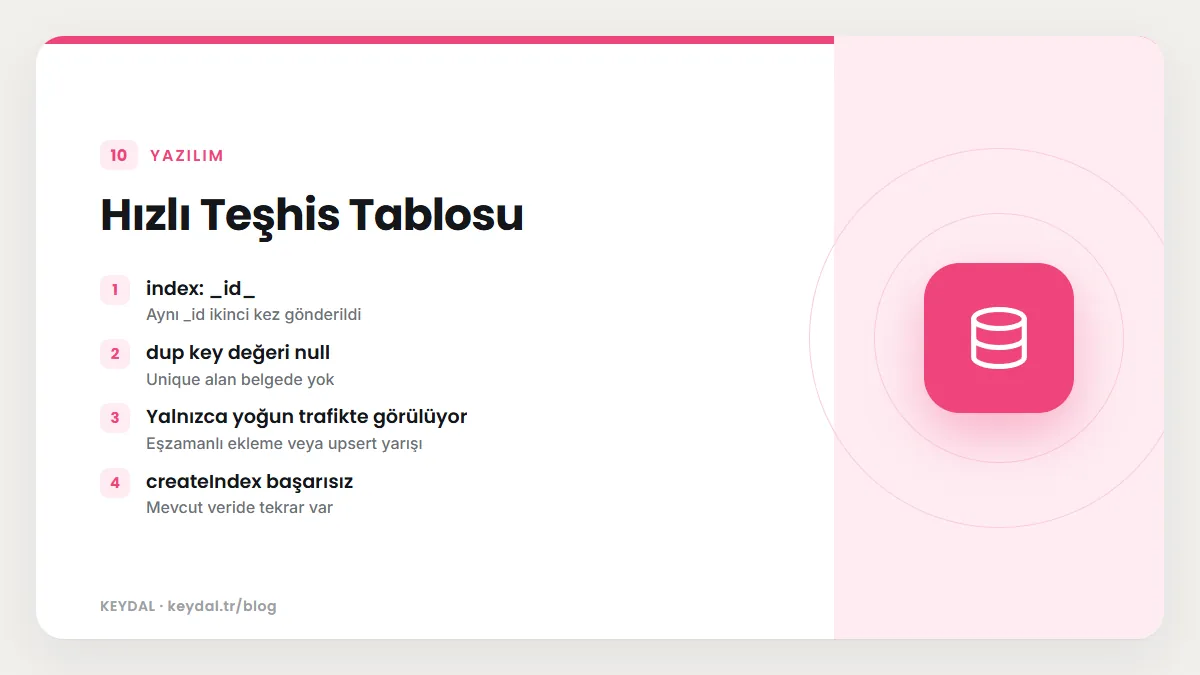
| Belirti | Muhtemel neden | Çözüm |
|---|---|---|
| index: _id_ | Aynı _id ikinci kez gönderildi | _id üretimini MongoDB'ye bırakın veya upsert kullanın |
| dup key değeri null | Unique alan belgede yok | Partial veya sparse unique indeks |
| Yalnızca yoğun trafikte görülüyor | Eşzamanlı ekleme veya upsert yarışı | Unique indekse güvenin, 11000 kodunu yakalayın |
| createIndex başarısız | Mevcut veride tekrar var | $group ile bulun, temizleyin, sonra indeks |
| insertMany yarıda kaldı | ordered: true ve bir tekrar | ordered: false ve writeErrors kaydı |
| wtimeout sonrası tekrar denemede | İlk yazma zaten yapılmış | Tekrar denemeyi idempotent tasarlayın |
Sık Yapılan Hatalar
- Hatayı susturmak için unique indeksi kaldırmak. Bu, veri bütünlüğünü uygulamaya bırakır ve tekrarlar çoğalır.
- Ekleme öncesi "var mı" kontrolüne güvenmek; eşzamanlı isteklerde iki kontrol de geçebilir.
- Opsiyonel bir alana düz unique indeks koyup eksik alanların null sayılacağını unutmak.
- Her hatayı aynı şekilde ele almak;
e.code === 11000kontrolü yapmadan tüm istisnaları "kayıt zaten var" diye yorumlamak. - Bileşik unique indeksin tek tek alanları değil, alanların birleşimini benzersiz kıldığını gözden kaçırmak.
Sık Sorulan Sorular
E11000 hatası verinin bozulduğu anlamına mı gelir?
Hayır. Bu bir doğrulama hatasıdır: işlem reddedilmiş ve veri değişmemiştir. Toplu işlemlerde ise yalnızca hatalı işlem yapılmaz; sıralı modda hatadan önceki işlemler yapılmış olarak kalır.
Bileşik unique indekste tek bir alan tekrar edebilir mi?
Evet. Bileşik unique indeks, belgelere göre indeks anahtar değerlerinin birleşiminin en fazla bir kez geçmesini sağlar. { magaza: 1, kod: 1 } unique ise aynı kod farklı mağazalarda kullanılabilir.
Aynı belgedeki bir dizide tekrar eden değerler hata verir mi?
Belgelere göre unique kısıt ayrı belgeler arasında uygulanır. Unique multikey bir indekste, bir belgenin dizi elemanları kendi içinde tekrar edebilir; yeter ki aynı anahtar değeri başka bir belgede bulunmasın.
Hatanın hangi belgeyle çakıştığını nasıl bulurum?
Mesajdaki dup key değerini filtre olarak kullanın, örneğin db.kullanicilar.find({ email: "ali@ornek.com" }). Sorgu yazımı için find sorguları yazısına bakabilirsiniz.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: MongoDB öğrenme rehberi · Unique, partial ve sparse index · Index oluşturma · insertOne ve insertMany · updateOne ve upsert · bulkWrite