mapfile, standart girdiden veya bir dosya tanımlayıcısından okuduğu satırları tek komutla indeksli bir diziye yerleştiren Bash yerleşik komutudur; readarray onun eş anlamlısıdır. Bir dosyanın bütün satırlarını diziye almak için mapfile -t satirlar < dosya.txt yazarsınız. -t her satırın sonundaki yeni satır karakterini atar, -n en fazla kaç satır okunacağını, -s baştan kaç satırın atlanacağını, -d satır ayırıcısını belirler. Dizi adı vermezseniz satırlar MAPFILE adlı diziye yazılır.
Bu yazıda mapfile seçeneklerinin hepsini çalışan örneklerle gösteriyor, bir komutun çıktısını neden komut | mapfile ile değil mapfile < <(komut) ile okumanız gerektiğini açıklıyor ve while read döngüsüyle karşılaştırıyoruz. Dizilerin temelleri için Bash dizi yazısına, serinin tamamı için Bash öğrenme rehberine bakabilirsiniz.
mapfile ne işe yarar?
Bir dosyayı satır satır işlemek kabuk betiklerinin en temel işlerinden biridir. Bunun klasik yolu while read döngüsüdür ve satırları teker teker işlemek için hâlâ en uygun araçtır. Ancak bazen satırların hepsine aynı anda ihtiyaç duyarsınız: satır sayısını bilmek, belirli bir satıra indisle ulaşmak, listeyi ters sırada dolaşmak ya da satırları bir komuta argüman olarak vermek gibi. mapfile bu durumda döngü yazmadan bütün satırları bir diziye alır.
Kılavuzdaki imzası şöyledir: mapfile [-d ayırıcı] [-n sayı] [-O başlangıç] [-s sayı] [-t] [-u fd] [-C geri_çağrı] [-c miktar] [dizi]. readarray tamamen aynı seçenekleri alır. Komut, seçenekler geçersiz değilse, dizi atanabilir durumdaysa ve gerçekten indeksli bir diziyse sıfır durum koduyla döner.
Temel kullanım ve -t seçeneğinin önemi
-t olmadan mapfile her satırı sonundaki yeni satır karakteriyle birlikte saklar. Bu nadiren istenen bir şeydir: elemanı ekrana yazdırdığınızda fazladan boş satırlar oluşur, karşılaştırmalar beklenmedik biçimde başarısız olur. Pratikte mapfile neredeyse her zaman -t ile kullanılır. Aşağıdaki örnekte declare -p farkı açıkça gösteriyor: $'bir\n' yazımı değerin sonunda bir yeni satır olduğu anlamına gelir.
printf 'bir\niki\n\ndört' > satirlar.txt   # son satırda yeni satır yok

mapfile ham < satirlar.txt
declare -p ham
# çıktı: declare -a ham=([0]=$'bir\n' [1]=$'iki\n' [2]=$'\n' [3]="dört")

mapfile -t temiz < satirlar.txt
declare -p temiz
# çıktı: declare -a temiz=([0]="bir" [1]="iki" [2]="" [3]="dört")
echo "${#temiz[@]} satır, son satır: ${temiz[-1]}"
# çıktı: 4 satır, son satır: dört
Bu örnekten iki ayrıntı daha çıkıyor. Birincisi, boş satırlar dizide boş eleman olarak yer alır; atlanmazlar. İkincisi, dosyanın son satırı yeni satır karakteriyle bitmese bile okunur. while read döngüsünde son satırı kaçırmamak için ek bir kontrol gerekir, mapfile ise bu durumu kendiliğinden doğru işler.
Varsayılan dizi: MAPFILE
Dizi adı vermezseniz mapfile satırları MAPFILE adlı değişkene yazar. Kılavuz bu değişkeni Bash değişkenleri arasında, adsız mapfile çağrısının metni tuttuğu dizi olarak listeler. Kısa denemeler için pratiktir, ama betiklerde anlamlı bir ad vermek okunabilirliği artırır ve aynı betikte iki farklı okumanın birbirini ezmesini önler.
printf '%s\n' elma armut > meyve.txt
mapfile -t < meyve.txt
echo "${MAPFILE[1]}"
# çıktı: armut

# aynı ada (eşdeğer) readarray ile
readarray -t liste < meyve.txt
declare -p liste
# çıktı: declare -a liste=([0]="elma" [1]="armut")
Komut çıktısını okumak: neden pipe değil process substitution?
En sık yapılan hata, bir komutun çıktısını boru hattıyla mapfile'a vermektir: komut | mapfile -t dizi. Kılavuz, boru hattındaki her komutun ayrı bir alt kabukta çalıştığını belirtir. mapfile diziyi doldurur, ama bu dizi o alt kabukta kalır ve boru hattı bitince yok olur. Ana betik boş bir diziyle, hatta hiç tanımlanmamış bir değişkenle devam eder.
# YANLIŞ: mapfile bir alt kabukta çalışır
printf '%s\n' a b c | mapfile -t harf
echo "eleman sayısı: ${#harf[@]}"
# çıktı: eleman sayısı: 0

# DOĞRU: process substitution ile mapfile mevcut kabukta çalışır
mapfile -t harf < <(printf '%s\n' a b c)
echo "eleman sayısı: ${#harf[@]}"
# çıktı: eleman sayısı: 3
<(komut) yazımı process substitution'dır: komutun çıktısı bir dosya adı gibi kullanılabilen bir kanala bağlanır ve < yönlendirmesiyle mapfile'ın standart girdisine verilir. mapfile böylece ana kabukta çalışır ve dizi kalıcı olur. Bu yapının ayrıntıları process substitution yazısında, alt kabuk sorunu ise pipe ve lastpipe yazısında anlatılıyor. Kılavuzdaki lastpipe seçeneği, iş denetimi etkin değilken boru hattının son komutunu mevcut kabukta çalıştırarak da aynı sorunu çözebilir. Kılavuz iş denetimini etkileşimli kabukların varsayılan davranışları arasında sayar; etkileşimsiz çalışan betiklerde bu seçenek bu yüzden genellikle işe yarar.
Kısa ve tek satırlık bir metin için here string de kullanılabilir: mapfile -t dizi <<< "$metin". Burada dikkat edilmesi gereken nokta, here string'in metnin sonuna her zaman bir yeni satır eklemesidir; bu ayrıntı aşağıdaki -d örneğinde önem kazanıyor. Here string ve here document için here document yazısına bakın.
-n ve -s: satır sayısını sınırlamak ve satır atlamak
-n sayı en fazla o kadar satır kopyalar; 0 verilirse tüm satırlar okunur. -s sayı ise okunan ilk satırları atar. İkisini birlikte kullanarak bir dosyanın belirli bir aralığını alabilirsiniz. CSV dosyasındaki başlık satırını atlamak tipik bir kullanımdır.
printf '%s\n' "ad,puan" "Ali,80" "Ayşe,95" "Can,70" > puan.csv

mapfile -t -s 1 kayitlar < puan.csv          # başlığı atla
printf '%s\n' "${kayitlar[@]}"
# çıktı:
#   Ali,80
#   Ayşe,95
#   Can,70

mapfile -t -s 1 -n 2 ilk_iki < puan.csv     # başlıktan sonraki iki satır
declare -p ilk_iki
# çıktı: declare -a ilk_iki=([0]="Ali,80" [1]="Ayşe,95")
Satırları alanlara bölmek mapfile'ın işi değildir. Her satırı ayrıca IFS=, read -r ad puan ile bölebilirsiniz; bu yaklaşım read yazısında anlatılıyor.
-O: var olan dizinin üzerine eklemek
Kılavuza göre açık bir başlangıç indisi verilmezse mapfile diziyi yazmadan önce temizler. Yani aynı diziye ikinci kez okuma yaparsanız eski satırlar kaybolur. -O indis ile atamanın hangi indisten başlayacağını belirlersiniz ve bu durumda dizi temizlenmez. İki dosyayı tek bir diziye toplamak için ikinci okumada başlangıç olarak mevcut eleman sayısını verirsiniz.
printf '%s\n' a1 a2 > a.txt
printf '%s\n' b1 b2 > b.txt

mapfile -t hepsi < a.txt
mapfile -t -O "${#hepsi[@]}" hepsi < b.txt
declare -p hepsi
# çıktı: declare -a hepsi=([0]="a1" [1]="a2" [2]="b1" [3]="b2")

mapfile -t hepsi < a.txt            # -O yok: dizi önce temizlenir
declare -p hepsi
# çıktı: declare -a hepsi=([0]="a1" [1]="a2")
-O değerini mevcut eleman sayısı olarak vermek dizi ardışıksa doğru çalışır. Seyrek bir dizide eleman sayısı en büyük indisten küçük olabilir ve var olan elemanların üzerine yazılabilir; bu ayrıntı dizi yazısındaki seyrek dizi bölümünde anlatılıyor.
-d: satır ayırıcısını değiştirmek
-d seçeneği satırları yeni satır yerine verdiğiniz karakterin ilk harfinden böler. Boş metin verirseniz, yani -d '' yazarsanız, ayırıcı NUL karakteri olur. NUL bir dosya adının içinde bulunamayan tek karakter olduğu için, içinde yeni satır bile geçebilecek dosya adlarını güvenle taşımanın standart yoludur. NUL ile ayrılmış çıktı üreten araçlarla (örneğin find -print0) birlikte kullanılır.
# NUL ile ayrılmış girdi: elemanlar boşluk ve yeni satır içerebilir
mapfile -d '' -t adlar < <(printf '%s\0' "rapor 2024.txt" $'iki\nsatır.txt')
declare -p adlar
# çıktı: declare -a adlar=([0]="rapor 2024.txt" [1]=$'iki\nsatır.txt')

# virgülle ayırma: here string sona yeni satır ekler
mapfile -d , -t parca <<< "a,b,c"
declare -p parca
# çıktı: declare -a parca=([0]="a" [1]="b" [2]=$'c\n')

# son elemandaki yeni satırı temizle
yeni_satir=$'\n'
parca[-1]=${parca[-1]%"$yeni_satir"}
declare -p parca
# çıktı: declare -a parca=([0]="a" [1]="b" [2]="c")
İkinci örnek -d ile -t birlikteliğindeki tuzağı gösteriyor: -t yalnızca ayırıcıyı, burada virgülü siler. Here string'in eklediği yeni satır son elemanda kalır. Bunu önlemek için girdiyi yeni satırsız üretin, örneğin < <(printf '%s' "$metin") kullanın, ya da örnekteki gibi son elemandan yeni satırı desen silme genişletmesiyle temizleyin. Silinecek karakteri önce bir değişkene almamızın nedeni aşağıdaki CRLF bölümünde açıklanıyor.
-C ve -c: belirli aralıklarla geri çağrı çalıştırmak
-C her miktar satır okunduğunda çalıştırılacak bir komut veya fonksiyon belirler, -c bu miktarı ayarlar. Kılavuza göre -c verilmezse varsayılan miktar 5000 satırdır. Geri çağrı çalıştırılırken iki ek argüman alır: atanacak bir sonraki elemanın indisi ve o elemana atanacak satır. Çağrı satır okunduktan sonra ama dizi elemanı atanmadan önce yapılır. Uzun dosyaları okurken ilerleme göstermek için kullanılabilir.
ilerleme() { echo "indis $1 hazırlanıyor: $2"; }

mapfile -t -C ilerleme -c 2 sayilar < <(printf '%s\n' {1..5})
# çıktı:
#   indis 1 hazırlanıyor: 2
#   indis 3 hazırlanıyor: 4
echo "${#sayilar[@]} satır okundu"
# çıktı: 5 satır okundu
Çıktıda geri çağrının ikinci ve dördüncü satırlarda çalıştığını görüyorsunuz: her iki satırda bir çağrılıyor ve o anda atanacak satırın indisini (1 ve 3) ve içeriğini alıyor. Beşinci satırdan sonra yeni bir iki satırlık grup tamamlanmadığı için çağrı yapılmıyor. {1..5} yazımı süslü parantez genişletmesidir; brace expansion yazısında anlatılıyor.
-u: başka bir dosya tanımlayıcısından okumak
-u fd satırları standart girdi yerine belirtilen dosya tanımlayıcısından okur. Standart girdiyi kullanıcı girdisi gibi başka bir iş için boş bırakmanız gerektiğinde kullanışlıdır. Tanımlayıcıyı exec 3< dosya ile açıp işiniz bitince exec 3<&- ile kapatırsınız; bu teknik dosya tanımlayıcıları yazısında ayrıntılı anlatılıyor.
printf '%s\n' satır1 satır2 > kaynak.txt
exec 3< kaynak.txt
mapfile -t -u 3 veriler
exec 3<&-
declare -p veriler
# çıktı: declare -a veriler=([0]="satır1" [1]="satır2")
Windows satır sonları ve diğer tuzaklar
Windows ortamında hazırlanmış bir metin dosyası satırlarını \r\n ile bitirir. mapfile -t yalnızca \n karakterini sildiği için her elemanın sonunda görünmeyen bir \r kalır. Bu eleman bir dosya adı veya karşılaştırma değeri olarak kullanıldığında "dosya bulunamadı" ya da eşleşmeme hatalarına yol açar ve ekranda fark edilmesi zordur. declare -p bu durumu $'...\r' biçiminde açıkça gösterir.
printf 'web01\r\nweb02\r\n' > sunucular.txt
mapfile -t sunucular < sunucular.txt
declare -p sunucular
# çıktı: declare -a sunucular=([0]=$'web01\r' [1]=$'web02\r')

# her elemandan sondaki \r karakterini temizle
cr=$'\r'
sunucular=("${sunucular[@]%"$cr"}")
declare -p sunucular
# çıktı: declare -a sunucular=([0]="web01" [1]="web02")
Temizleme satırı, desen silme genişletmesinin dizinin her elemanına uygulanmasından yararlanıyor. \r karakterini önce cr değişkenine almamızın bir nedeni var: desenin içine doğrudan $'\r' yazdığımız "${sunucular[@]%$'\r'}" biçimini Bash 5.2.37 ile denediğimizde karakter silinmedi. Değişken kullanmak bu belirsizliği ortadan kaldırır ve satırı daha okunur yapar. Desen silme tekniği string işlemleri yazısında anlatılıyor. Aynı \r sorunu betiğin kendisinde olursa bad interpreter hatası alırsınız; bu hata sık hata mesajları yazısında ele alınıyor.
Bir diğer tuzak dizinin türüdür: mapfile yalnızca indeksli dizilere yazar. Aynı adla bir ilişkisel dizi tanımlıysa komut not an indexed array hatasıyla başarısız olur. Ayrıca girdi tamamen boşsa dizi boş olarak oluşturulur, eski elemanlar silinir.
mapfile mi, while read mi?
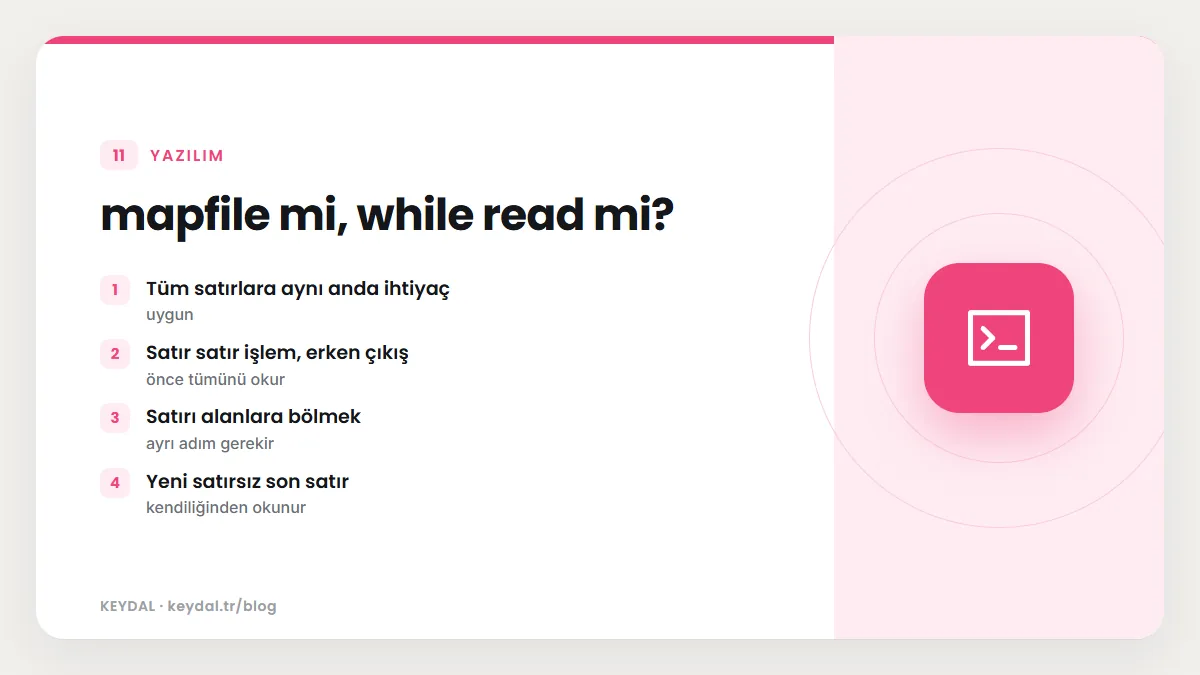
| Durum | mapfile | while read |
|---|---|---|
| Tüm satırlara aynı anda ihtiyaç | uygun | satırları elle diziye eklemek gerekir |
| Satır satır işlem, erken çıkış | önce tümünü okur | uygun, break ile durur |
| Satırı alanlara bölmek | ayrı adım gerekir | IFS ile read içinde yapılır |
| Yeni satırsız son satır | kendiliğinden okunur | ek kontrol gerekir |
| Ters bölü karakteri | satır olduğu gibi saklanır | read -r gerekir |
| Çok büyük dosya | hepsi belleğe alınır | satır satır akış |
while read döngüsü ve onun IFS= read -r kalıbı while ve until yazısında anlatılıyor. Satırları tek tek dönüştürecek, süzecek veya erken bitirecekseniz döngü daha doğaldır. Satırlar üzerinde indisle çalışacak, onları sayacak veya topluca bir komuta verecekseniz mapfile daha kısa ve daha az hataya açıktır.
Uygulama: bir listedeki her öğeyi işlemek
Aşağıdaki örnek bir dosyadan yedeklenecek klasör adlarını okuyor, boş satırları ve yorumları ayıklıyor, sonra her birini numarasıyla yazdırıyor. Gerçek bir betikte echo satırının yerine yedekleme komutunuz gelir.
printf '%s\n' '# yedek listesi' '/srv/web' '' '/srv/veri tabanı' > liste.txt

mapfile -t hamlar < liste.txt
hedefler=()
for satir in "${hamlar[@]}"; do
  [[ -z $satir || $satir == \#* ]] && continue
  hedefler+=("$satir")
done

for i in "${!hedefler[@]}"; do
  echo "$((i + 1)). ${hedefler[i]}"
done
# çıktı:
#   1. /srv/web
#   2. /srv/veri tabanı
Klasör adındaki boşluk korunuyor, çünkü her satır kendi elemanında duruyor ve dizi her yerde "${dizi[@]}" ile çift tırnak içinde genişletiliyor. Bu betiği düzenli aralıklarla çalıştırmak isterseniz cron rehberine bakabilirsiniz.
Sık yapılan hatalar
-tunutmak: her eleman sonunda yeni satır taşır.komut | mapfile: dizi alt kabukta kalır;mapfile -t dizi < <(komut)kullanın.- İkinci okumada eski satırları beklemek:
-Overilmezse dizi önce temizlenir. -dile here string: son elemanda here string'in eklediği yeni satır kalır.- CRLF dosyalar: elemanların sonunda
\rkalır; temizleyin veya dosyayı dönüştürün. - İlişkisel diziye okumaya çalışmak:
mapfileyalnızca indeksli dizilerle çalışır.
Sık Sorulan Sorular
mapfile ile readarray arasında fark var mı?
Hayır. Kılavuz readarray komutunu mapfile ile eş anlamlı olarak tanımlar; seçenekleri ve davranışı aynıdır.
mapfile boş satırları atlar mı?
Atlamaz. Her boş satır dizide boş bir eleman olur. Boş satırları ayıklamak için diziyi okuduktan sonra bir döngüyle süzebilirsiniz.
Dosyayı ters sırada yazdırmak için ne yapmalıyım?
Önce mapfile -t ile okuyun, sonra indisleri büyükten küçüğe dolaşın: for ((i=${#d[@]}-1; i>=0; i--)). Dizi ardışık olduğu için bu C tarzı döngü güvenle çalışır.
mapfile POSIX sh içinde çalışır mı?
Hayır, mapfile Bash'e özgü bir yerleşik komuttur. Betiğiniz sh ile çalıştırılıyorsa bu komut bulunmaz. Farklar için Bash ve sh farkı yazısına bakın.
Marka adları sahiplerine aittir. Bu yazı bağımsız bir teknik rehberdir; adı geçen kuruluşlarla bayilik veya ortaklık ilişkisi bulunduğu anlamına gelmez.
İlgili içerikler: Bash öğrenme rehberi · Bash dizileri · while read döngüsü · Process substitution · read komutu · Dosya tanımlayıcıları